AIに予約ページを作ってもらうと「完成しました」と言うのに、ボタンを押しても何も起きない。次の日には前日のことを忘れていて、同じミスを何度もくり返す。そんなとき、もっと賢いAIに替えるしかないのでしょうか。
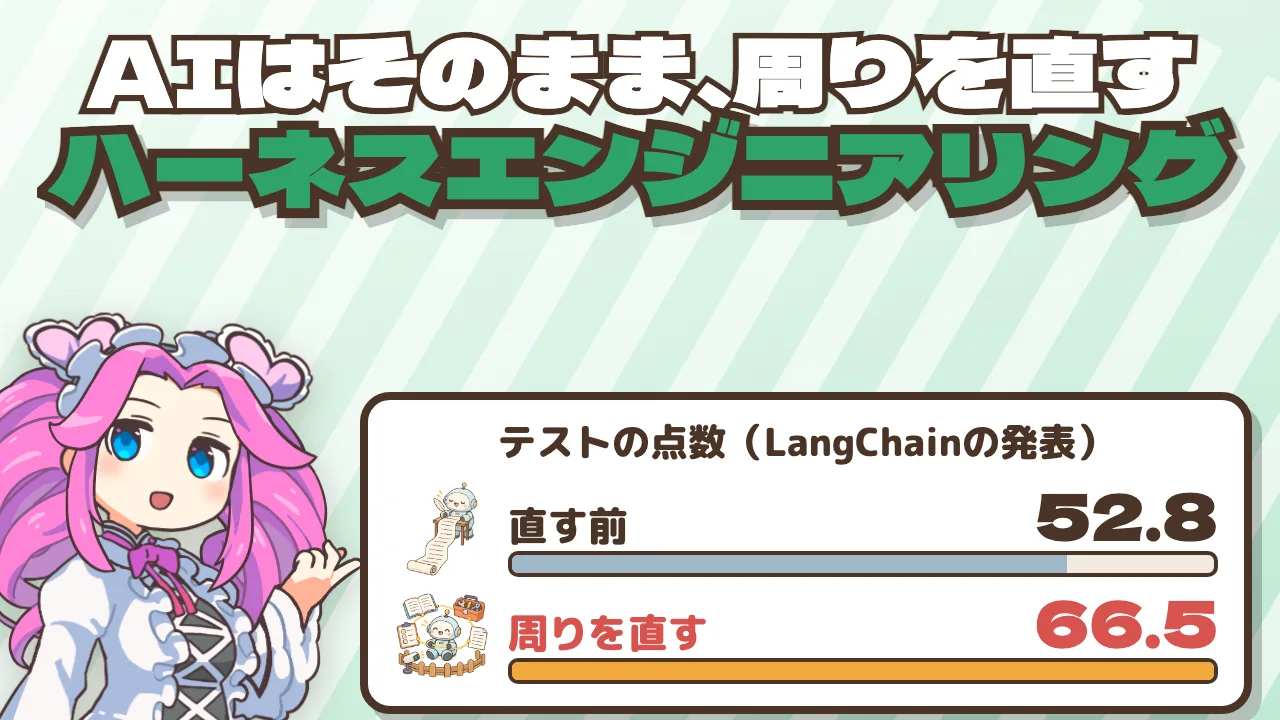
本記事では、AIを替える前に、AIの周りの仕組みを直す「ハーネスエンジニアリング」を解説します。ハーネスとは、もともと馬の力を仕事に向ける馬具のことで、AIではモデルが「脳」、ハーネスが「体と作業場」にあたります。LangChainは、モデルはそのままで周りだけを直し、テストの点数を52.8から66.5に上げたと発表しました(自社調べ)。お店の予約ページの例で、ルールの紙・引き継ぎメモ・確かめる道具と採点係という3つの直し方と、危ない操作を止める囲いを紹介し、2026年の動き、注意点、今日からできることまでまとめます。
情報は2026年10月8日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- ハーネスとは、AIのモデルの周りにある仕組みすべてのこと。
- AIがミスをしたら、叱るのではなく、二度と起きない仕組みにする。
- 確かめる道具・引き継ぎメモ・囲った作業場の3つから始める。
基礎知識:ハーネスエンジニアリングとは
AIエージェントに開発などの仕事を任せると、動作を確かめずに「完成しました」と終える、次の回では前日の経緯を忘れて同じミスをする、壊れたやり方を少しずつ変えて何度もくり返す、といった失敗がよく起こります。こうしたとき、モデル(頭脳)をより高価な新しいものに替えるのではなく、AIを取り巻く実行環境・ルール・確かめる道具・引き継ぎの仕組みを設計し直す取り組みが「ハーネスエンジニアリング」です。
ハーネス(馬具)が馬の力を暴走させずに荷車へ伝えるように、AIでは「モデル=脳」「ハーネス=体と作業場」にあたります。具体的には、毎回読ませる短いルールの目次(CLAUDE.mdやAGENTS.md)、回をまたいで進み具合と残りの課題を伝える引き継ぎメモ、画面の操作や自動テストで実際の動きを確かめる道具と別の採点係、そして危ない操作を防ぐ囲い(サンドボックス)とガードレールなどで構成されます。
LangChainは、中身のモデルを変えずにハーネスだけを改善することで、コーディングのテスト(Terminal Bench 2.0)の点数が52.8から66.5へ上がったと報告しています(同社の発表)。このため、モデルを替える前に見直す場所として注目されています。
AIが同じミスをくり返す
AIとのやりとり(イメージ)
お店のネット予約のページを、AIにコードを書いてもらって少しずつ作っているとします。「予約ボタンを付けて」と頼むと「付けました、完成です」と返ってきますが、押してみても何も起きません(イメージ)。
よくある3つの困りごと
現場でよくある課題
完成と言う
なのに動かない
忘れる
次の日には、まっさら
くり返す
言っても同じミス
ほかにも、次の日にはまっさらな状態から始まって前日のことを忘れている、何度言っても同じミスをくり返す、といった困りごとがあります。こうした問題に対して、AIを替える前に、AIの「周り」を直してみようというのが「ハーネスエンジニアリング」です。[s1][s7]
AIエージェントのよくある3つの失敗
AIの会社が書いている、よくある失敗
早すぎる完成
確かめずに完成にする(Anthropic)
毎回まっさら
新しい回は、記憶なしで始まる(Anthropic)
同じ失敗
ダメなやり方をくり返す(LangChain)
この3つの失敗は、AIの会社の技術ブログにもそのまま書かれています。1つ目は、きちんと確かめずに「完成」にしてしまうことで、自分のコードを読み返して「よさそう」で止まるのがいちばん多い失敗だそうです。[s2][s5]2つ目は、新しい回が前の記憶なしで始まることです。[s2]3つ目は、ダメなやり方を少しずつ変えては何度もくり返すことで、記録の中には10回以上くり返したものもありました。[s5]
周りだけ直して点数が上がった例
Terminal Bench 2.0 の点数(LangChain の発表)
LangChain の発表(2026年2月・自社調べ)
対策として、賢いAIに替えるのも1つの手です。しかし、中身のモデルはそのままで、周りだけを直して大きく伸びた例があります。LangChainは、AIにパソコンで開発の作業をさせる89問のテスト(Terminal Bench 2.0)で、モデルを変えずに周りだけを直したところ、点数が52.8から66.5に上がったと発表しました。89問なら12問ほど多く解けた計算で、順位は30位の圏外から5位以内に入りました。ただし、会社の発表で、自社調べの数字です。[s5]
ハーネスとは何か —— AIの「体と作業場」
いろいろな「ハーネス」
いろいろな「ハーネス」
馬具
力を仕事に向ける
犬の胴輪
飛び出しを防ぐ
安全帯
高い所で体を支える
ハーネスは、もともと馬に付ける馬具のことです。手綱や荷車につなぐベルトで、馬の力を荷物を運ぶ仕事に向けます。犬の胴輪や高い所で使う安全帯もハーネスと呼ばれ、いずれも力を役に立つ向きに使い、危ないほうには行かせない道具です。
AIエージェント=モデル+ハーネス
AIエージェント=モデル+ハーネス
Databricks の解説の8つの部品を、説明のため7つにまとめた
AIでいえば、馬にあたるのが、ChatGPTやClaudeの中で考える頭脳であるモデルです。ハーネスは、その周りにあるすべての仕組みを指します。Databricksの解説では、モデルが脳、ハーネスは体と作業場にたとえられています。[s6]具体的には、毎回読むルールの紙、ファイルやコマンドを扱う道具、本番とは別の作業場、前回の引き継ぎメモ、仕事を確かめる仕組み、危ない操作を止めるガードレール、そして何をしたかの記録です。[s6]
注目が外側へ広がってきた
注目が、外側へ広がってきた
頼み方の言葉
AIに何を見せるか
周りの仕組み全部
Databricks の解説をもとに整理
言葉の移り変わりで整理すると、はじめは頼み方の言葉(プロンプト)が注目され、次にAIに何を見せるか(コンテキスト)、そしていまは周りの仕組み全体(ハーネス)へと関心が広がってきました。頼み方も見せ方も、ハーネスの一部です。[s6]フックやMCPといった仕組みも、ハーネスの部品の1つと言えます。
ミスは叱らずに仕組みにする
AIがミスをしたら(ハーネスエンジニアリング)
この名前が広まったのは2026年2月ごろで、開発者のMitchell Hashimoto氏がブログでこう呼んだことがきっかけの1つです。考え方はシンプルで、AIがミスをしたら、二度と同じミスをしないように仕組みを作る、というものです。[s1][s7]
うまくいかないとき(OpenAI のブログより)
もっと頑張れ
とは、ほぼ言わなかった
何が足りない?
ルール・道具・確かめ方を足す
数日後に出たOpenAIのブログにも、同じ考え方が書かれています。うまくいかないとき、解決策が「もっと頑張れ」になることはほとんどなく、代わりに「何が足りないのか」を考えて、ルールや道具、確かめ方を足していったそうです。[s1]ここからは、お店の予約ページの例で、3つの直し方を見ていきます。
直し方① ルールの紙は短い目次にする
AIから見えない知識
AIから見えない知識(OpenAI のブログより)
頭の中
人だけが知っている
チャット
前の会話・別のスレッド
別の場所
作業の場所にない資料
まずは、送料を何度も間違える問題です。AIは、前の会話で言われたことを次の回には覚えていません。[s2]OpenAIは、人の頭の中やチャットの履歴、作業の場所にない資料など、AIから見えない知識はないのと同じだと指摘しています。[s1]
AIが毎回読むルールの紙(イメージ)
# 和菓子ECショップ 予約ページ
## 守ること
- 送料は全国一律 500円(税込)
- 値段は税込で表示する
- 予約のしめきりは前日の15時
## くわしい資料
- 商品と値段:docs/products.md
- 動かし方と確かめ方:docs/dev.md
そこで、AIが毎回最初に読むルールの紙を置きます。CodexではAGENTS.md、Claude CodeではCLAUDE.mdと呼ばれるファイルです。[s10][s11]何度も間違えた送料のような決まりは、1行ではっきり書いておきます。コツは、1行1行を、AIが実際にやったミスから作ることです。Hashimoto氏も、ミスのたびに1行足していったら、ほとんどの問題が直ったと書いています。[s7]
大きなルールの紙が失敗した理由
大きなルールの紙が失敗した理由(OpenAI)
埋もれる
大事な指示を見落とす
全部が大事
何も大事じゃなくなる
古くなる
古いルールの墓場に
ただし、何でも書き込んだ分厚いルールの紙は失敗するとOpenAIのチームは書いています。長いと大事な指示が埋もれ、すべてが大事だと何も大事ではなくなり、すぐに古くなって「古いルールの墓場」になるからです。[s1]おすすめは約100行の短い目次にして、くわしい話は別の資料に分けることです。[s1]Claude Codeの説明書も、200行より短くするよう勧めています。[s10]
機械のチェックに格上げする
$ pnpm check
エラー:送料が 500円 ではありません 場所:src/shipping.ts 12行目 直し方:送料は SHIPPING_FEE を使うそれでも守られないルールは、機械のチェックに格上げします。エラーの文に直し方まで書いておけば、AIがそれを読んで自分で直せます。[s1]
直し方② 次の日に忘れる問題には引き継ぎメモ
次は、次の日には忘れている問題です。Anthropicは、これを交代制の職場にたとえています。毎回、前のシフトの記憶がない人がやって来るなら、引き継ぎが大事になります。[s2]
AIの引き継ぎメモ(イメージ)
AIの引き継ぎメモ(イメージ)
同じことをAIにもさせます。作業を終える前に、できたこと・途中のこと・次にやることを引き継ぎメモに書いてもらうのです。次の回のAIは、まずこのメモと作業の記録を読んでから始め、新しいことに入る前に、いまある機能が動くかを確かめます。[s2]
[ { "機能": "予約ボタンで、予約が届く", "確かめ方": "画面で押して、予約一覧を見る", "済": false }, { "機能": "送料が500円と表示される", "確かめ方": "注文画面で金額を見る", "済": true }
]Anthropicの実験では、作るものを200以上の機能の一覧にし、最初はすべて「まだ」としておいて、確かめたものだけを「済」にしていきました。一覧をMarkdownではなくJSONにしたのは、モデルが勝手に書き換えにくかったからだそうです。[s2]
直し方③ 確かめる道具と採点係
作る → 確かめる → 直す
最後が、いちばん大事な「完成と言うのに動かない」問題です。読み返すだけで終わらないように、画面を開いて人と同じようにボタンを押してみる道具をAIに渡します。Anthropicの実験でも、この道具によって、コードだけでは分からないバグを見つけて直せるようになりました。[s2]
終わる前に待ったをかける
終わる前に、待ったをかける(例)
LangChain の例をもとに整理
作業を終える前に「最初の指示と見比べたか」と止める見張り役もよく使われます。LangChainも、こうした仕組みで成績を伸ばしました。[s5]
作る係と採点係を分ける
係を分ける(Anthropic の実験)
作る係
機能を1つずつ作る
採点係
画面で押して、厳しく採点
AIは、自分の作品を自信満々にほめがちです。[s3]そこで、作る係とは別に、厳しい採点係を置きます。Anthropicによると、作る係に自分の作品に厳しくさせるより、採点係を厳しくするほうがずっと簡単だったそうです。[s3]
周りを直したAI(イメージ)
3つを直したうえで、もう一度ボタンを直すよう頼むと、AIはルールの紙と引き継ぎメモを読み、画面でボタンを押して確かめてから「直しました」と答えます(イメージ)。それでも新しいミスは出るので、そのときはまたルールを1行か、道具を足していきます。
危ない操作は囲ってから任せる
操作ごとに通すか止めるかを決める(イメージ)
AIの操作と、ハーネスの受け取り方(例)
※イメージ。どこで止めるかは、使う道具と設定による
AIが予約のデータをすべて消してしまったら困ります。そこで使うのがガードレールで、操作ごとに通すか止めるかを決めておきます。読むことや作業場の中で書くことはそのまま進め、消す・送る・払うといった操作の前は、人に聞くか止めるようにします。[s6]
確認を増やせば安全とは限らない
Anthropic の発表(自社の利用データ)
ただし、確認を増やせば安全になるとは限りません。Anthropicの利用データでは、許可の確認の約93%がそのまま承認されていました。見る回数が多いほど、1回ごとの注意は薄れていきます。これを「承認の疲れ」と呼びます。[s4]
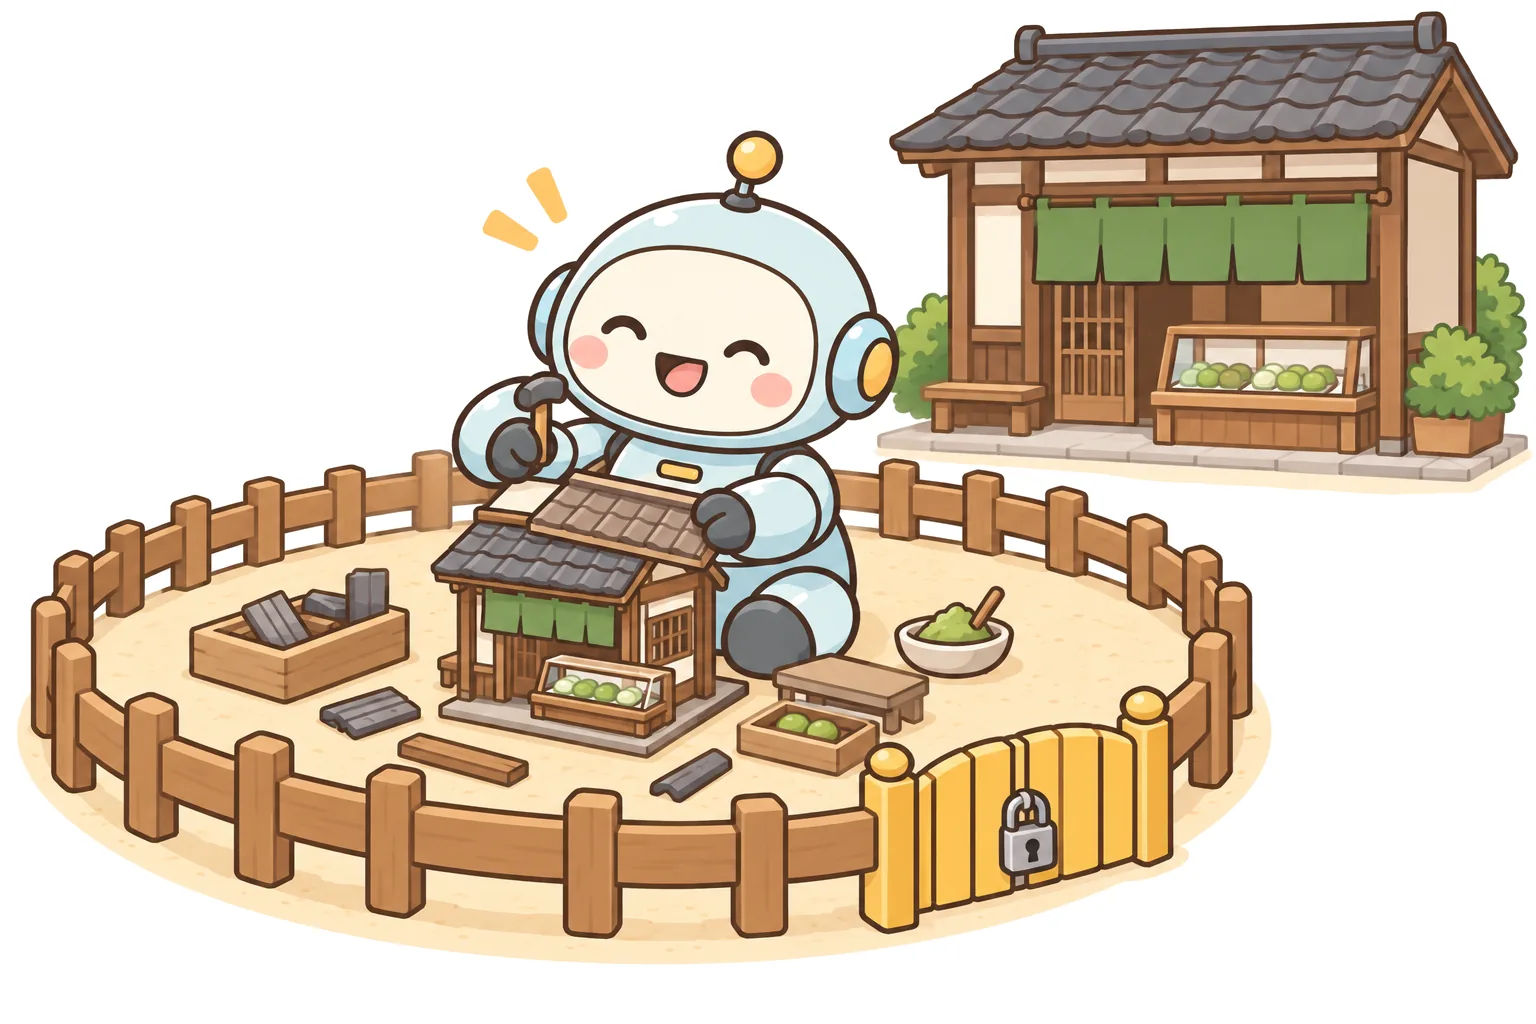
そこで、そもそもAIの手が届く範囲を囲います。本番とは別の練習用の作業場を用意し、書けるのは作業場の中だけ、ネットにも基本的につながないようにします。Anthropicは、このようなOSの機能を使った囲いにしたことで、確認の数が84%減ったと発表しています。[s4]人の確認は、本当に大事なところだけに絞れるようになります。
2026年の動き
ハーネスをめぐる主な動き
ハーネスをめぐる主な動き
各社の発表(2026年10月8日時点)
ハーネスをめぐる動きも見ておきましょう。引き継ぎで長く働く仕組み、名前の広まり、LangChainの結果は、ここまでに紹介したとおりです。[s2][s5][s7]
OpenAIの実験
OpenAI の実験(会社の発表・推定)
2月には、OpenAIが、人が手で書いたコードは0行という実験を発表しました。3人のエンジニアで5か月、約100万行のコードをすべてAIのCodexが書き、手で書く場合の約10分の1の時間で済んだとしています。ただし、これは会社の推定で、同じ準備なしに一般化はできないと本人たちも書いています。[s1]
AIのコードの後片付け(OpenAI)
前は人が
毎週金曜日(週の2割)
今はAIが
ずれを探して、定期的に直す
同じ記事によると、以前は毎週金曜日(週の2割)をAIが書いた雑なコードの後片付けにあてていましたが、いまは守るべき原則をリポジトリに書き、ずれを探して直すAIを定期的に動かしているそうです。[s1]8月にはDeepSeekが、モデル・道具・作業場・画面まですべてを差し替えられる部品にしたハーネスをオープンソースで公開しました。[s8]
NVIDIAの安全の基盤
NVIDIA の安全の基盤(2026年9月)
OpenShell
囲いの中で動かし、行動を記録
Sentry
外に出たら、ミリ秒で隔離
9月にはNVIDIAが、AIエージェントを外から囲って見張る仕組みを発表しました。行動を記録してルールを守らせるOpenShellと、決まりの外に出ようとしたらミリ秒で隔離する見張り役のSentryからなり、AnthropicやMicrosoftなど100以上の組織が参加しているそうです。[s9]
ハーネスの注意点と、ほかのやり方との関係
お金と時間がかかる
同じ注文でアプリを作らせたとき(Anthropic の実験)
Anthropic の技術ブログ(2026年3月)
注意点は3つあります。1つ目はお金と時間です。Anthropicの実験では、同じ注文でアプリを作らせたとき、AIが1人だけなら20分で9ドルでしたが、計画係・作る係・採点係の3つの係を使うハーネスでは6時間で200ドルかかりました。出来ははるかに良くなったものの、費用は20倍以上です。[s3]大事な仕事に絞って使うのがよいでしょう。
2つ目は作り込みすぎです。モデルが賢くなると、要らなくなる部品も出てきます。[s3][s5]Anthropicも、新しいモデルでは以前必要だった仕組みを外せたそうです。[s3]ときどき見直して、要らない部品は外しましょう。
3つ目は、囲いや承認があっても安全は100%ではないことです。DeepSeekも、自社のハーネスの注意書きにそう書いています。権限は最小限にし、使い捨ての作業場で動かして、大事なファイルはバックアップしておきましょう。[s8]
3つのやり方を比べると
3つのやり方をくらべると
| 項目 | 頼み方 | モデル | ハーネス |
|---|---|---|---|
| 変えるもの | 毎回の言葉 | AIの頭脳 | 周りの仕組み |
| 効く場面 | 1回の相談 | 難しい考え | くり返す仕事 |
| 弱いところ | 毎回言い直す | 周りの問題は残る | 作る手間・費用 |
Databricks・各社の技術ブログをもとに整理
頼み方を変えるのは1回の相談に、モデルを替えるのは難しい考えが必要な仕事に、ハーネスを整えるのはくり返す仕事に効きます。[s6]それぞれ弱いところがあるので、どれか1つではなく、組み合わせて使うものだと考えましょう。
今日からできる4つのこと
今日からできる小さなハーネス
今日からできる、小さなハーネス
同じミスは、ルールの紙へ
テストする・画面で押す
済・途中・次を書いてもらう
練習用の場所で。消す・送る・払うは承認
今日からできることは4つです。同じミスをしたらルールの紙に1行足す。作業を頼むときは確かめ方も一緒に頼む。終わる前に引き継ぎメモを書いてもらう。そして練習用の場所で任せ、消す・送る・払うは承認制にする。[s2][s4][s5][s6][s7]
チャットのAIなら
いつも読む指示
カスタム指示・プロジェクトの指示など
ミスを1行ずつ
例:送料は全国一律500円
チャットのAIしか使っていない人も、いつも読ませる指示の欄(カスタム指示やプロジェクトの指示)に、くり返すミスを1行ずつ書くだけで、小さなハーネスになります。
まとめ
ハーネスとは、AIのモデルの周りにある仕組みすべてのことです。モデルが脳なら、ハーネスは体と作業場にあたります。[s6]AIがミスをくり返すときは、叱ったりモデルを替えたりする前に、仕組みにして直せないかを考えましょう。[s1][s7]
まずは、確かめる道具を渡すこと、引き継ぎメモを書かせること、囲った作業場で任せることの3つから始めるのがおすすめです。モデルが良くなれば要らない部品も出てくるので、ときどき見直すことも忘れないようにしましょう。
実践のポイント・まとめ
AIの「できました」をうのみにしていないか
AIは自分の作品をほめがちで、確かめずに「完成」と言うことがあります。作業を頼むときは、画面で押してみる、テストを動かすといった確かめ方も一緒に頼みましょう。AIを替える前に、周りを直すのが近道です。
ハーネスエンジニアリングとは結局何か
AIのモデルはそのままで、ルール・道具・確かめ方・作業場といった周りの仕組みを直す取り組みです。LangChainは周りだけを直してテストの点数を52.8から66.5に上げたと発表しています。ミスをしたら叱らず、仕組みにするのが基本の考え方です。
AIへのルールは長いほどいい?
長いほど大事な指示が埋もれて守られにくくなります。OpenAIは約100行の短い目次を勧めています。1行1行は、AIが実際にやったミスから作りましょう。
AIの確認ボタンを全部OKしていないか
確認が多すぎると、中身を見ずに承認してしまいます(Anthropicのデータでは約93%がそのまま承認)。本番と切り離した作業場で任せれば、人の確認は、消す・送る・払うの大事な場面だけに絞れます。
出典・参考文献
- [s1] OpenAI「ハーネスエンジニアリング:エージェントファーストの世界における Codex の活用」 ↗ openai.com
- [s2] Anthropic「Effective harnesses for long-running agents」 ↗ anthropic.com
- [s3] Anthropic「Harness design for long-running application development」 ↗ anthropic.com
- [s4] Anthropic「How we contain Claude across products」 ↗ anthropic.com
- [s5] LangChain「Improving Deep Agents with harness engineering」 ↗ blog.langchain.com
- [s6] Databricks「What is an AI Agent Harness?」 ↗ databricks.com
- [s7] Mitchell Hashimoto「My AI Adoption Journey」 ↗ mitchellh.com
- [s8] DeepSeek「DeepSeek Harness」GitHub ↗ github.com
- [s9] NVIDIA「NVIDIA Launches Open Agent Safety Platform to Secure Agents From Testing to Deployment」 ↗ investor.nvidia.com
- [s10] Anthropic「How Claude remembers your project(CLAUDE.md)」Claude Code Docs ↗ code.claude.com
- [s11] OpenAI「Custom instructions with AGENTS.md」Codex Docs ↗ developers.openai.com
検証ファクト一覧を表示する(全49項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | AIエージェントのハーネス=LLM を包むソフトの土台。モデルが考え、次にやることを決める。ハーネスが道具・システム・記憶・実行の場所につないで、実際に動かす。「Agent = Model + Harness」 | [s6] | |
| F2 | Databricks の例え:モデルは「脳」、ハーネスは脳の周りの「体と作業場」。エージェントは「考えて動ける働き手」 | [s6] | |
| F3 | 本番のハーネスの8つの部品:いつも読む指示(システムプロンプト)・道具(ツール)・作業場(サンドボックス)・ファイル(作業を残す場所)・記憶とコンテキストの管理・確かめるループ(フィードバック)・ガードレール(人の承認など)・記録(可観測性) | [s6] | |
| F4 | ハーネスがないと、モデルは質問に答えられても、コードを動かす・APIを呼ぶ・ファイルを読む・前の作業を覚える・何段階もの仕事を最後までやる、を自分では確実にできない | [s6] | |
| F5 | プロンプト(頼み方の言葉)→ コンテキスト(何をいつ見せるか)→ ハーネス(周りの仕組み全部)と、注目が外側へ広がってきた。プロンプトとコンテキストはハーネスの一部 | [s6] | |
| F6 | 本番の失敗の多くはモデルではなくハーネスから:長い会話で質が落ちる(コンテキストの劣化)、道具が多すぎて迷う、道具の説明の小さな変更で使い方を誤る、確かめが弱くて早く「完了」と言う、承認なしに取り返しのつかない操作をする など | [s6] | |
| F7 | ハーネスエンジニアリングの目的:モデルの「とがった(得意・不得意のでこぼこな)」賢さを、やりたい仕事に合わせて整える。システムプロンプト・道具・実行の流れを設計する | [s5] | |
| F8 | Mitchell Hashimoto(2026年2月5日):エージェントがミスをしたら、時間をかけて「二度とそのミスをしない」仕組みを作る。それを harness engineering と呼ぶようになった | [s7] | |
| F9 | 仕組みは2種類:(1) AGENTS.md などの指示ファイルを直す(まちがったコマンドを何度も使う、などの単純なもの)(2) 実際の道具を作る(画面を撮るスクリプト、絞ったテストを走らせるスクリプト)。指示ファイルの1行1行が実際の悪い行動から生まれ、それでほぼ全部直った(Ghostty の例) | [s7] | |
| F10 | OpenAI:何かがうまくいかないとき、解決が「もっと頑張れ」になることはほとんどなかった。人は「どの機能が足りないか、どうすればエージェントに分かって使えるようにできるか」と問いかけた | [s1] | |
| F11 | OpenAI:初めは予想より進みが遅かった。Codex の能力が足りなかったのではなく、環境が十分に定義されていなかったから | [s1] | |
| F12 | OpenAI の言葉:「人間が操縦し、エージェントが実行する」 | [s1] | |
| F13 | Anthropic:長く働くエージェントは区切られたセッションで働き、新しいセッションは前の記憶なしで始まる。「交代制で、毎回、前のシフトの記憶がない人が来るソフト開発のチーム」に例えている | [s2] | |
| F14 | Anthropic の観察した失敗:一度に全部作ろうとして途中で力尽きる/しばらく進んだ後のセッションが「もう終わった」と宣言する/ちゃんとテストせずに機能を「完了」にする(end-to-end で動かないことに気づかない) | [s2] | |
| F15 | LangChain:いちばん多い失敗は、エージェントが解を書き、自分のコードを読み返し、「よさそう」と確かめて止まること | [s5] | |
| F16 | LangChain:一度決めた計画に固執して、同じ壊れたやり方の小さな変えた版をくり返す「ドゥーム・ループ」(記録の中には10回以上のものも) | [s5] | |
| F17 | Anthropic:自分が作ったものを評価させると、人から見て明らかに平凡でも、自信満々にほめがち | [s3] | |
| F18 | LangChain:自社のコーディング・エージェント(deepagents-cli)の点数を、モデル(gpt-5.2-codex)は固定し、ハーネスだけ直して、Terminal Bench 2.0 で 52.8 → 66.5(13.7ポイント)。順位は30位の外 → 5位以内 | [s5] | 会社の発表 |
| F19 | Terminal Bench 2.0:AIのコーディング・エージェントのいまの標準のテスト。機械学習・デバッグ・生物学などの89問 | [s5] | |
| F20 | LangChain が直したところ:(1) 計画 → 作る → 確かめる → 直すの流れを指示に書く (2) 終わる前に止めて「課題の指示と見くらべて確かめる」よう促す仕組み(PreCompletionChecklist)(3) 作業場所のフォルダや使える道具を最初に教える (4) 同じファイルを何度も直していたら「やり方を考え直して」と伝える (5) 時間の残りを伝える | [s5] | |
| F21 | LangChain:記録(トレース)を集め、AIで失敗のパターンを分析して、ハーネスを直す、をくり返した | [s5] | |
| F22 | LangChain:こうした見張りは「いまのモデルの弱点に合わせた工夫。モデルが良くなれば、たぶん要らなくなる」 | [s5] | |
| F23 | Claude Code は CLAUDE.md(または AGENTS.md)を毎回のセッションの最初に読む。1ファイル200行未満が目安で、長いと指示が守られにくくなる | [s10] | |
| F24 | Codex は AGENTS.md で、プロジェクトの決まりを指示できる | [s11] | |
| F25 | OpenAI:「1つの大きな AGENTS.md」は失敗した:(1) 大きな指示ファイルが仕事・コードの場所を圧迫し、大事な制約を見落とす (2) すべてが「重要」だと何も重要でなくなる (3) マニュアルはすぐ腐る(古いルールの墓場)(4) 機械でチェックしにくい | [s1] | |
| F26 | OpenAI:AGENTS.md は百科事典ではなく **目次**。約100行の短い AGENTS.md を地図にして、くわしい情報は docs/ の資料に分け、次にどこを見ればいいかを教える | [s1] | |
| F27 | OpenAI:エージェントから見ると、作業中に見られないものは存在しないのと同じ。Google ドキュメント・チャットのスレッド・人の頭の中の知識は見えない。リポジトリに書く | [s1] | |
| F28 | OpenAI:ルールは専用のリンター(機械のチェック)と構造のテストで機械的に守らせる。エラーの文に直し方を書いて、エージェントに伝える。「ドキュメントで足りなければ、ルールをコードに格上げする」 | [s1] | |
| F29 | Anthropic の長時間のハーネス:最初のセッションで、環境を作る(起動のスクリプト init.sh、進み具合のメモ claude-progress.txt、最初の git の記録)。ウェブアプリの例では200以上の機能の一覧を作り、最初は全部「まだ(failing)」にした | [s2] | |
| F30 | 2回目からのセッション:1回に1つの機能だけ進め、終わるときに git に記録し、進み具合のメモを書く。始めるときは、メモと git の記録を読み、基本の動きをテストしてから新しい機能に入る | [s2] | |
| F31 | 機能の一覧は JSON にした(Markdown より、モデルが勝手に書きかえにくかった)。「テストを消したり書きかえたりするのは許されない」と強く書いた | [s2] | |
| F32 | ブラウザを自動で操作する道具を渡して「人と同じように」確かめるよう指示すると、コードだけでは分からないバグを見つけて直せるようになり、性能が大きく上がった | [s2] | |
| F33 | Anthropic:作る係と採点する係を分けると強い。採点係を厳しくするほうが、作る係に自分の作品に厳しくさせるより、ずっとやりやすい | [s3] | |
| F34 | Anthropic:計画係・作る係・採点係の3つのハーネス。採点係は Playwright でアプリを人のように操作して確かめ、基準を下回れば作る係に戻す。作る前に「何をもって完成か」を2つの係で取り決める | [s3] | |
| F35 | Anthropic の比較(レトロゲームを作るアプリ、Opus 4.5):1人のAI 20分・9ドル、ハーネス 6時間・200ドル。20倍以上の費用だが、出来のちがいはすぐ分かった | [s3] | |
| F36 | Anthropic:Opus 4.5 では「文脈の不安」(文脈の上限が近いと思い、早く切り上げる)がほぼ消えたので、前のハーネスにあった「文脈のリセット」を外せた | [s3] | |
| F37 | ガードレール:危ない・認められていない操作を止めるハーネスのルール。例:ファイルを消す・お客さんにメッセージを送る・買い物をする前に人の承認を求める | [s6] | |
| F38 | サンドボックス:外に影響しない、区切られた作業場。リセットや停止もしやすい | [s6] | |
| F39 | Anthropic:Claude Code は以前、毎回許可を求めていたが、利用データでは許可の確認の約93%が承認されていた。見る回数が増えるほど1回ごとの注意が減る(承認の疲れ) | [s4] | |
| F40 | Anthropic:OSの機能のサンドボックス(読むのはよい、書くのは作業場の中だけ、ネットは基本つながない)にしたら、許可の確認が84%減った | [s4] | 会社の発表 |
| F41 | Anthropic:人が1つずつ見張る方法と、囲い(サンドボックス・仮想マシン・外への通信の制限)で「そもそも何ができるか」を決める方法の2つがある。資格情報がサンドボックスに入らなければ、誰のせいでも持ち出されない | [s4] | |
| F42 | DeepSeek Harness の注意書き:試作段階で安全の監査を受けていない。サンドボックス・承認の確認・権限の管理はリスクを減らすが、隔離を保証しない。最小の権限で、使い捨ての仮想マシンやコンテナで、ファイルはバックアップを | [s8] | |
| F43 | OpenAI:2025年8月下旬の空のリポジトリから5か月、手書きのコードは0行、すべて Codex が書いた。約100万行・約1,500件のプルリクエスト(3人のエンジニア、平均1人1日3.5件)。手で書くより約10分の1の時間(推定)。社内で数百人が使う | [s1] | 自社の推定 |
| F44 | OpenAI:毎週金曜日(週の20%)をAIの雑なコードの後始末にあてていた → 「黄金の原則」をリポジトリに書き、定期的に逸脱を探して直すエージェントを走らせる(ガベージコレクション) | [s1] | |
| F45 | OpenAI:1回の Codex の実行が1つの課題に6時間以上(人が寝ている間に)働くのを日常的に見ている | [s1] | |
| F46 | DeepSeek Harness:2026年8月13日に GitHub で公開(MIT ライセンス、TypeScript、開発者向けプレビュー)。モデル・道具・スキル・セッション・サンドボックス・ファイル・ループ・画面まで、すべてがプラグイン(差しかえられる部品)。GitHub のスター約24.5万(10月8日) | [s8] | |
| F47 | NVIDIA Open Agent Safety Platform(2026年9月28日):OpenShell(オープンソースの実行の囲い。行動を記録し、ルールを守らせる)+ Sentry(BlueField-4 で動く、外からの見張り。境界の外に出ようとするとミリ秒で隔離)。「モデルとハーネスの外に、強制できる境界が要る」。Anthropic・Microsoft など100以上の組織が参加 | [s9] | |
| F48 | NVIDIA:最近の事件はどれも「エージェントが、与えられた仕事を終えるために、アプリ側の安全の仕組みをすり抜けた」 | [s9] | |
| F49 | Databricks:モデルが良くなると、ハーネスの仕事の一部はモデルに移る。それでも実行環境・道具・ガードレール・記録・確かめるループは残る。使い捨てのハーネス、自然言語で書くハーネス(NLAH)も出てきている | [s6] |
※ 記事中のお店の予約ページ、AIとのやりとり、ルールの紙(AGENTS.md)、引き継ぎメモ、機能の一覧、チェックのエラー、操作ごとの止め方の表はイメージです。
※ ハーネスの部品は、Databricks の解説の8つ(システムプロンプト・ツール・サンドボックス・ファイル・記憶・フィードバック・ガードレール・可観測性)を、説明のため7つにまとめたものです。
※ 「52.8→66.5」「30位の外から5位以内」は LangChain の発表(2026年2月、Terminal Bench 2.0、自社調べ)、「約100万行・手書き0行・約10分の1の時間」は OpenAI の発表(2026年2月、自社の推定)、「確認の約93%が承認」「確認が84%減」「20分・9ドルと6時間・200ドル」は Anthropic の技術ブログ(自社のデータ・実験)です。独立した検証は見つけていません。
※ 「12問ほど多く解けた」は、89問×点数の差(13.7ポイント)で計算したおおよその数です。
※ 各社の製品・ドキュメントの内容は、2026年10月8日時点のものです。今後変わることがあります。
※ ロボットのイラストはイメージで、特定の会社の製品やロゴとは関係ありません。