2026年10月17日、DeepSeekが新モデル「DeepSeek-V4.1-Flash-1017」を公開しました。ゲームや3Dを作る作例、コーディングとAIエージェントの成績向上、検索APIの公開が話題になっています。
本記事では、「ClaudeやChatGPTから乗り換える価値はあるのか」という問いを軸に、DeepSeekの発表・技術レポート・料金表を読み解きます。9月版からの伸び、GPT-5.6 SolやClaude Opus 5との比較、同じ仕事にかかる費用、安さを支える仕組み、料金とピーク時間、使い始め方、そしてデータを送る前に確かめることまでを整理します。
情報は2026年10月18日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- コーディングと自動化の成績が上がり、API料金は据え置き。ただし数字はDeepSeek自身の発表。
- 全面的な乗り換えより、仕事ごとに並べて試して使い分けるのが現実的。
- 送るデータは、DeepSeekのプライバシーポリシーと社内のルールを確かめてから。
基礎知識:DeepSeek-V4.1-Flash-1017が安く速い理由
「DeepSeek-V4.1-Flash-1017」は、DeepSeekが2026年10月17日に公開した、コーディングとAIエージェント向けのモデルです。DeepSeek自身が公表した比較表では、一部のコーディング系テスト(DeepSWEなど)でGPT-5.6 SolやClaude Opus 5を上回り、難問のテスト(HLE)などでは下回っています。そのうえでAPIの料金を低く抑えていることが特徴で、モデルの重みもMITライセンスで公開されています。
AIエージェントによる開発作業では、ソースコードやエラーログなど大量の入力を何度も読み込むため、入力の処理がコストの大部分を占めます。DeepSeekはモデルの40層を「入力を読む20層(Causal Encoder)」と「答えを作る20層(Decoder)」に分け(CED)、1語あたりに計算で使うパラメータを、入力を読むときは約80億、答えを作るときは約160億としています(DeepSeekの技術レポート)。
さらに、AIが読んだ内容を覚えておく作業用のメモリ(KVキャッシュ)を大きく縮め、1トークンあたりの大きさを2023年の初代V1の約39万バイトから890バイト(約437分の1)にしました。よく出る言い回しを辞書のように引く「Engram」や、下書きを先に作って速くする「DSpark」も組み合わせています。
DeepSeekの新モデルが公開
- 題名は「願いで作るプログラミングを現実に」
- 成績・速さ・短い出力がよくなった(DeepSeekの説明)
DeepSeekは10月17日の発表で、成績・速さ・出力の短さが良くなったと説明し、ゲームや3Dを作る作例も公開しました。[s1]話題性は十分ですが、乗り換えるかどうかは、数字と条件を確かめてから決めるべきです。
DeepSeekのモデルの流れ
DeepSeekのモデルの流れ(2026年)
まず名前を整理します。DeepSeekは2026年に入って新しいモデルを次々に公開しています。[s1][s5]今回の「1017」は10月17日のことで、9月に出たV4.1 Flashの小さな更新版です。[s1][s3]
基本の仕様
V4.1-Flash-1017
読める量は100万トークン、1回の最大の出力は38.4万トークンです。[s2]トークンはAIが文章を数える単位で、長い資料をまるごと読ませられる量です。画像も読めますが、答えは文字だけです。重み(AIの頭脳にあたる数値のかたまり)はMITライセンスで公開されています。[s2][s3]
公式の作例から分かること
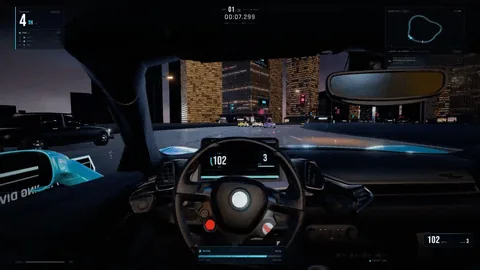
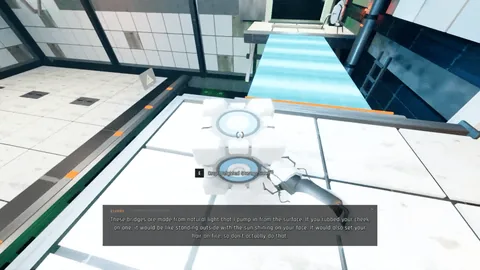
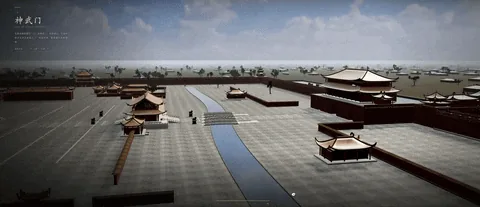
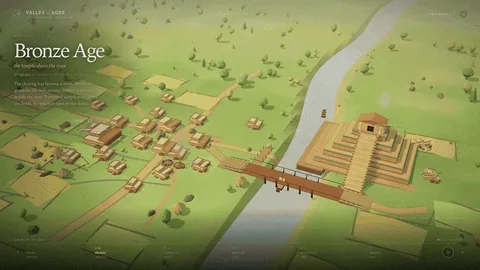
公式が見せた作例は4つで、ブラウザで遊べるレースゲーム、ゲームエンジンのGodotで作った3Dのゲーム、故宮の3Dモデル、時代をたどる3Dのシーンです。[s1]DeepSeekによると、出来上がりを自分で確かめて直す学習(強化学習)で、最初から最後まで作り上げる力を伸ばしたそうです。[s1]
ただし、作例は選ばれたものであり、何回試して何回成功したかは書かれていません。[s1]作例は「できることの例」として受け止め、実力は次の成績で確かめるのが妥当です。
成績 —— 9月版からの伸び
9月版と10月17日版の比較
9月版と10月17日版(DeepSeekの発表)
| 項目 | 9月版 | 10/17版 |
|---|---|---|
| Terminal-Bench | 31.2 | 42.3 |
| ProgramBench | 20.3 | 29.1 |
| HLE(難問) | 36.8 | 42.6 |
| Automation | 54.8 | 60.5 |
| Agents' Last Exam | 31.8 | 35.4 |
| DeepSWE | 74.2 | 77.0 |
DeepSeekの発表(自社で測定)。点数は、高いほどよい
9月のV4.1 Flashと比べた数字は、DeepSeekの発表によるものです。[s1][s3][s5]いちばん伸びたのはターミナル(CLI)の作業のテスト(Terminal-Bench)で、31.2点から42.3点になりました。ほかのテストも、6つすべてで点数が上がっています。[s3]
Terminal-Bench 4.0 の計算(31.2 → 42.3)
点数の差と増え方の割合は別の数字です。31.2点から42.3点への伸びは11.1点で、もとの点数から見ると約36%の増加にあたります。[s3]
テストの中身
ターミナル(CLI)操作
Terminal-Bench
不具合を直す
DeepSWE
ゼロから作る
ProgramBench
仕事の自動化
Automation-Bench
テストの中身は、ターミナルの作業、不具合の修正、ゼロからの開発、仕事の自動化などです。いずれも、AIが道具を使って最後まで作業をやり切れるかを測るもので、エージェントとしての実力を見るのに向いています。[s3]
ClaudeやGPTと比べると
ClaudeやChatGPTより上と言える?
- 今回の1017
- Claude Opus 5
- GPT-5.6 Sol
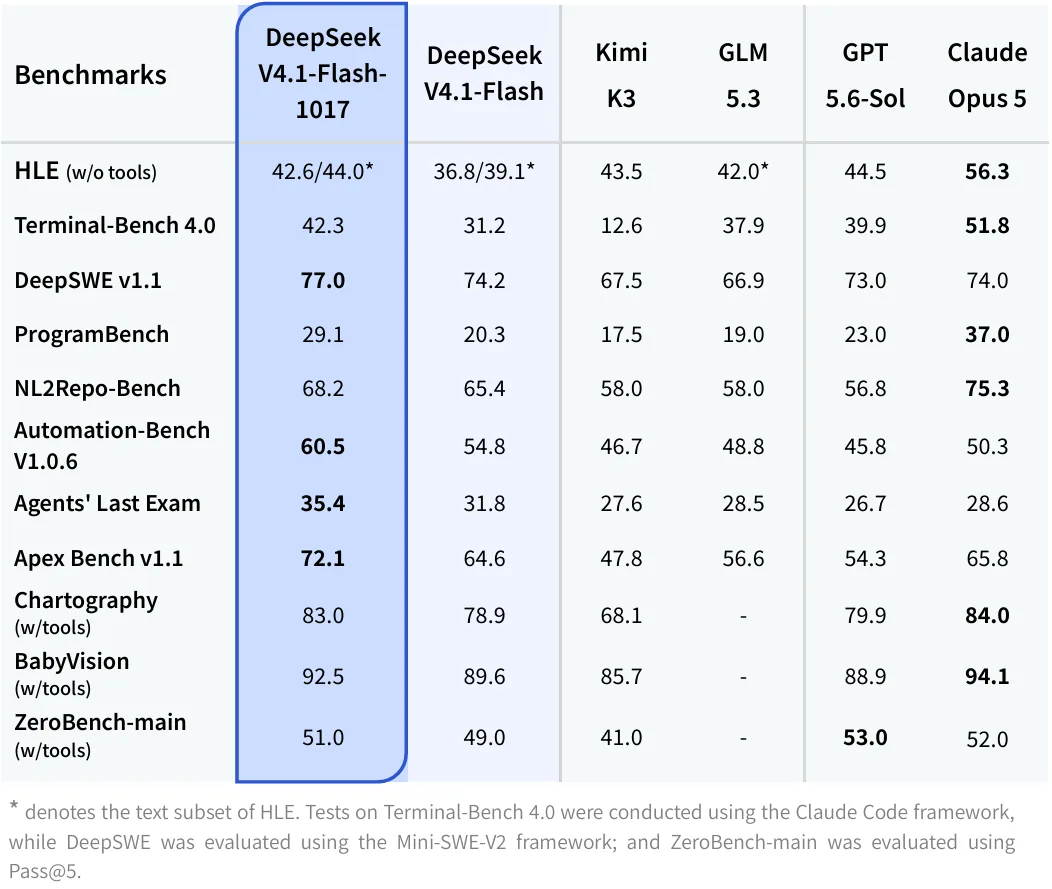
DeepSeekの発表には、Claude Opus 5とGPT-5.6 Solを並べた表が載っています。[s1][s3]
7つのテストの比較(点数が高いほどよい)
7つのテスト(DeepSeekの表・点数が高いほどよい)
| 項目 | DeepSeek 1017 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|
| DeepSWE | 77.0 | 73.0 | 74.0 |
| Automation | 60.5 | 45.8 | 50.3 |
| Agents' Last Exam | 35.4 | 26.7 | 28.6 |
| Terminal-Bench | 42.3 | 39.9 | 51.8 |
| ProgramBench | 29.1 | 23.0 | 37.0 |
| NL2Repo | 68.2 | 56.8 | 75.3 |
| HLE(難問) | 42.6 | 44.5 | 56.3 |
DeepSeekがモデルカードにまとめた表(各社の公式の順位表ではない)
7つのテストのうち、DeepSeekが1位だったのは、不具合を直すテスト、仕事を自動化するテスト、調べて答えるテストの3つです。Opus 5が1位だったのは、ターミナルの作業、ゼロからの開発、難問の推論の4つでした。[s3]つまり、全体としてClaudeより上とは言えません。KimiのK3とGLM-5.3に対しては、HLE以外の6つで上回っています。[s3]
ただし、これはDeepSeekが自分でまとめた表で、測り方によって点数は変わります。[s3]1017版を独立した機関が測った結果は、10月18日の時点では見つかりませんでした。DeepSeek自身も、最も難しい課題ではまだ差があると書いています。[s4]
同じ仕事にかかる費用
- DeepSeek 1017 約0.2ドルで77%
- Claude Opus 5 約12ドル(図から読んだ目安)
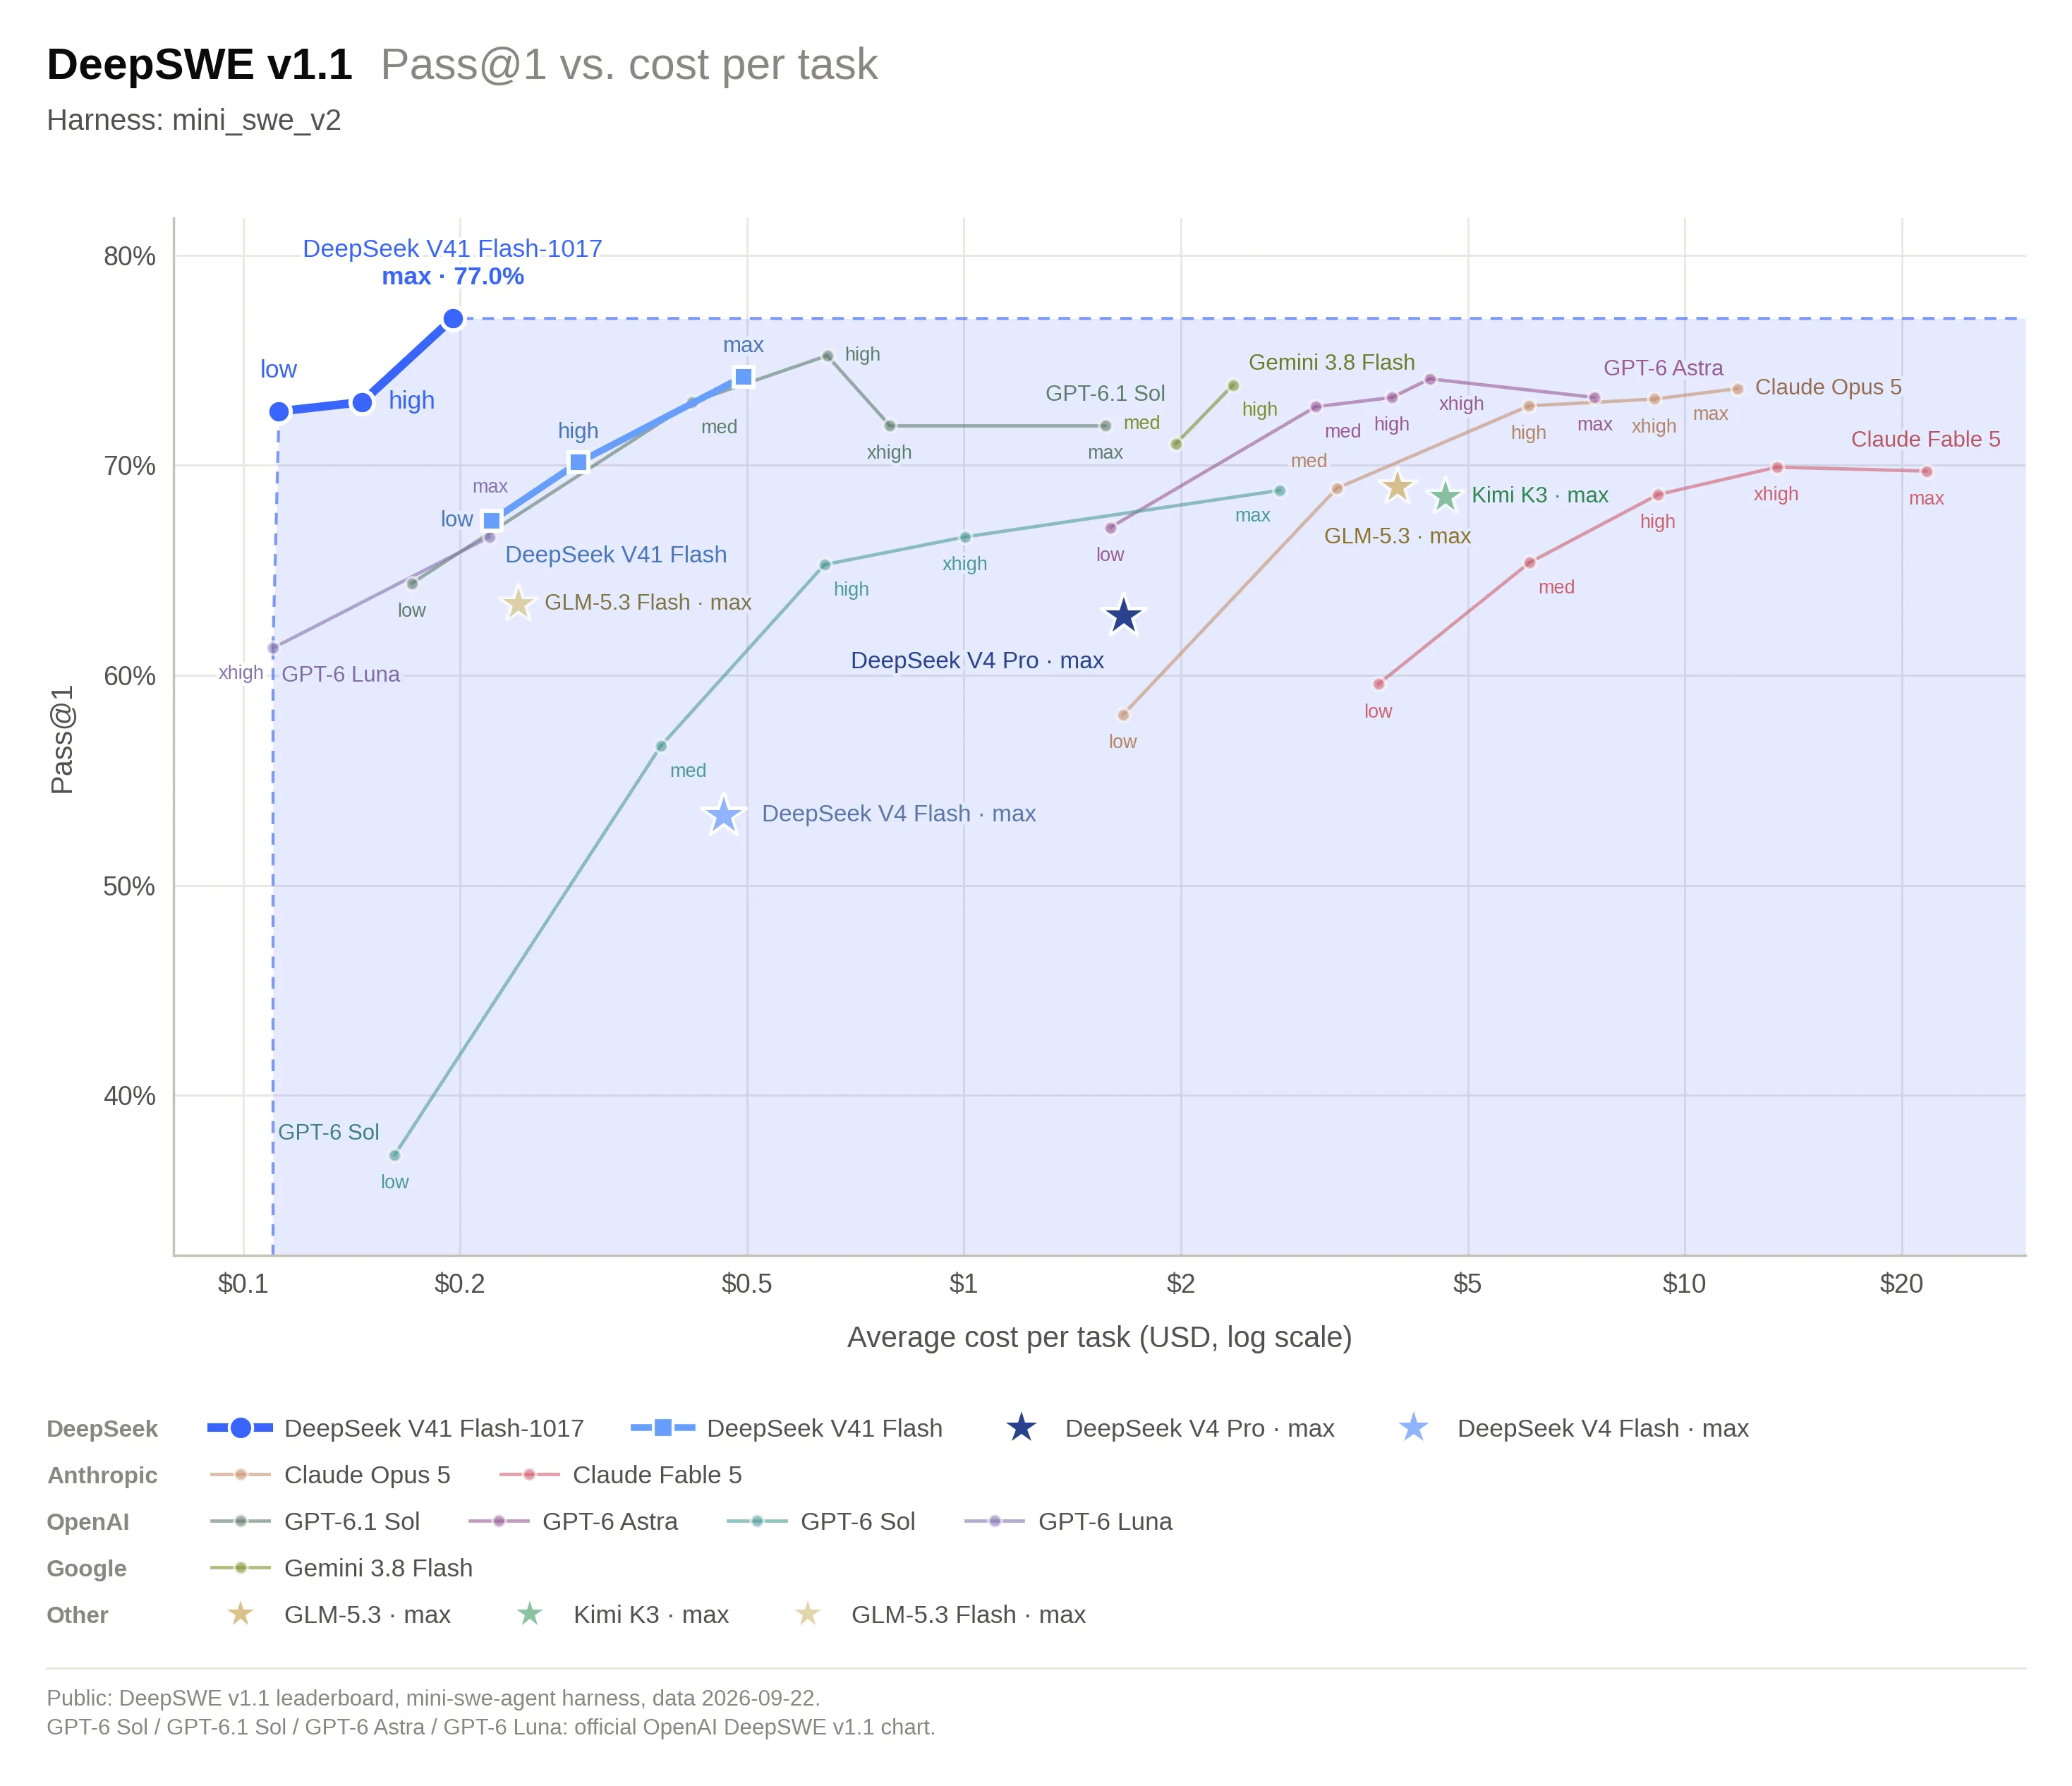
DeepSeekは、同じ課題にかかった費用を比べた図も公開しています。横軸が1つの課題にかかる費用、縦軸が正解率です。[s1]図から読むと、DeepSeek 1017は1課題あたり約0.2ドルで正解率77%、Opus 5は約12ドルで約74%で、費用には約60倍の差があります。[s1]
ただし、これもDeepSeekが作った図です。自分の仕事に当てはまるかは、同じ条件で確かめる必要があります。[s1]
なぜ安いのか —— 仕組み
エージェントの作業は「読む」量が多い
1回の作業の例(イメージ)
AIエージェントは、作業の中でコードやログを何度も読み直すため、書く量より読む量のほうがずっと多くなります。そのため、「読む」部分を軽くすることがいちばん効きます。
中身を「読む係」と「答える係」に分ける
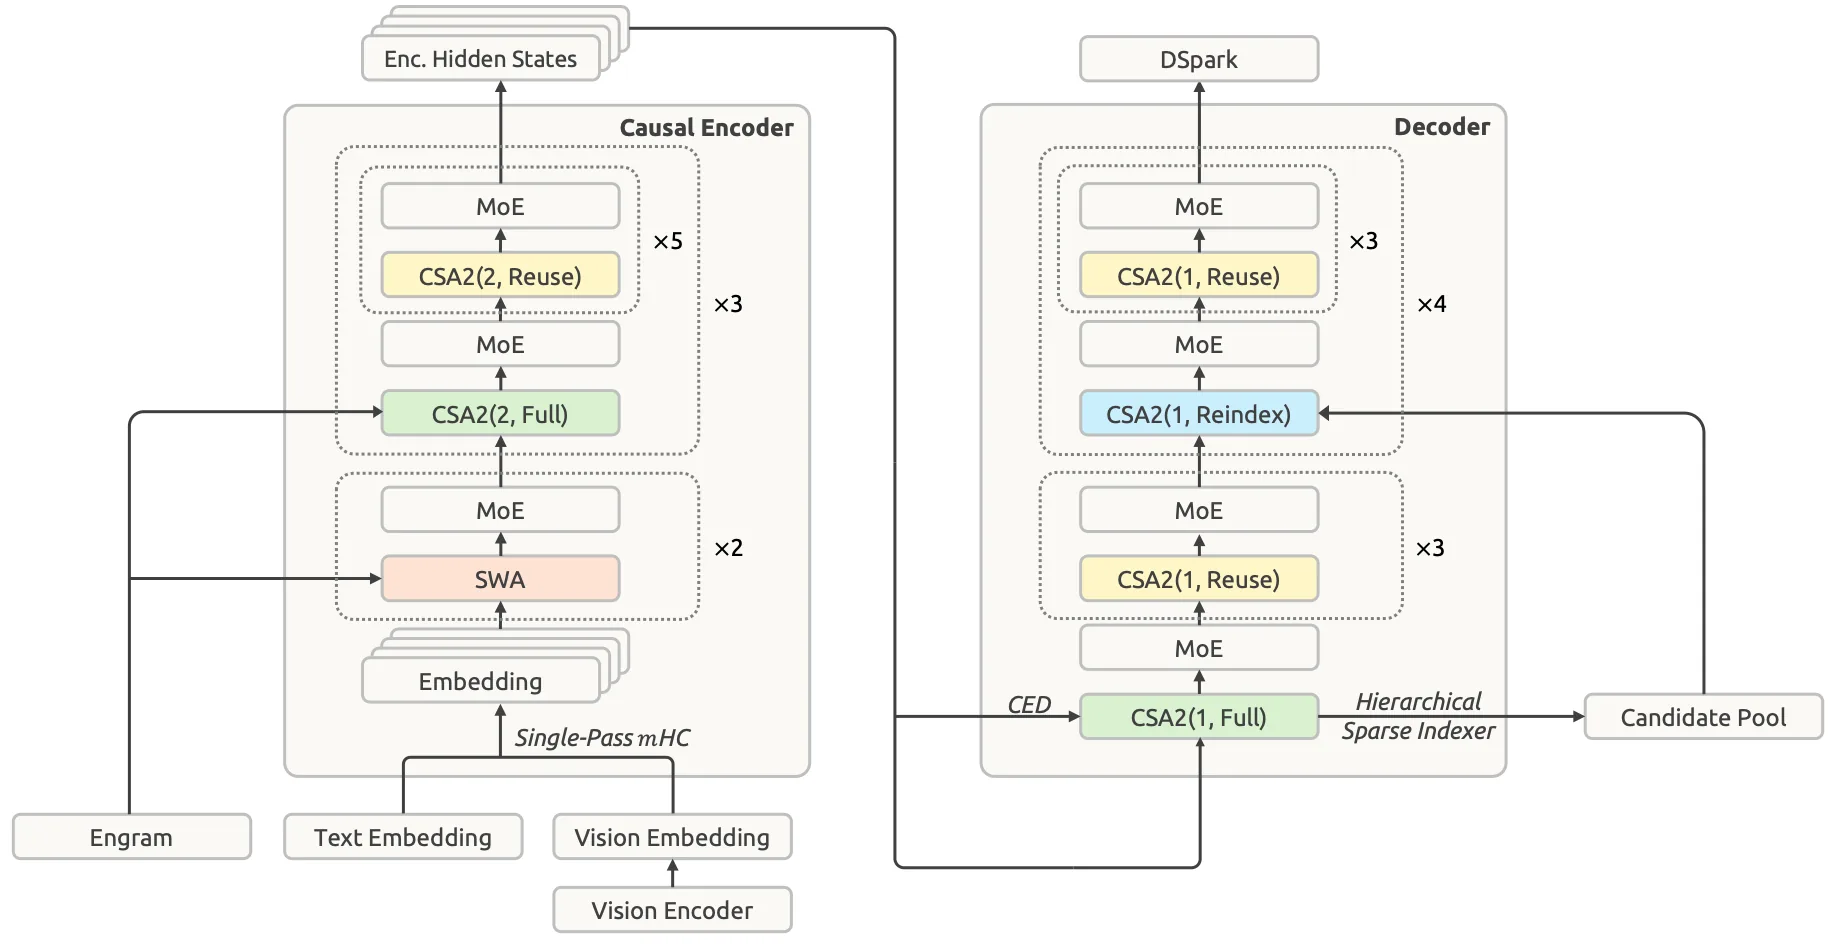
- エンコーダ層(20層)
- デコーダ層(20層)
1つ目の工夫は、AIの中身を前半と後半に分けたことです。全部で40層ある中身を、入力を読む20層と答えを作る20層に分けています。[s4]
全体は552B(5,520億個)。1トークンあたりの活性パラメータ(技術レポート)
モデル全体は5,520億パラメータですが、1回に動かすのは、読むときが約80億、答えるときが約160億です。[s4]読むときに動かす量は、答えるときの約半分で済みます。また、専門家が384人いて、1回に働くのはそのうち6人と共通の1人だけという構造です。[s3]
読んだ内容のメモを小さくする
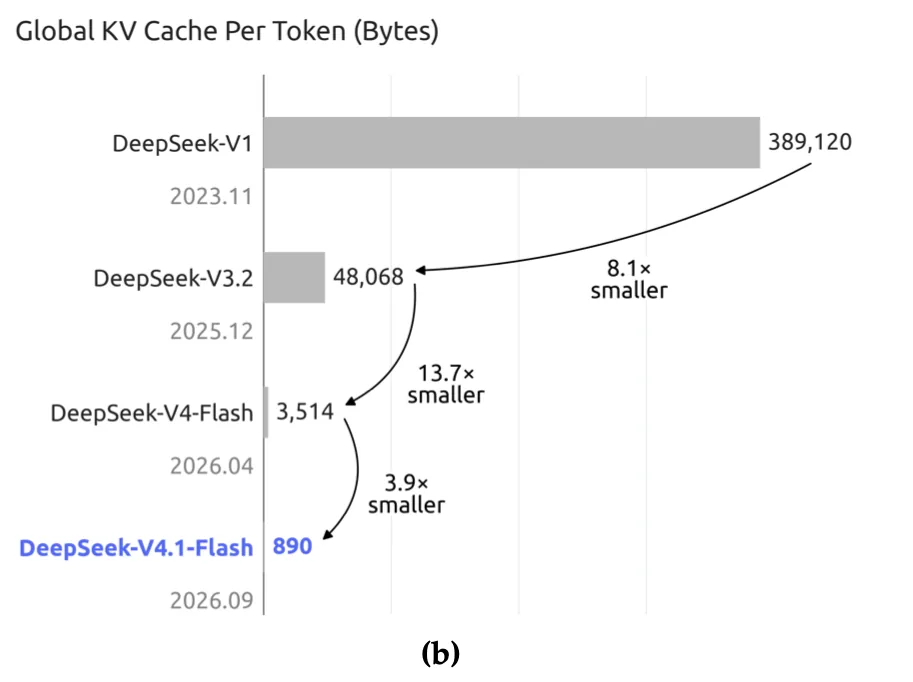
- 2023年のV1 約39万バイト
- 今回 890バイト
2つ目の工夫は、KVキャッシュを大きく縮めたことです。AIは読んだ内容を見返すためのメモとしてGPUのメモリに置いており、長い作業ほどメモが増えてメモリを使います。[s4]このメモの大きさは、2023年のV1では1トークンあたり約39万バイトでしたが、今回は890バイトになりました。約437分の1で、前のV4 Flashと比べても約4分の1です。[s4]100万トークンを読んでも、メモは計算上約890MBに収まります。[s4]
ほかの工夫
Engram
よく出る言い回しを辞書で引く
DSpark
先に下書きして、あとで確認
ほかにも、よく出る言い回しを辞書のように引くEngramと、下書きを先に作って速くするDSparkを組み合わせています。[s4]一方で、DeepSeekは、試していない場面では性能が落ちる可能性があることも書いています。[s4]
料金とピーク時間
100万トークンあたりの料金(ドル)
100万トークンあたり(ドル)
| 項目 | deepseek-flash | V4 Pro |
|---|---|---|
| 入力・通常 | 0.15 | 0.66 |
| 入力・ピーク | 0.30 | 1.32 |
| 出力・通常 | 0.60 | 1.98 |
| 出力・ピーク | 1.20 | 3.96 |
DeepSeek API Docs(2026年10月18日)。通常=オフピーク
料金は100万トークンあたりで決まり、読む(入力)と書く(出力)で値段が別で、読むほうが安く設定されています。[s2]表は、deepseek-flashと、より大きいV4 Proを比べたものです。「通常」は空いている時間帯の料金で、混雑するピークの時間帯はちょうど2倍になります。[s2]
日本時間で見たピーク
日本時間で見ると
平日10〜13時
ピーク(2倍)
平日15〜19時
ピーク(2倍)
それ以外・土日
通常(半額)
日本時間に直すと、平日の10時から13時と、15時から19時がピークです。[s2]ちょうど日本の仕事の時間と重なるため、使う時間帯には注意が必要です。
1か月の費用の試算
1か月の費用の試算(ドル)
試算:1回=入力10万+出力1万トークン、1日20回×22日、キャッシュなし
例として、サイトの修正をAIに1日20回頼み、1回に10万トークンを読ませて1万トークンを書かせる場合を、平日22日分で試算しました。平日の昼のピークに使うと1か月で約18ドル(約2,800円)、夜や土日に回せば半分の約9ドル(約1,400円)です。大きいV4 Proの通常料金なら約38ドル(約5,700円)になります。
100万トークンあたり・通常。約50分の1(DeepSeek API Docs)
さらに、前に読んだ内容と先頭が同じ部分はキャッシュが効き、入力の料金が約50分の1になります。[s2][s5]試算では、入力の9割がキャッシュにあたれば、1か月で約3.4ドルです。
なお、公式も料金は変わることがあると書いているので、使う前には必ず最新の料金表を確かめましょう。[s2]ClaudeやGPTと比べる場合も、各社の料金表で同じ条件にそろえて比べる必要があります。
成績を左右する「ハーネス」と検索API
表の下の小さな注
表の下の注(DeepSeekの発表)
Terminal-Bench 4.0
Claude Codeで測定
DeepSWE
Mini-SWE-V2で測定
成績の表の下には、テストに使った道具が小さく書かれています。Terminal-BenchはClaude Codeで、DeepSWEはMini-SWE-V2で測ったものです。[s3]
ハーネスとは
ハーネスの仕事
道具を使う
コマンドやツール
ファイル操作
読む・書く
エラーを直す
やり直す
覚えておく
記憶の管理
成績はモデルだけでなく、それを動かす仕組みによっても変わります。道具を使う、ファイルを読み書きする、エラーを直してやり直す、覚えておく、といった仕事を受け持つこの仕組みを、ハーネスと呼びます。DeepSeekは、自社のDeepSeek Harnessなどに合わせて調整したと書いており、Claude Codeから使うための設定手順も公開しています。[s1][s5]
検索APIとページ取得API
ハーネス・Claude Code・Codex 経由のサーバー側ツールが対象(DeepSeek API Docs)
10月17日には、AIエージェントが調べものをするための検索APIとページ取得APIも公開されました。[s1][s2]どちらも成功1,000回ごとに0.75ドルで、DeepSeek HarnessやClaude Code、Codexを経由するサーバー側の利用は、日本時間の11月1日午前1時まで無料です。[s1][s2]人が使う検索サイトではなく、AIエージェントが使う道具である点に注意してください。[s1]
使い始めるには
from openai import OpenAI
client = OpenAI( api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com",
)
r = client.chat.completions.create( model="deepseek-flash", messages=[{"role": "user", "content": "レビューして"}], reasoning_effort="high",
)OpenAI形式のAPIがそのまま使えるため、使い始めるのは簡単です。つなぎ先のURLをDeepSeekに変え、モデル名に「deepseek-flash」を指定すれば、最新の1017版が使われます。[s1][s2][s5]考えるモードは最初からオンで、強さはlow・high・maxから選べます。[s5]
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=(自分のAPIキー)
export ANTHROPIC_MODEL=deepseek-flash[1m]
Claude Codeから使う場合は、環境変数を3つ変えるだけです。APIキーは人に見せないように管理しましょう。[s5]
乗り換えるかどうか —— 3つの見方
乗り換えの3つの見方
得意な項目を見る
保存と利用を確かめる
並べて試して決める
乗り換えるべきかどうかは、仕事しだいです。判断には3つの見方があります。1つ目は仕事の種類です。DeepSeekの表では、不具合の修正や仕事の自動化でDeepSeekの数字が高く、ターミナルの作業やゼロからの大きな開発、難問の推論ではOpus 5の数字が高い結果でした。[s3]得意な項目が分かれているので、自分の仕事に近い項目を見ることが大切です。
送るデータとプライバシーポリシー
DeepSeekのプライバシーポリシー(2026年2月更新)
保存する場所
中華人民共和国のサーバー
モデルの訓練
使うことがある(拒否する権利)
2つ目は、送るデータです。DeepSeekのプライバシーポリシーには、集めた情報を中華人民共和国のサーバーに保存すること、モデルの訓練に使うことがあること(拒否する権利があること)が書かれています。[s6]会社の秘密やお客様の情報を送る前には、ポリシーと利用規約、そして社内のルールを必ず確かめてください。[s6]
公開された重みを手元に置くには
公開された重みを、そのまま置くと
Hugging Faceの公開ファイルの合計。PCの32GBは目安、サーバーはイメージ
重みが公開されているので手元で動かすという選択肢もありますが、ファイルは合計で約510GBあり、一般的なパソコンには入りません。複数のGPUを持つサーバーが必要です。Hugging Faceに表示される約7,630億パラメータは、本体の5,520億にEngram(約1,960億)などを足した合計です。[s3][s4]個人なら、送るデータを確かめたうえで、まずは公式のAPIを使うのが現実的です。
乗り換える前の試し方
乗り換える前の試し方
今のAIとDeepSeek
直した回数・費用・時間
全部は乗り換えない
3つ目は費用と手間です。同じ仕事をいまのAIとDeepSeekの両方に頼み、直した回数・費用・時間を記録して比べましょう。そのうえで、向いている仕事だけを移し、すべてを一度に乗り換えないことをおすすめします。
まとめ
DeepSeek-V4.1-Flash-1017は、コーディングと自動化の成績を伸ばしながら、API料金を据え置きました。ただし、成績と費用の数字はDeepSeek自身の発表で、Claude Opus 5に全面的に勝っているわけでもありません。[s1][s3]
乗り換えるより、仕事ごとに並べて試し、向いている仕事に使い分けるのが現実的です。送るデータについては、ポリシーと社内のルールを確かめてから判断しましょう。[s6]
実践のポイント・まとめ
AIの料金を下げるキャッシュのコツ
DeepSeekのAPIは、前に読んだ内容と先頭から同じ部分の入力が安くなります。毎回変わる内容を後ろに回し、共通の指示や資料を先頭にそろえるのがコツです。すぐ効くとは限りませんが、試す価値はあります。
1分のショート動画で見る「勝った」の表は下の小さな字を読む
成績の表を見るときは、比べた相手が最新か、測った道具(ハーネス)が同じか、テストの中身が自分の仕事に近いかの3点を確かめましょう。DeepSeekの表の下にも、測った道具が小さく書かれています。
1分のショート動画で見る無料公開のAIは自分のPCで動く?
重みが公開されていても、動かすにはファイルがメモリに収まる必要があります。一般的なパソコンのメモリは16〜32GBほどで、DeepSeek-V4.1-Flashの重みは約510GBです。ファイルの大きさとメモリを比べてから判断しましょう。
1分のショート動画で見る安いAIに名簿を送る前に
送る前に、データがどこの国のサーバーに保存されるか、モデルの訓練に使われるか、社内のルールで送ってよい情報かの3点を確かめましょう。DeepSeekのポリシーには、訓練に使うことがあるとも書かれています。
1分のショート動画で見る出典・参考文献
- [s1] DeepSeek API Docs「DeepSeek-V4.1-Flash-1017 Release」 ↗ api-docs.deepseek.com
- [s2] DeepSeek API Docs「Models & Pricing」 ↗ api-docs.deepseek.com
- [s3] Hugging Face「deepseek-ai/DeepSeek-V4.1-Flash-1017」モデルカード ↗ huggingface.co
- [s4] DeepSeek-AI「DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression」技術レポート ↗ huggingface.co
- [s5] DeepSeek API Docs(Change Log・Context Caching・Thinking Mode・Claude Code 連携) ↗ api-docs.deepseek.com
- [s6] DeepSeek「プライバシーポリシー」・Open Platform Terms of Service ↗ cdn.deepseek.com
検証ファクト一覧を表示する(全19項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | 2026-10-17 に DeepSeek-V4.1-Flash-1017 を公開。9月10日の V4.1 Flash の小さな更新(minor update)。公式の Web・アプリは新版に更新ずみ。API は `deepseek-flash` のまま(料金も同じ)。重みは Hugging Face と ModelScope で公開 | [s1] [s3] [s5] | |
| F2 | 文脈の長さ 100万トークン、最大出力 38.4万(384K)。考えるモード(thinking)が既定。画像の入力に対応(Flash のみ。V4-Pro は非対応)。出力はテキスト。ライセンスは MIT | [s2] [s3] | |
| F3 | 40層を「入力を読む20層(Causal Encoder)」と「答えを作る20層(Decoder)」に分ける(CED)。本体 552B、Engram 196B。1トークンあたりの活性パラメータは入力を読むとき(prefill)8B、答えを作るとき(decode)16B | [s4] | |
| F4 | MoE の設定:専門家(ルーテッド)384、1トークンで使うのは6+共通1 | [s3] | |
| F5 | KV キャッシュ(GPU メモリに常にある分)は1トークン890バイト=V4-Flash(3,514)の約1/4。V1(2023-11)は389,120バイトで約437分の1。SSD・ホストメモリに残す分は約1/8(SWA Bounded Replay)。技術は CSA2(層をまたいで再利用)・FP4 のキャッシュ | [s4] | 100万トークン×890バイト≒890MB(計算) |
| F6 | Engram=約196Bの「条件つきメモリ」(N-gram をハッシュで引く。推論時はホストメモリから先に取り寄せる)。DSpark=先に下書き(5語分)を作って本体が確かめる推測デコーディング | [s4] | |
| F7 | 9月版→10/17版(DeepSeek 公表):HLE 36.8→42.6、Terminal-Bench 4.0 31.2→42.3、DeepSWE 77.0(旧74.2)、ProgramBench 20.3→29.1、Automation-Bench 54.8→60.5、Agents' Last Exam 31.8→35.4。ポイント差で、相対ではない | [s1] [s3] [s5] | Terminal-Bench は相対+35.6%(計算) |
| F8 | 比較(DeepSeek がモデルカードに載せた表):1017 / GPT-5.6 Sol / Claude Opus 5 / Kimi K3 / GLM-5.3 — HLE 42.6/44.5/56.3/43.5/42.0†、Terminal-Bench 42.3/39.9/51.8/12.6/37.9、DeepSWE 77.0/73.0/74.0/67.5/66.9、ProgramBench 29.1/23.0/37.0/17.5/19.0、NL2Repo 68.2/56.8/75.3/58.0/58.0、Automation-Bench 60.5/45.8/50.3/46.7/48.8、Agents' Last Exam 35.4/26.7/28.6/27.6/28.5 | [s3] [s1] | 自社の表。Opus 5 が1位の行:HLE・Terminal-Bench・ProgramBench・NL2Repo |
| F9 | DeepSeek の図(DeepSWE v1.1:正解率と1タスクの費用):1017(max)は約0.2ドルで77.0%、Claude Opus 5 は約12ドルで約74%(図から読んだ目安)。他社の点は公開リーダーボード(2026-09-22)と OpenAI の公式の図から | [s1] | |
| F10 | 料金(100万トークンあたり・ドル):flash — 入力キャッシュなし 0.15(ピーク0.30)、キャッシュあり 0.003(0.006)、出力 0.60(1.20)/V4 Pro — 0.66(1.32)、0.022(0.044)、1.98(3.96)。オフピークはピークの半額 | [s2] | |
| F11 | ピーク:平日 UTC 01:00–04:00 と 06:00–10:00(中国の祝日を除く)=日本時間の平日10〜13時と15〜19時。土日・中国の祝日は終日オフピーク | [s2] | UTC+9 の計算 |
| F12 | Search API・Fetch API を公開(1,000回の成功で0.75ドルずつ)。DeepSeek Harness・Claude Code・Codex 経由のサーバー側ツールは2026-10-31 16:00 UTC(北京時間11/1 0:00、日本時間11/1 1:00)まで無料 | [s1] [s2] | |
| F13 | Hugging Face の重み:合計 763,205,315,794 パラメータ、ファイルの合計約510GB(510,297,211,639バイト)。FP8+FP4の重み。MIT | [s3] | |
| F14 | Context Caching(既定でオン):同じ先頭(prefix)が続く部分だけがキャッシュにあたる。共通の先頭を見つけて保存するので、2回目からすぐ効くとは限らない | [s5] | |
| F15 | Thinking:既定で有効、`reasoning_effort` は low / high / max(medium は high に、xhigh も high に対応)。OpenAI 形式の URL は https://api.deepseek.com、Anthropic 形式は https://api.deepseek.com/anthropic | [s2] [s5] | |
| F16 | Claude Code から使う設定:環境変数 ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic、ANTHROPIC_AUTH_TOKEN に API キー、ANTHROPIC_MODEL=deepseek-flash[1m] ほか | [s5] | |
| F17 | プライバシーポリシー(2026-02-10更新):収集した情報を中華人民共和国にあるサーバーに保存する/モデルの訓練・改善に使う(訓練への利用を拒否する権利あり)。規約 4.2:入力の権利は利用者に残る | [s6] | |
| F18 | 技術レポートの限界の書き方(CSA2 の選び間違い・SWA の近似で、試していない境界で劣化の可能性)。最難関の課題ではまだ差がある | [s4] | |
| F19 | 公式の作例:Forbidden City の3Dモデル・ブラウザのレースゲーム・Godot で Portal 2 風・時代をたどる3Dシーン(発表ページのGIF) | [s1] | 選ばれた作例。成功率ではない |
※ 費用の試算(1回=入力10万+出力1万トークン、1日20回×平日22日、1ドル150円)は例で、実際の請求とは変わります。ロボット・請求書などの絵は生成イラストで、各社の製品やロゴとは関係ありません。
※ 画面の図・表・作例のコマはDeepSeekの公式資料からの引用で、加工していません。成績と費用の数字はDeepSeekが自分で測ってまとめたもの(比べた相手の点数も同じ表のもの)で、1017版の独立した評価は10月18日時点で見つかりませんでした。
※ 公式の作例はDeepSeekが選んだ例で、成功した回数などは書かれていません。「約60倍」はDeepSeekの図から読んだ目安(約0.2ドルと約12ドル)です。
※ 料金は2026年10月18日に確かめた公式の料金表で、変わることがあります。データを送る前に、DeepSeekのポリシー・規約と勤め先のルールを確認してください。