AIに「先月、抹茶大福はいくつ売れた?」と聞いたら120個と返ってきた。でも実際は400個だった――。お店のレジ、ネットショップ、物産展と、売上の表ごとに商品の名前や数え方が違うと、AIは言葉を取り違えてしまいます。
本記事では、言葉の「種類・つながり・ルール」を決めた意味の地図である「オントロジー」の基本と、書いていないことまで導く「推論」、Googleの知識グラフや医療・金融・自動車での使われ方を紹介します。そのうえで、生成AIとの3つの組み合わせ方(言葉をそろえる・ルールで確かめる・作るのを手伝ってもらう)、用語集や文章検索との違い、注意点と始め方までまとめます。
情報は2026年10月3日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- オントロジーは、言葉の種類・つながり・ルールを決めた「意味の地図」。
- 生成AIは推測が得意で、オントロジーは意味とルールが得意。組み合わせると強い。
- AIに候補を出させ、人が確かめて決める。小さく始め、変更の記録を残す。
基礎知識:オントロジーと知識グラフ・推論の仕組み
社内のデータベースや表計算のシートをAIに読ませて売上や在庫を集計させるとき、システムごとに同じ商品が「抹茶大福」「まっちゃ大福」「Matcha Daifuku」と別の書き方になっていたり、「1個」と「1箱(6個入り)」の数え方が混ざっていたりすると、AIは確率的な推測に頼って、誤った集計を返してしまいます。
こうした言葉とデータの意味のずれを解決する情報科学の技術が「オントロジー」です。オントロジーは、ある分野の、概念の種類とその上下関係(クラス)、具体的な1つ1つのもの(インスタンス)、概念どうしのつながり(プロパティ)、そして満たすべきルール(例:「和菓子」と「飲み物」は両方にはなれない、「ネットショップの1箱=6個」)を、コンピューターが厳密に扱える標準の形式(RDF・OWL・SKOS・SHACLなど)で書いたものです。
確率で文章を作る生成AIと、ルールで意味と整合性を確かめるオントロジーを組み合わせれば、AIが集計や回答をする前に言葉の定義と換算のルールをそろえたり、AIの答えにルールとの矛盾がないかを自動で確かめたりできます。
AIが売上を数え間違える
お店のAIに聞いた例(イメージ)
お店のAIに「先月、抹茶大福はいくつ売れたか」と聞くと、AIはレジの表をもとに「120個」と答えました(イメージ)。ところが、売上の表はレジだけでなく、ネットショップと物産展にもあります。
3つの売上の表(イメージ)
3つの売上の表(イメージ)
抹茶大福
お店のレジ:120個
枝豆もち
ネットショップ:30箱
ZUNDA MOCHI
物産展:100個
しかも、表ごとに商品の名前が違い、ネットショップは個数ではなく箱で数えていました。AIは「抹茶大福」と書かれたレジの表しか数えなかったのです。誰も、3つが同じ商品だとAIに教えていなかったからです。こうした言葉の意味を、AIにも分かる形で決めておく方法が「オントロジー」です。いわば、AIに言葉の意味を教える「意味の地図」です。
AIが言葉を取り違える3つのパターン
AIが取り違える3つのパターン
別の名前
同じものなのに、表ごとに名前がちがう
似ている別物
名前は似ているのに、ちがうもの
数え方
「個」で数える表と「箱」で数える表
AIが言葉を取り違えるパターンは3つあります。1つ目は、先ほどのように、同じものに表ごとに別の名前が付いているパターン。2つ目は、名前は似ているのに、実は別のものというパターンで、たとえば「抹茶大福」と「抹茶シェイク」です。3つ目は数え方の違いで、ネットショップは6個入りの箱で数えています。
人は事情を知っているので読み替えられますが、AIが見るのは表の文字だけです。AIが「たぶん同じ商品だろう」と気づくこともありますが、それは推測であり、聞き方しだいで答えが変わることもあります。お店の数字に使うには、「この3つは同じ」とはっきり決めて渡す必要があります。
オントロジーとは何か
オントロジーという言葉
哲学では
「何が存在するか」を考える学問
コンピューターでは
何があって、どうつながるかを書いたもの
出典: Gruber(1993)ほか
オントロジーは、もともと哲学の言葉で「存在論」、つまり「何が存在するか」を考える学問を指します。コンピューターの分野では、1993年に研究者のグルーバーが「概念化の明示的な仕様」と定義したことが広く知られています。[s1]ある分野に「どんなものがあって、どうつながるか」を決めて書いたもの、と考えると分かりやすいでしょう。
売上の表に意味を付ける(イメージ)
売上の表に意味をつける(イメージ)
オントロジーの部品は4つです。1つ目は「種類」で、抹茶大福・和菓子・お菓子のような、ものの種類です。種類どうしは「抹茶大福は和菓子の一種」のように上下でつながります。2つ目は「もの」で、種類ではなく、具体的な1つの対象です。3つ目は「つながり」で、「お客様は和菓子を買う」のような関係です。4つ目は「ルール」で、たとえば「和菓子と飲み物の両方にはなれない」といった決まりです。[s2]
書き方の標準(W3C)
書き方の標準(W3C)
RDF
つながりを3つ組で書く
OWL
種類とルール、推論
SKOS
用語集や分類
SHACL
データの形を確かめる
出典: W3C(OWL 2・SKOS・SHACL・RDF)
これらを書くための世界共通の標準もあります。つながりを3つ組で書くRDF、種類とルールと推論のためのOWL、用語集や分類のためのSKOS、データの形を確かめるためのSHACLです。[s2][s3][s4][s5]名前を覚える必要はありませんが、書き方が共通なので、別の会社やシステムとも意味を共有できます。[s2]
書いていないことまで分かる「推論」
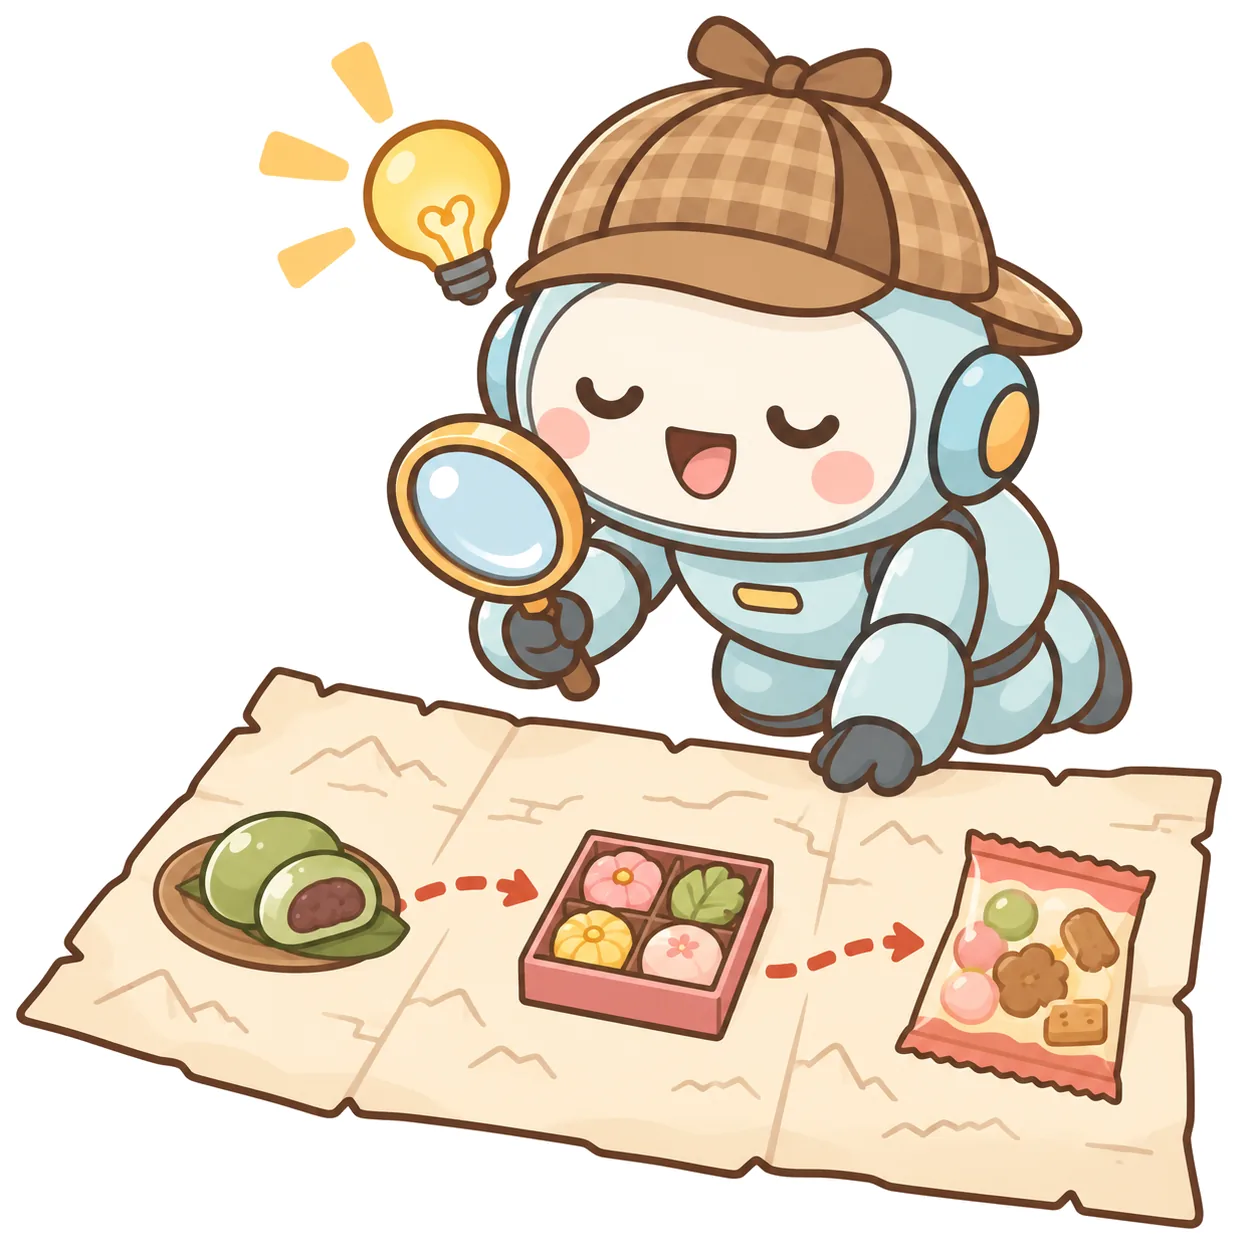
オントロジーの大きな強みが「推論」です。意味の地図のどこにも「抹茶大福はお菓子」とは書いていなくても、「抹茶大福は和菓子」「和菓子はお菓子」という2つの定義から、コンピューターが自動で導けます。[s2]そのため「お菓子の売上は?」と聞かれても、抹茶大福がきちんと含まれます。
冒頭の売上の表も、オントロジーで直せます。まず、3つの表の書き方を「抹茶大福」という1つの種類に結びつけます。名前が似ている抹茶シェイクは飲み物で、抹茶大福とは別のものだと決めておきます。そして「ネットショップの1箱は6個」という数え方のルールを書きます。すると、レジの120個、ネットショップの30箱(180個)、物産展の100個を合わせて、400個という正しい答えになります(イメージ)。
売上の例を振り返ると(イメージ)
売上の例をふりかえると(イメージ)
状況
表ごとに名前と数え方がちがう
質問
抹茶大福はいくつ売れた?
結果
3つの表の合計で400個
次の行動
来月の仕込みの量を決める
数が正しければ、来月の仕込みの量も決めやすくなります。大事なのは、AIの推測に任せるのではなく、言葉の意味を人が決めて渡していることです。
実は身近な存在 —— 検索・病院・金融・自動車
文字列ではなく「もの」(Googleの例)
文字列ではなく「もの」(Google の例)
出典: Google 公式ブログ(2012年5月16日)
この考え方は、すでに身近なところで使われています。有名な人や場所を検索すると、結果の横に表示される情報の枠がその一例で、Googleが2012年に発表した「知識グラフ」という仕組みです。[s6][s7]合言葉は「文字列ではなく、もの」で、言葉を、人や場所といった「もの」として扱います。たとえば「タージ・マハル」が、建物なのか、同じ名前の音楽家やカジノなのかを見分けます。[s6]
Google の知識グラフ(2012年の発表時点)
出典: Google 公式ブログ(2012年5月16日)
発表の時点で、知識グラフには5億以上のものと、35億以上の事実やつながりが含まれていたそうです。[s6]
さまざまな分野の「意味の地図」
いろいろな分野の「意味の地図」
医療
SNOMED CT:病名や症状など36万以上の概念
金融
FIBO:金融の取り引きや会社の関係
自動車
Catena-X:部品やCO2のデータの意味
日本の行政
デジタル庁:氏名・住所などの共通語彙
出典: SNOMED International、EDM Council、Catena-X、デジタル庁
ほかの分野でも使われています。医療では、病名や症状など36万以上の概念を持つ医療用語の体系「SNOMED CT」が80か国以上で使われています。[s8]金融では「FIBO」、自動車では部品やCO2のデータの意味をそろえる「Catena-X」があります。[s9][s10]日本でもデジタル庁が、氏名や住所などの共通の語彙やデータの形を公開しています。[s11]
AIとオントロジーの組み合わせ方
得意なことが反対
得意なことが反対
生成AI
- 文章を読み書きするのが得意
- 答えは「たぶん」
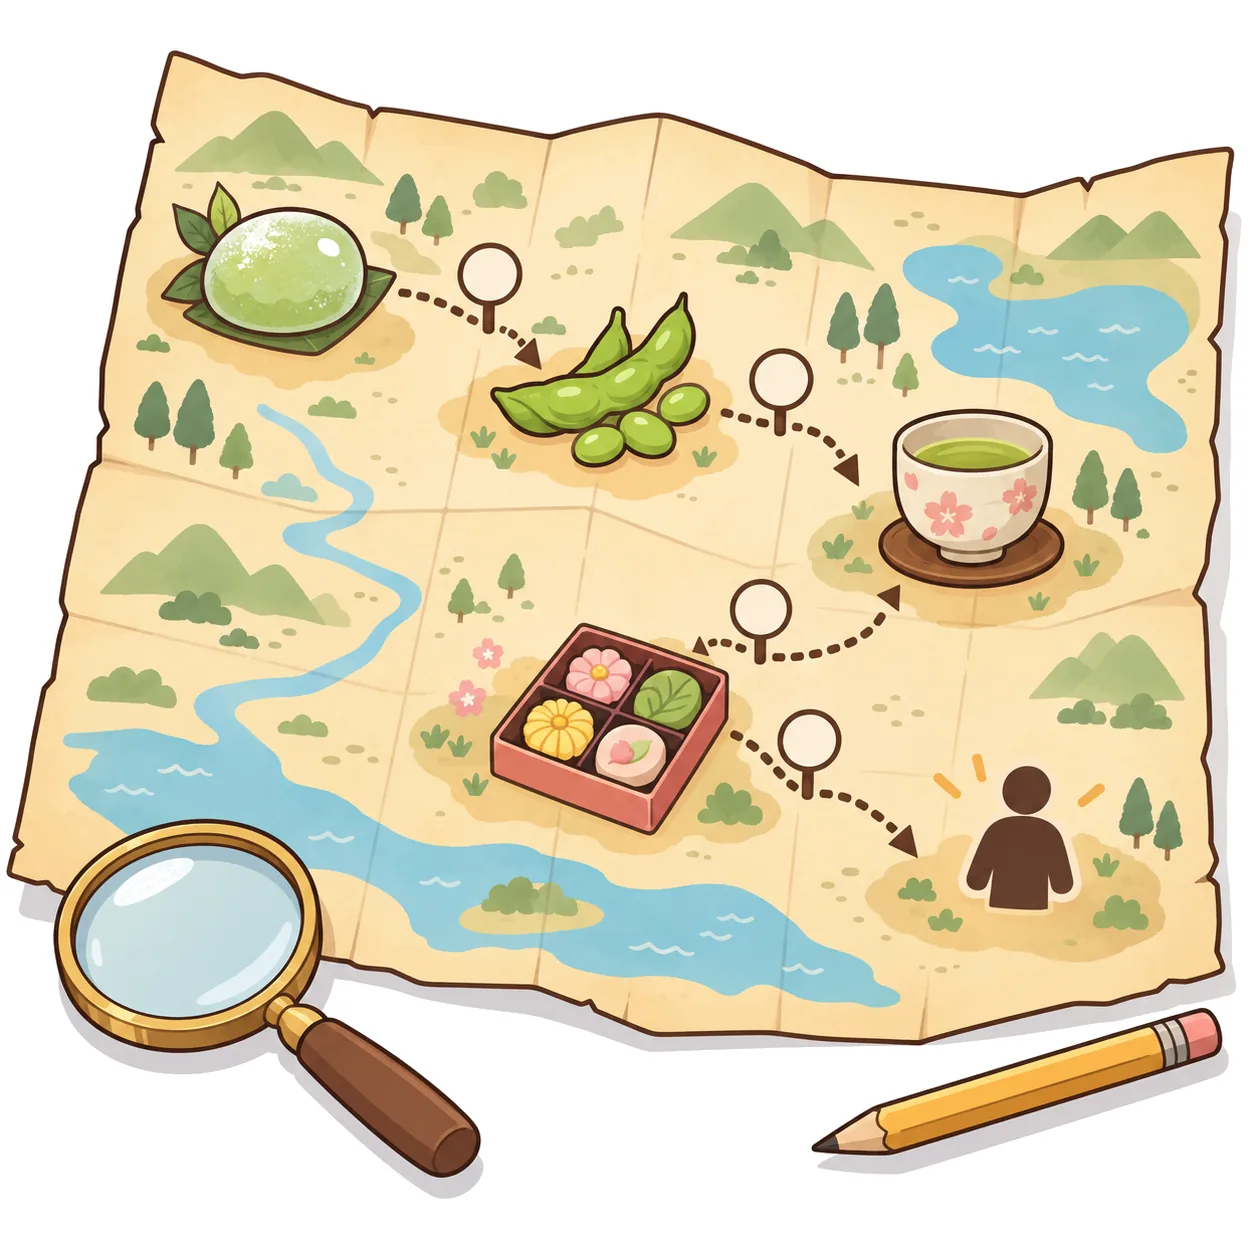
オントロジー
- 意味とルールがはっきり
- 作るのに手間がかかる
生成AIは文章の読み書きが得意ですが、答えは確率で選んだ「たぶん」です。オントロジーは意味とルールがはっきりしていますが、作るのに手間がかかります。得意なことが反対なので、組み合わせると強くなります。組み合わせ方は3つあります。
① 言葉をそろえてから答える
言葉をそろえてから答える
1つ目は、AIが答える前に、オントロジーで言葉をそろえる方法です。先ほどの売上の例がこれにあたり、AIに表と一緒に意味の地図も渡します。AIは地図で、抹茶大福の3つの書き方と、箱の数え方を確かめてから表を数えて答えるため、聞くたびに答えがぶれにくくなります。
② AIの答えをルールで確かめる(イメージ)
AIの答えをルールで確かめる(イメージ)
2つ目は、AIが出した答えをルールで確かめる方法です。たとえば新商品の「抹茶シェイク」をAIに分類させると、名前に「抹茶」が付いているので「和菓子」と答えたとします。しかし、メニューの表では「飲み物」で、ルールは「和菓子と飲み物は別」です。すると推論の道具が矛盾を見つけ、人に確認を回します。[s2]
読み取った注文の形を確かめる(イメージ)
データの形を確かめることもできます。メールで「抹茶大福を10個と、あと、いつものを」という注文が来たとき、AIが「いつもの」を商品として読み取っても、商品は地図の種類から選ぶ決まりなので、チェックで引っかかり、人に確認が回ります。[s4]
③ オントロジーづくりをAIに手伝ってもらう
AIはオントロジーのルールを見つけられる?
出典: Bakker ほか「OntoAxiom」(2025年12月)の F1 スコア(1が満点)
3つ目は、オントロジーを作る作業をAIに手伝ってもらう方法です。2025年12月の研究「OntoAxiom」は、12種類のAIにオントロジーのルールを見つけさせ、成績を比べました。満点を1とする成績で、人と交友関係の分野では上下関係を見つける成績が0.64でしたが、音楽の分野では0.22と、分野によって大きく変わりました。[s17]研究者は、完全な自動化には性能が足りないものの、専門家を助ける候補としては価値があるとまとめています。[s17]AIに候補を出させ、人が確かめて決める、というのがいまのおすすめの形です。
AIエージェントとオントロジー
AIエージェントとオントロジー(各社の説明)
Microsoft
顧客・注文などの意味を、人とAIで共有(プレビュー)
Palantir
AIが読めるもの・できる操作を、オントロジーで決める
出典: Microsoft Learn「What Is Ontology (Preview)?」、Palantir のドキュメント
会社の世界でも、AIのためにオントロジーを使う動きが広がっています。[s1][s6][s16]Microsoftは2025年11月に、会社向けのオントロジー機能をプレビューとして発表しました。顧客や注文などの意味を決め、人もAIエージェントも同じ言葉で使えるようにするものです。[s13][s19]Palantirも、AIが読めるデータや、実行できる操作をオントロジーで決めています。[s14][s15]2026年4月には、情報の「出どころ」を書きやすくする標準(RDF 1.2)づくりも進みました。[s3]AIが会社の中で働く時代だからこそ、意味の地図が見直されているのです。
用語集や文章検索との違い
言葉の意味を扱う3つの方法
言葉の意味を扱う3つの方法
| 項目 | 用語集 | 文章検索 | オントロジー |
|---|---|---|---|
| すること | 言葉の説明を書く | 似た文章を探す | 意味とつながりを決める |
| 得意 | 人が読んで分かる | すぐ始められる | 同じ・別がはっきり |
| 苦手 | 機械はたどれない | 似ているだけの別物 | 作る手間が大きい |
| ルールで確認 | × | × | ○ |
それぞれの特徴を整理(どれか1つではなく、組み合わせて使う)
言葉の意味を扱う方法には、用語集や文章検索もあります。用語集は言葉の説明を書いたもの、文章検索は社内の文書から似た文章を探してAIに渡す方法、オントロジーは意味とつながりを決めたものです。用語集は人が読みやすく、文章検索はすぐに始められます。一方で、用語集は機械がたどれず、文章検索は似ている文章は探せても、同じものか別のものかは決められません。
オントロジーは、同じか別かをはっきりさせ、ルールで確かめられる代わりに、作る手間がかかります。目的に応じて使い分けることが大切です。
注意点 —— ルールが間違うと答えも間違う
オントロジーにも注意点があります。推論はルールどおりに正しく進むため、ルールが間違っていれば、答えも間違います。たとえば「野菜でできたものは野菜」というルールを書くと、にんじんケーキまで野菜に分類されてしまいます。ルールは、人が確かめてから使う必要があります。
オントロジーの3つの注意点
オントロジーの3つの注意点
大きくしすぎ
会社全体を、一度に作らない
AIまかせ
AIに勝手に書き換えさせない
説明の範囲
AIの頭の中までは説明できない
ほかにも、気をつけたいことが3つあります。1つ目は、いきなり会社全体の地図を作ろうとしないことです。大きすぎる地図は、作るのも直すのも大変なので、答えたい質問から小さく始めます。2つ目は、AIとの会話から地図を勝手に書き換えさせないことです。間違った言葉が地図に入ると、それを使うすべての答えに広がってしまいます。変更は提案として出し、人が確かめて記録を残すのが基本です。[s13]
3つ目は、オントロジーで説明できるのは「どの知識とルールを使ったか」までだということです。AIの頭の中で、なぜその言葉を選んだのかまでは説明できません。
オントロジーの始め方
- AIに答えてほしい質問を、20〜50個書き出す
- その質問に必要な言葉・つながり・ルールだけ決める
- AIに候補を出させ、人が確かめる。変更は記録する
始めるときは、まずAIに答えてほしい質問を20〜50個ほど書き出します。次に、その質問に答えるのに必要な言葉・つながり・ルールだけを決めます。そして、AIに候補を出させ、人が確かめて決め、変更は記録に残します。
編集の道具 Protégé
Protégé(プロテジェ)
無料・オープンソースのオントロジー編集ツール
出典: Protégé 公式サイト
作るための道具として、スタンフォード大学が開発した無料・オープンソースの編集ツール「Protégé」があり、WHOの病気の分類(ICD-11)の作成にも、これをもとにした環境が使われました。[s12]
まとめ
オントロジーは、言葉の種類・つながり・ルールを決めた「意味の地図」です。[s1][s2]生成AIは推測が得意で、オントロジーは意味とルールが得意なので、組み合わせることで、AIの答えのぶれや取り違えを減らせます。
ただし、ルールが間違えば答えも間違います。AIに候補を出させて人が確かめて決め、答えたい質問から小さく始めて、変更の記録を残していくことが大切です。[s17]
実践のポイント・まとめ
AIに売上を聞いたら数がおかしい
表ごとに商品の名前や数え方が違うと、AIは一部しか数えないことがあります。「この3つは同じ商品」「ネットショップの1箱は6個」のように、意味とルールをAIにも分かる形で決めて渡しましょう。
オントロジーとは結局何か
言葉の種類・つながり・ルールを決めた「意味の地図」です。「抹茶大福は和菓子」「和菓子はお菓子」と決めておけば、「抹茶大福はお菓子」と書いていなくても自動で分かります。これを推論と呼び、AIの推測を決めた意味で支えます。
AIの時代に意味の地図はもう不要?
むしろ大事になっています。AIが「卵を使っていないお菓子」をすすめるとき、材料のルールと照らし合わせれば、ルール違反に気づいてすすめ直せます。ただし、アレルギーのような大事なことは、最後にお店の人にも確かめましょう。
検索結果の横に出る枠の正体
Googleが2012年に発表した「知識グラフ」で、言葉を文字列ではなく、人や場所といった「もの」として扱います。ものの種類とつながりを決めるこの考え方がオントロジーで、医療用語や金融、自動車の部品のデータでも使われています。
ルールを間違えるとどうなる?
推論はルールどおりに進むため、ルールが間違えば答えも間違います。「野菜でできたものは野菜」と書けば、にんじんケーキまで野菜になってしまいます。ルールは人が確かめてから使いましょう。
出典・参考文献
- [s1] Thomas R. Gruber「A Translation Approach to Portable Ontology Specifications」Knowledge Acquisition 5(2), 1993 ↗ tomgruber.org
- [s2] W3C「OWL 2 Web Ontology Language Document Overview (Second Edition)」W3C 勧告(2012-12-11) ↗ w3.org
- [s3] W3C「RDF 1.2 Concepts and Abstract Data Model」勧告候補スナップショット ↗ w3.org
- [s4] W3C「Shapes Constraint Language (SHACL)」W3C 勧告(2017-07-20) ↗ w3.org
- [s5] W3C「SKOS Simple Knowledge Organization System Reference」W3C 勧告(2009-08-18) ↗ w3.org
- [s6] Google「Introducing the Knowledge Graph: things, not strings」(2012-05-16) ↗ blog.google
- [s7] Google for Developers「Knowledge Graph Search API」 ↗ developers.google.com
- [s8] SNOMED International「What is SNOMED CT?」 ↗ snomed.org
- [s9] EDM Council「FIBO(Financial Industry Business Ontology)」 ↗ spec.edmcouncil.org
- [s10] Catena-X「CX-0003 SAMM Semantic Aspect Meta Model」 ↗ catena-x.net
- [s11] デジタル庁「政府相互運用性フレームワーク(GIF)」 ↗ digital.go.jp
- [s12] Stanford「Protégé」 ↗ protege.stanford.edu
- [s13] Microsoft Learn「What Is Ontology (Preview)? - Microsoft Fabric」 ↗ learn.microsoft.com
- [s14] Palantir「Ontology overview」 ↗ palantir.com
- [s15] Palantir「Ontology MCP」 ↗ palantir.com
- [s16] Giglou, D'Souza, Auer「LLMs4OL: Large Language Models for Ontology Learning」ISWC 2023 ↗ arxiv.org
- [s17] Bakker ほか「Ontology Learning with LLMs: A Benchmark Study on Axiom Identification(OntoAxiom)」 ↗ arxiv.org
- [s19] Directions on Microsoft「CIO Talk: Microsoft Gets IQ」 ↗ directionsonmicrosoft.com
検証ファクト一覧を表示する(全25項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | 情報科学のオントロジーは、ある分野の「概念(種類)」「関係」「ルール」を、機械が扱える形ではっきり書いたもの。Gruber(1993)の定義「概念化の明示的な仕様」がよく引かれる | [s1] | |
| F2 | Gruber の目的は、AI システムの間で知識を共有・再利用するために、共通の語彙(クラス・関係・関数などの定義)を決めること | [s1] | |
| F3 | OWL 2 は「形式的に定義された意味を持つ」オントロジー言語。クラス・個体・プロパティ・公理を組み合わせ、書いていないことを推論で導ける。2012年12月11日に W3C 勧告(第2版) | [s2] | |
| F4 | 部品:クラス(種類)・個体(具体的なもの)・プロパティ(関係・属性)・階層(上位/下位)・公理(ルール)・推論 | [s2] | |
| F5 | データベースの表は「どう保存するか」、オントロジーは「何を意味するか」を共有する。同じ顧客を customer / client と別名で呼ぶ2つのシステムでも、意味の関係(同じ・含む・違う)を書ける | [s13] | |
| F6 | RDF:「主語・述語・目的語」の3つ組でつながりを書く基本形 | [s3] | |
| F7 | SKOS:用語集・分類体系(上位語・下位語・言いかえ)を書く標準。2009年8月18日 勧告 | [s5] | |
| F8 | SHACL:データが決まった形(必須項目・型・個数)を満たすか検査する標準。2017年7月20日 勧告 | [s4] | |
| F9 | RDF 1.2:2026年4月7日に「勧告候補」。3つ組そのものを別の文の中で使える(triple terms)ので、「この情報はどの資料から・誰が出したか」を書きやすくなる | [s3] | 2026年10月時点で正式な勧告ではない |
| F10 | Google は2012年5月16日に「Knowledge Graph(知識グラフ)」を発表。「文字列ではなく、もの(things, not strings)」。発表時点で5億以上のもの、35億以上の事実と関係 | [s6] | 数字は2012年の Google の発表 |
| F11 | 例:「タージ・マハル」が建物・音楽家・カジノのどれかを見分ける。検索結果の横に出る情報の枠 | [s6] | |
| F12 | Knowledge Graph Search API は schema.org の型(Person・Place・Organization など)と JSON-LD を使う | [s7] | |
| F13 | SNOMED CT:世界の医療用語の体系。国際版で36万以上の概念、80か国以上で使われている。概念・説明・関係でできている | [s8] | SNOMED International の説明 |
| F14 | WHO の国際疾病分類 ICD-11 は、WebProtégé をもとにした環境で作られた。Protégé は無料・オープンソースのオントロジー編集ツール(Stanford) | [s12] | |
| F15 | FIBO:金融業界のオントロジー。金融の業務で扱う「もの」と、その関係を定義。OWL で作られ、EDM Council が運営 | [s9] | |
| F16 | Catena-X:自動車業界のデータ連携。部品やCO2排出量のデータの「意味」を共通の意味モデル(SAMM のアスペクトモデル)で決める | [s10] | |
| F17 | 日本でもデジタル庁が「政府相互運用性フレームワーク(GIF)」で、氏名・住所などの共通語彙やデータモデルのひな形を公開(2022年〜、最終更新2026年3月) | [s11] | |
| F19 | Microsoft Fabric IQ の Ontology(プレビュー):顧客・製品・注文などの概念、属性、関係、ルールを決め、会社のデータにつないで、人とアプリと AI エージェントが同じ語彙と文脈を使えるようにする | [s13] | 2025年11月の Ignite で発表 [s19]。2026年10月時点もプレビュー |
| F20 | Fabric の ontology agent は、変更を「提案」として出し、人が確認してから反映する(proposal-first) | [s13] | |
| F21 | Palantir:Ontology を組織の「operational layer」と説明。データを、現実の「もの(オブジェクト)・つながり(リンク)・操作(アクション)」に結びつける | [s14] | |
| F22 | Palantir の Ontology MCP:AI エージェントがオブジェクトを読む・決められた操作を実行する・データを問い合わせる。できる操作はアプリ側の制限と権限でしぼる | [s15] | |
| F23 | LLMs4OL(ISWC 2023):用語の種類分け・上下関係の発見・それ以外の関係の抽出を、9系統の LLM で評価(WordNet・GeoNames・UMLS) | [s16] | |
| F24 | OntoAxiom(2025年12月):9つのオントロジー(3つ組 17,118・公理 2,771)で12の LLM をテスト。公理を1つずつ聞く方法が、まとめて聞くより良かった | [s17] | |
| F25 | 成績は分野で大きく違う:上下関係(サブクラス)の F1 は、人と交友関係のオントロジー(FOAF)で 0.642、音楽のオントロジーで 0.218 | [s17] | |
| F26 | 著者の結論:完全に自動化するには性能が足りない。ただし、専門家を助ける「候補」として価値がある | [s17] |
※ 記事中のお店の例(レジ・ネットショップ・物産展の売上の表、120個・400個、抹茶シェイク、メールの注文など)のやりとりや数値はイメージです。
※ 卵アレルギーの例はイメージです。アレルギーについては、必ずお店の人に確認してください。
※ 研究の成績(OntoAxiom の F1 スコア 0.64・0.22)は論文(2025年12月)の値で、AIの種類や条件によって変わります。
※ Google の知識グラフの数字は2012年の発表時点のものです。Microsoft Fabric の Ontology は2026年10月時点でプレビューです。各社の製品の説明は公式ドキュメントにもとづきます。
※ ロボットや画面のイラストはイメージで、特定の会社の製品やロゴとは関係ありません。