AIがその場で作った世界を、キーボードで歩き回れる――。GoogleのGenie 3のデモは、ゲームのように見えますが、実際には「ワールドモデル」と呼ばれるAIの研究です。ワールドモデルは、世界の今の状態と、行動したらどう変わるかを予測するAIモデルを指します。
本記事では、コップを押す例からワールドモデルの考え方を説明し、ChatGPTなどのLLMとの違い、仕組みを整理します。そのうえで、Google DeepMindのGenie 3、MetaのV-JEPA 2、NVIDIAのCosmos 3、Minecraftで「想像の中の練習」だけでダイヤモンドを取ったDreamer 4を紹介し、使い道と、「リアルに見えること」と「物理的に正しいこと」は別だという限界、ニュースの見方までまとめます。
情報は2026年10月16日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- ワールドモデルは、行動したら世界がどう変わるかを予測するAI。
- Google・Meta・NVIDIAの3社は、それぞれ重点の置き方が違う。
- 映像がリアルに見えることと、物理的に正しく予測できることは別。
基礎知識:ワールドモデルとLLMの違い
「ワールドモデル(世界モデル)」は、現実の世界や3Dの空間について、物理の法則・物の配置・時間による変化を学び、「いまの状態からある行動をとったら、次に世界がどう変わるか」を予測するAIモデルです。Google DeepMindの「Genie 3」、Metaの「V-JEPA 2」、NVIDIAの「Cosmos 3」などが代表例です。
ChatGPTなどの大規模言語モデル(LLM)が、文章の流れから次の言葉を予測するAIであるのに対し、ワールドモデルは、空間の状態と行動から次の状態を予測するAIです。ロボットや自動運転車、ゲームの中のAIが、危険な動作を実際に試す前に、頭の中で何通りもの結果を予測し、安全で目的に合った行動を選べるようになります。
作り方には大きく2つの考え方があります。Genie 3のように、操作に合わせて未来の映像のコマを直接作っていく方法と、V-JEPA 2のように、映像の細部を省いて物の位置や動きといった要点(潜在空間)の上だけで未来を予測する方法です。
AIが作った世界を歩く
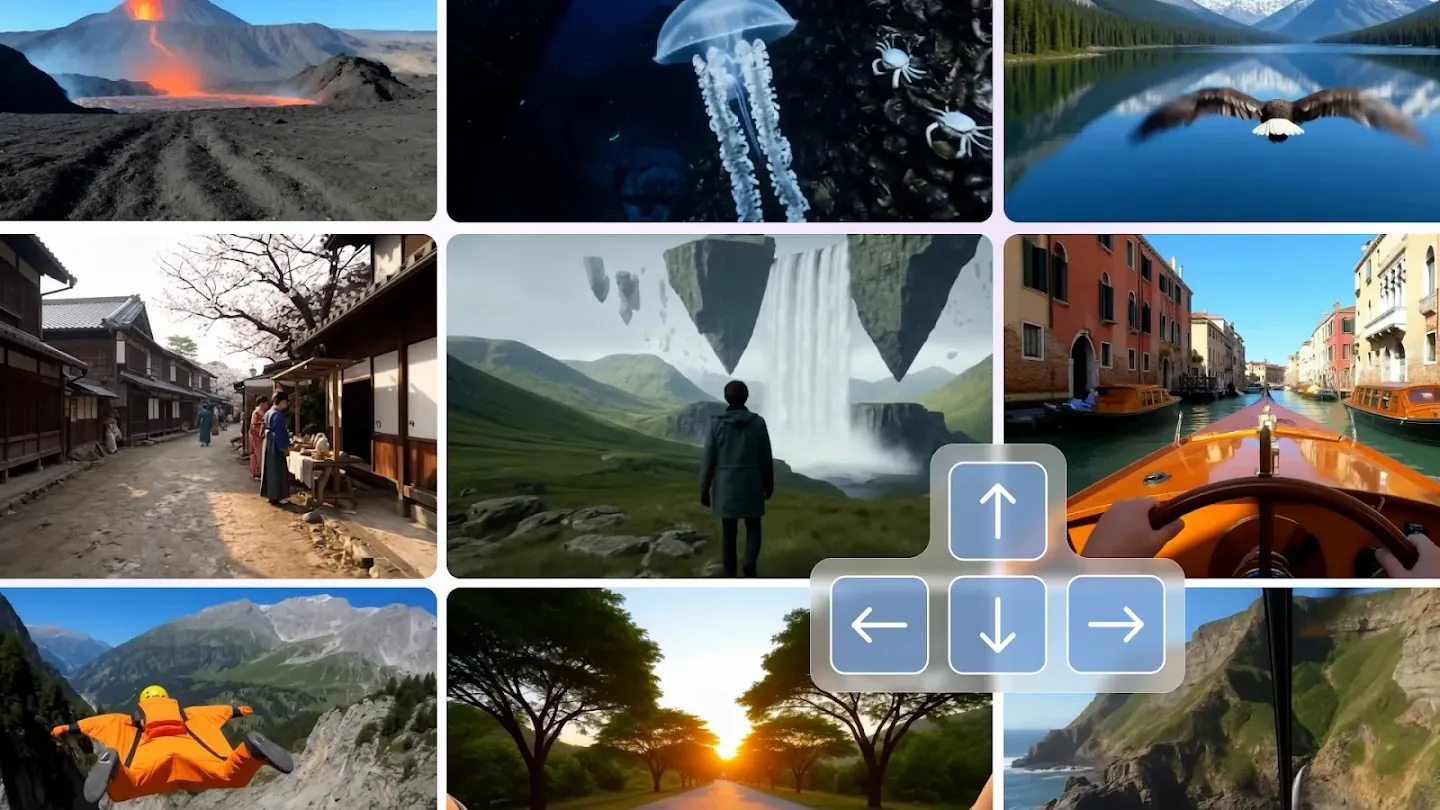
- 矢印キーで動かせる
- AIがその場で作った映像
この映像はゲームではありません。GoogleのAIが、矢印キーの操作に合わせて、世界の続きをその場で作り出しています。[s1]この技術が、いま注目されている「ワールドモデル」です。ロボットやAIエージェントの将来にも関わる、重要な研究分野です。
ワールドモデルとは何か
押す前に、結果を想像する
押す前に、結果を想像する
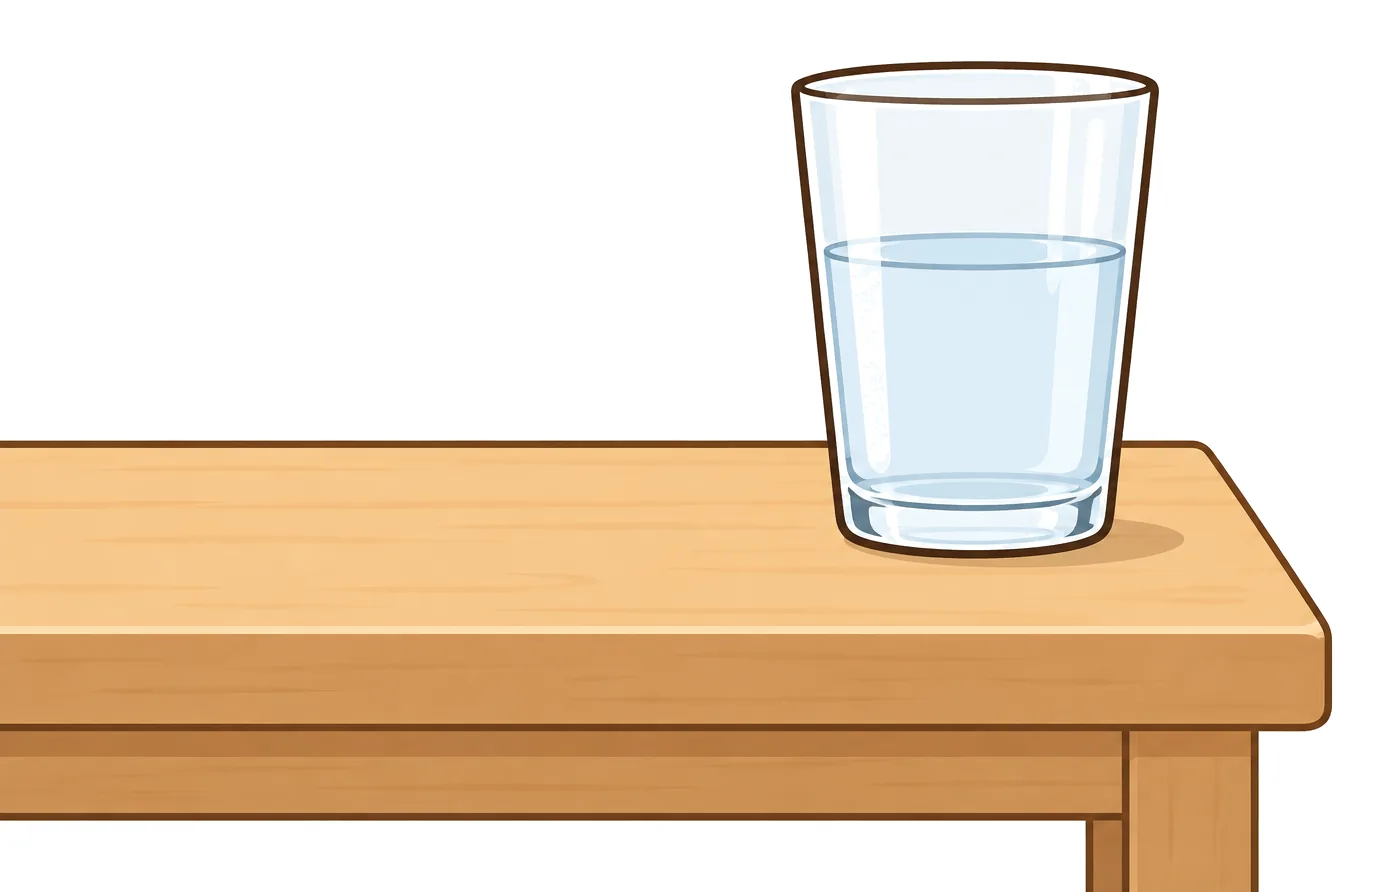
いま
コップが立っている
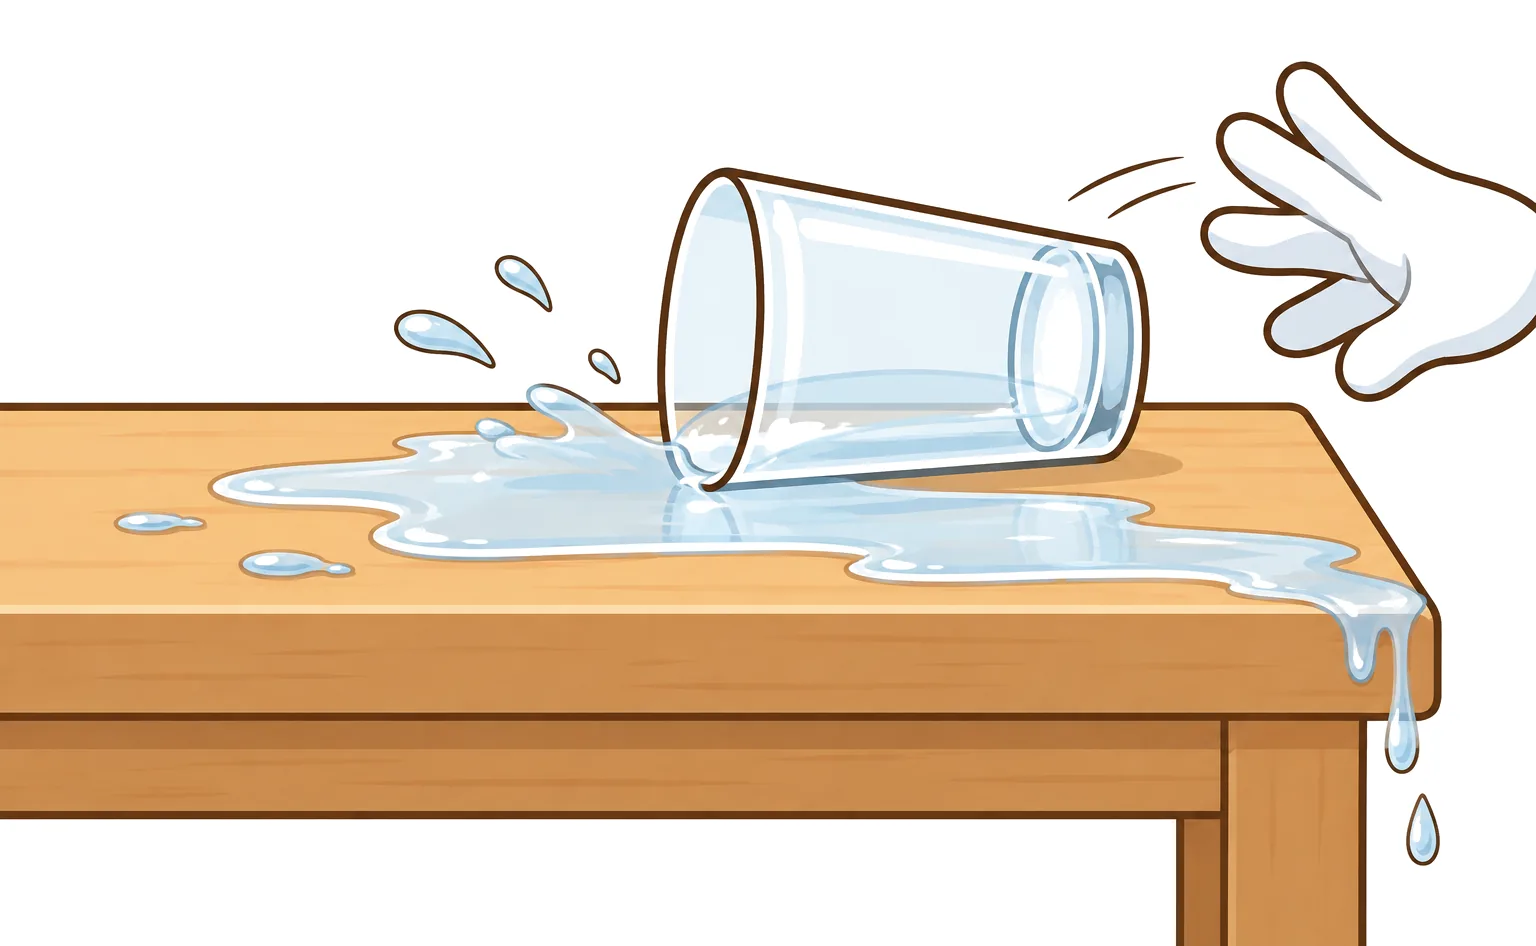
押すと
倒れて水がこぼれる
つかむと
こぼさず持てる
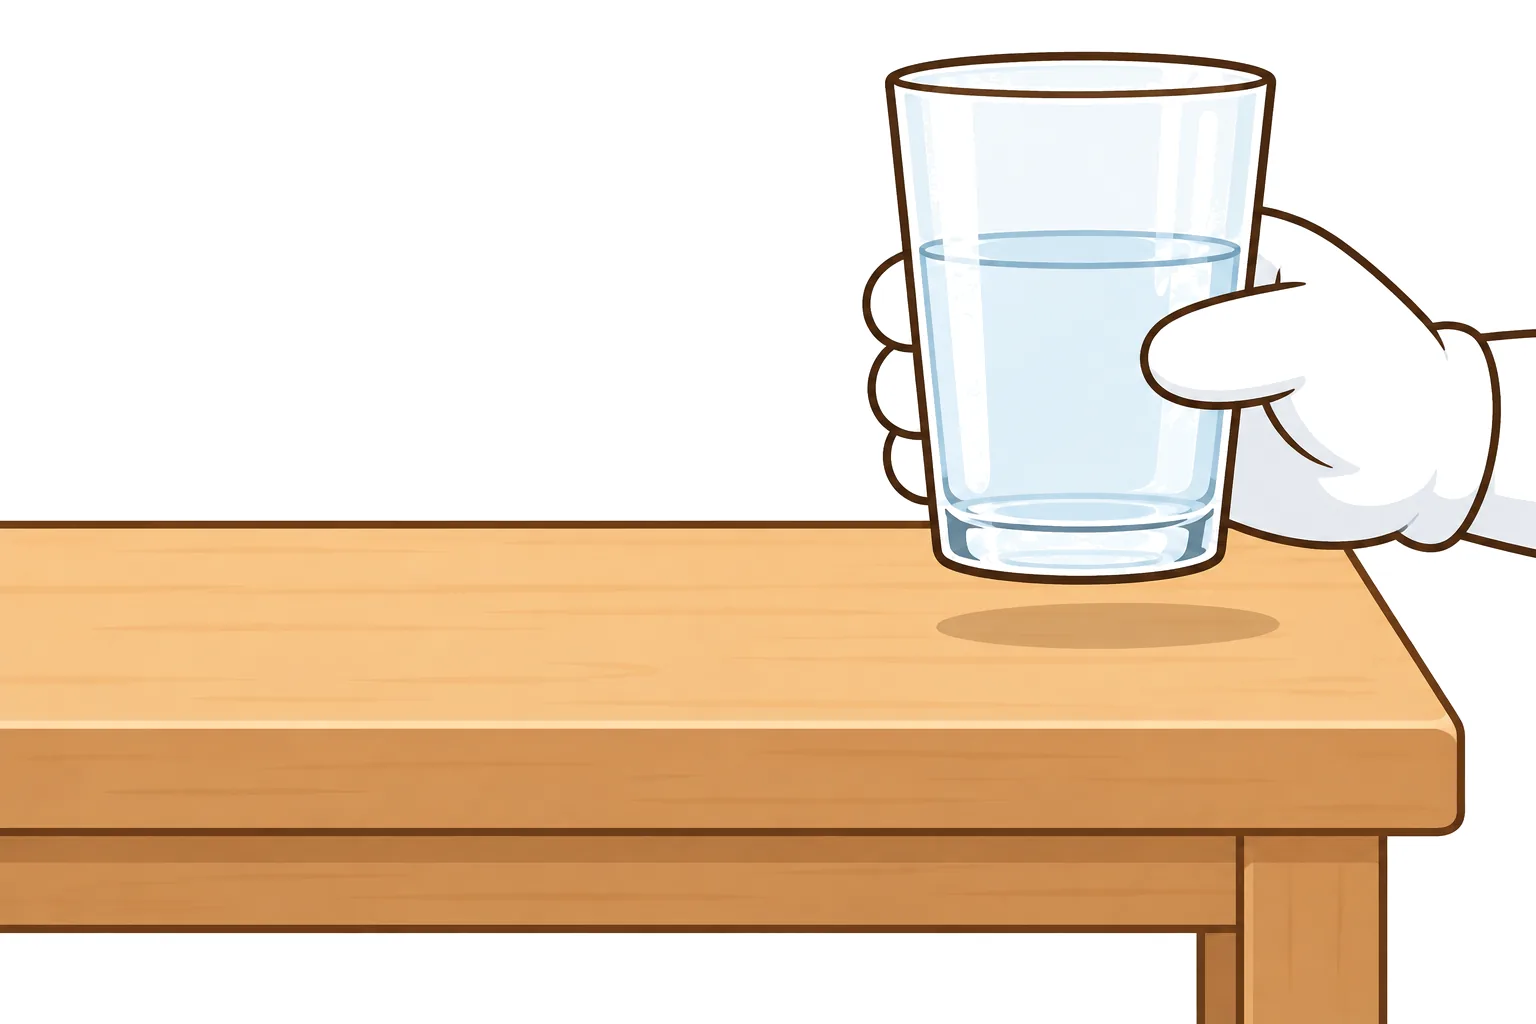
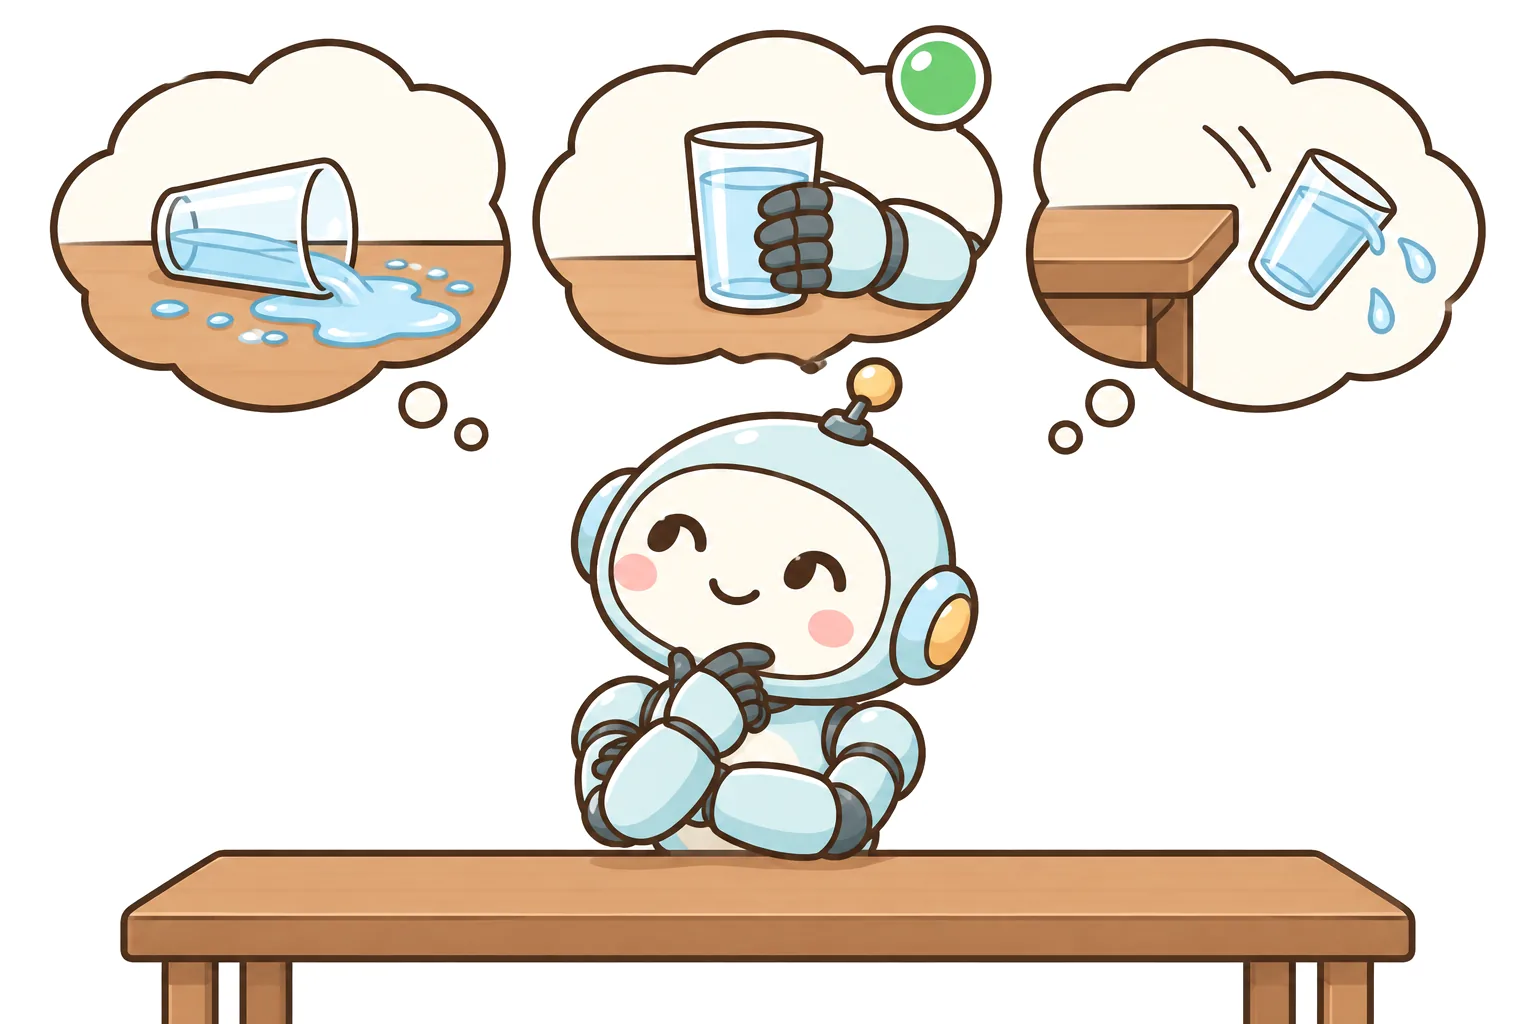
テーブルの端にあるコップを横から押したらどうなるか、と聞かれれば、多くの人は「倒れて水がこぼれる」と答えるでしょう。まだ押していないのに、結果を想像できるのです。そっとつかめばこぼさずに持てることも、頭の中で分かります。いくつもの行動の結果を予測できれば、失敗しにくい行動を選べます。
世界の変わり方を予測するAI
ワールドモデルは、この「行動する前に結果を予測する」ことをAIに持たせたものです。Google DeepMindは、環境がどう変わるかと、自分の行動がそれにどう影響するかを予測できるAIと説明しています。[s1]
ワールドモデルに必要な3つの力
ワールドモデルに必要な3つの力(Metaの説明)
理解
物や動きを見分ける
予測
世界がどう変わるか
計画
目標への行動を決める
Metaは、ワールドモデルに必要な力として3つを挙げています。見えている物やその動きを見分ける「理解」、世界がどう変わるか、自分が動いたらどうなるかを考える「予測」、そして目標に向かって行動の順番を決める「計画」です。[s3]
ChatGPTとの違い
LLM
- 文章で答える
- 言葉の知識と推論
ワールドモデル
- 変化を予測する
- 映像や行動から学ぶ
ChatGPTのようなLLMも、言葉の上で物の動きを推論することはできます。ただ、映像やロボットの動きから次の状態を細かく予測するのは、別の仕事です。
組み合わせて使う
組み合わせの例
両者は組み合わせて使うこともできます。たとえば、言葉で示された目的をLLMが理解し、ワールドモデルで行動の結果を試してから、選んだ動きを実行する、という使い方です。ワールドモデルが登場しても、LLMが不要になるわけではありません。
AIの頭の中の仕組み
ワールドモデルを使うAIのくり返し
ワールドモデルを使うAIのくり返し
今の世界を知る
動いたらどうなる?
よい未来を選ぶ
やって、また見る
ワールドモデルを使うAIは、大きく4つのことをくり返します。まず、物の位置や動き、周りの様子を見て、いまの世界を知ります。次に、押す・つかむ・進むといった行動をとったらどうなるかを予測します。そして、予測した未来を比べて、安全で目標に近いものを選び、実際に動きます。動いたら結果をまた見て、くり返します。
2つの作り方
映像を作る
- Genie 3・Cosmos 3
- コマを作って未来を見せる
要点を予測する
- V-JEPA 2
- 要点の変化で計画する
作り方は大きく2つに分けると分かりやすくなります。[s1][s3][s5]1つは、映像のコマを作って未来を見せる方法で、Genie 3やCosmos 3がこちらにあたります。もう1つは、映像の要点だけを数値にした「潜在空間」の中で変化を予測し、計画に使う方法で、V-JEPA 2がこちらです。動画を1コマずつすべて作るのは計算が重いため、要点の中で予測する方法が考えられています。[s3]
Google —— Genie 3
Genie 3の仕様(Googleの発表)
Genie 3 の仕様(Googleの発表)
出典: Google DeepMind「Genie 3」(2025年8月5日)
冒頭の世界を作ったのが、GoogleのGenie 3です。文章で説明した世界をその場で作り、その中を動き回れます。Googleの発表では、1秒に24コマ、画質は720pで、世界の一貫性が数分ほど続きます。[s1]
一貫性とは
- 0:00 左にあった木
- 0:40 戻っても同じ位置
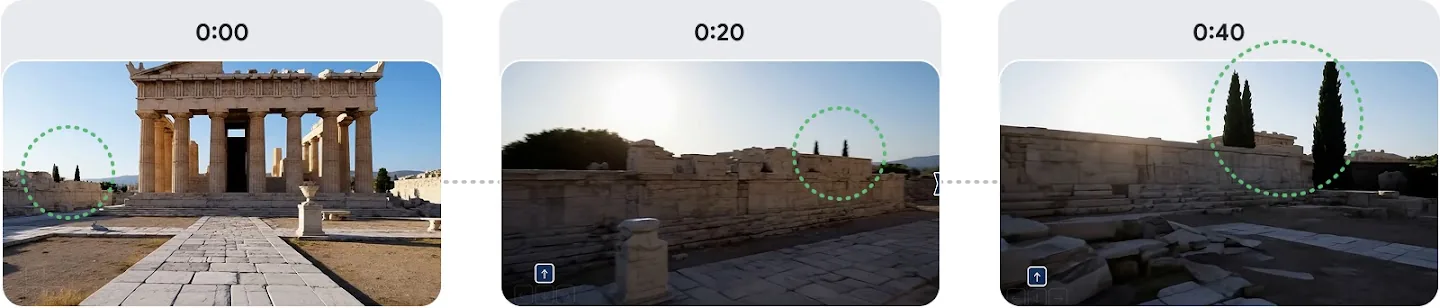
ここでいう一貫性とは、見ていた物がいったん視界の外に出て戻ってきても、同じ場所にあることです。図では、0:00の時点で左にあった木が、0:40でも同じ位置にあります。Genie 3は、直前の約1分の様子を見ながら次のコマを作っています。[s1]なお、Googleの説明によれば、Genie 3は3Dの形を持っておらず、操作に合わせて1コマずつ作っています。[s1]
Project Genieで試せること
Project Genie でできること(Googleの発表)
世界を作る
文章や画像から
探索する
歩く・飛ぶ・運転
リミックス
ほかの世界を作り変える
2026年1月には「Project Genie」として、文章や画像から世界を作って歩く・飛ぶ・運転するなどで探索できるようになりました。[s2]ただし、発表時点では米国のGoogle AI Ultraの購読者向けの試作品で、1回の生成は60秒までです。操作が遅れることもあります。[s2]
Meta —— V-JEPA 2
- 動画100万時間と画像100万枚
- ロボットのデータは62時間
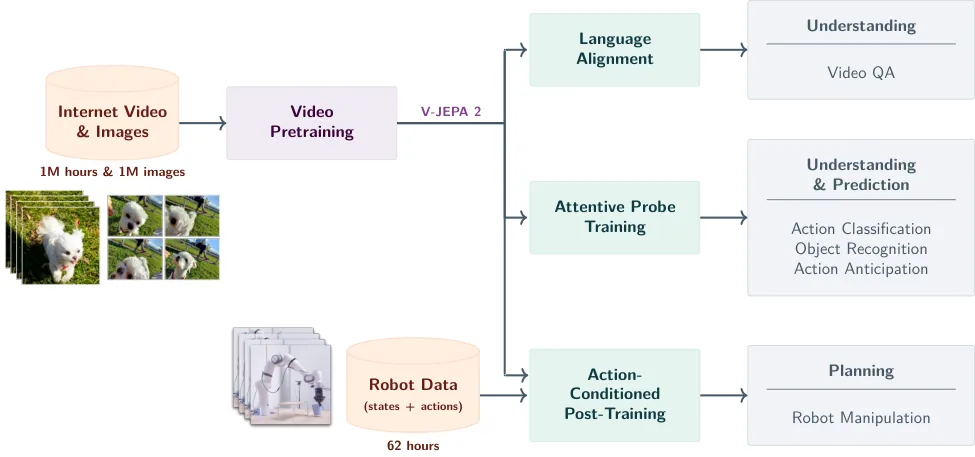
MetaのV-JEPA 2は、動画から世界の動きを学び、ロボットの計画に使うモデルです。まず、ラベルのない動画100万時間以上と画像100万枚で、世の中の動きを学びます。そのうえで、ロボットの映像と操作のデータを62時間分だけ追加で学びます。ロボットが働く場所のデータは不要だと、Metaは説明しています。[s3]
V-JEPA 2の計画のくり返し
V-JEPA 2 の計画のくり返し
ロボットを動かすときは、ゴールを画像で渡します。V-JEPA 2は、いまの様子とゴールを見比べ、動きの候補を何通りも頭の中で予測して、ゴールにいちばん近づくものを選びます。そして1手だけ動いたら、また様子を見て計画し直します。[s3]
V-JEPA 2の成績
V-JEPA 2 の数字(Metaの発表)
出典: Meta AI(2025年6月11日)。成功率は新しい物体・環境での研究室の実験
Metaの研究室での実験では、初めて見る物や場所で、物をつかんで置く作業の成功率は65〜80%でした。[s3]裏を返せば2〜3割は失敗しており、Metaも、もっと長い作業の計画はこれからの課題だとしています。[s3]
NVIDIA —— Cosmos 3
- 映像を見て理解
- いくつもの未来を考える
- 選んだ動きを実行
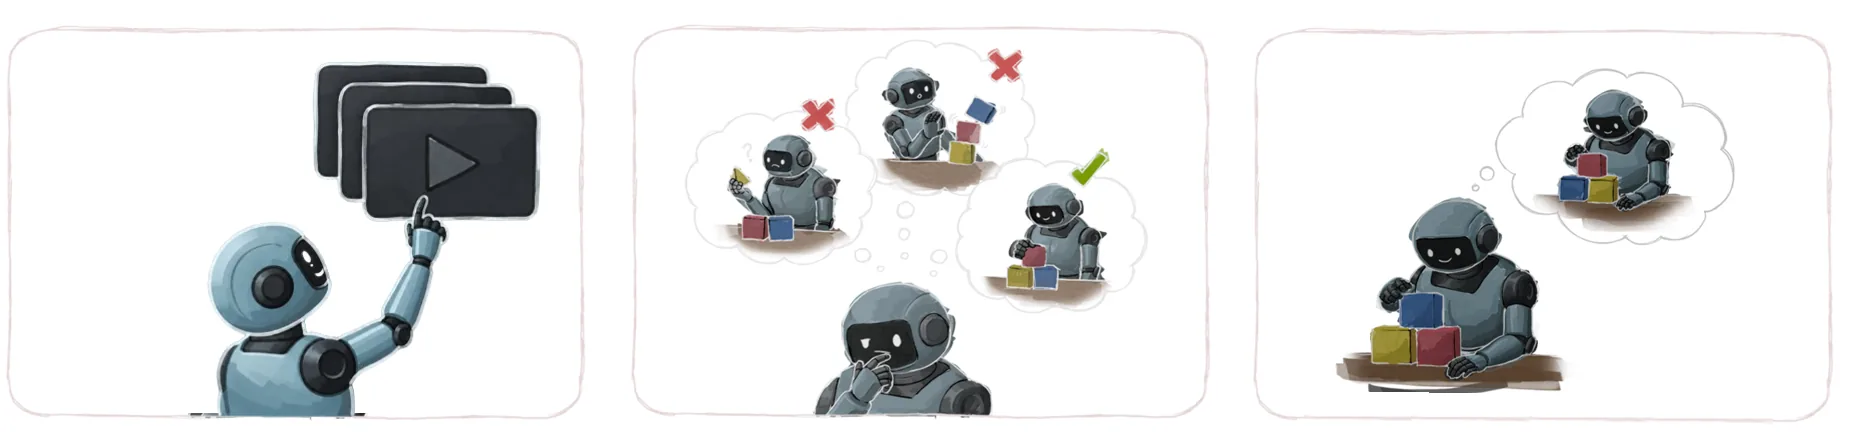
NVIDIAは2026年5月31日に、Cosmos 3を発表しました。NVIDIAはこれを「考えてから動く」AIと説明しており、映像を見て理解し、いくつもの未来を考えて良いものを選び、選んだ動きを実行する流れを示しています。[s5]
Cosmos 3がまとめて扱うもの
Cosmos 3 がまとめて扱うもの(NVIDIAの発表)
文章
質問や指示
画像・動画
見て理解、作る
音
まわりの音
行動
ロボットの動き
Cosmos 3は、文章・画像・動画・音に加えて、ロボットの関節の角度やつかむ位置といった「行動」を表す数値まで、まとめて扱えます。NVIDIAはこれを、世界初の完全にオープンな「オムニモデル」と呼んでいます。[s5]
Cosmos 3 を使い始めている会社(NVIDIAの発表)
ロボット
Agile Robots・Skild AI など
自動運転
Li Auto
街・工場のカメラ
Linker Vision など
NVIDIAによると、ロボットや自動運転などの会社がすでに使い始めています。また、訓練と評価にかかる期間を「月から日へ」縮められると説明していますが、発表には裏づけの数字が載っていません。第三者の検証ではなく、会社の主張として受け止めておく必要があります。[s5]
3社の方向性の違い
3社の方向性のちがい
| 項目 | Meta | NVIDIA | |
|---|---|---|---|
| 重点 | 操作できる世界 | 理解と計画 | ロボット向け |
| 出すもの | 映像 | 要点の予測 | 映像・行動など |
| 見どころ | 数分の一貫性 | 62時間で動く | モデル公開 |
出典: Google DeepMind・Meta・NVIDIAの発表。同じ条件で比べた表ではありません
3社は、重点の置き方が異なります。Googleは操作できる世界を作ること、Metaは理解と行動の計画、NVIDIAはロボットなどに向けた土台となるモデルに力を入れています。[s1][s3][s5]同じ条件で比べたものではないため、どれが優れているとは言えません。
Dreamer 4 —— 想像の中で練習する
もう1つの研究例がDreamer 4です。Minecraftで、本物のゲームの環境に一度も触れずに、ダイヤモンドを取ったAIです。人のプレイ動画(約2,500時間)と操作の記録だけからゲームの世界のモデルを作り、そのモデルの中でAIが何度も練習しました。論文はこれを「想像の中での訓練」と呼んでいます。[s8]ロボットでは、実機での失敗が故障や危険につながるため、この考え方は重要です。
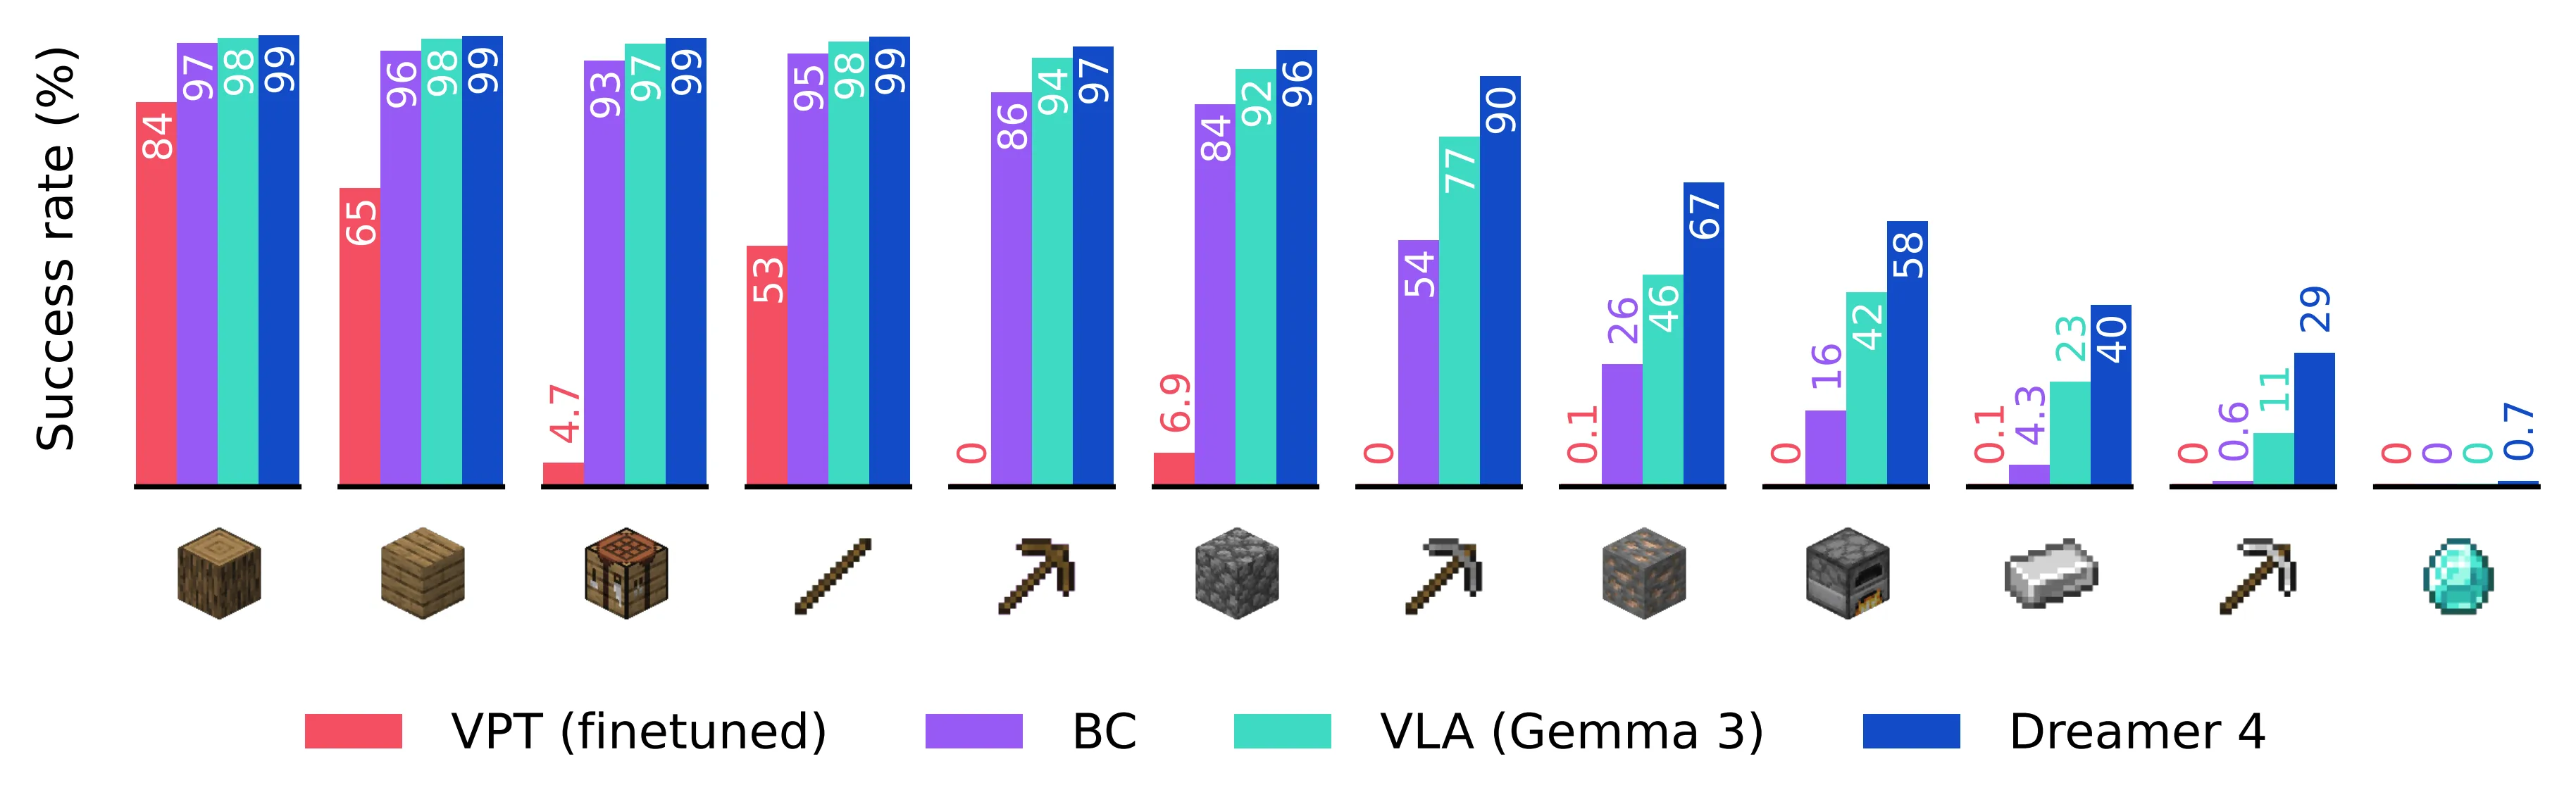
- 鉄のつるはし 29%
- ダイヤモンド 0.7%
1000回の挑戦のうち、鉄のつるはしまで届いたのは約29%、ダイヤモンドまで届いたのは0.7%でした。[s8]数字は小さく見えますが、2万回以上の操作を画面の映像だけから選ぶ難しい課題で、ここまで届いたのは初めてです。[s8]
ほかの手法との比較
鉄のつるはしまで届いた割合(論文の実験)
出典: Hafner ほか(Dreamer 4、2025年9月)の図。Minecraft・1000回の挑戦
同じデータで学んだ別の手法(VLA)は、鉄のつるはしまで届いたのが11%でした。[s8]ただし、これはゲームでの実験であり、ロボットでの結果ではありません。[s8]
生活はどう変わるか
ワールドモデルの使い道(研究・開発中)
ワールドモデルの使い道(研究・開発中)
自動運転
まれな場面を練習
家庭のロボット
失敗を減らす練習
工場・倉庫
動かす前に試す
AIエージェント
結果を見てから動く
考えられる使い道は、主に4つあります。いずれも研究・開発中の段階です。1つ目は自動運転で、WaymoはGenie 3を土台にしたモデルを発表し、竜巻やゾウが道路に現れるような、実際には集めにくい場面を作れると説明しています。ただし、Waymoの発表には第三者の評価の数字は載っていません。[s9]
2つ目は家庭のロボットです。家の中は予想外のことばかりで、家事をすべて任せられるようになるには、まだ研究が必要です。それでも、実機で失敗するリスクやコストを減らせる可能性があります。3つ目は工場や倉庫で、実際に動かす前に操作を試せるかもしれません。NVIDIAは、ロボットの会社が行動のデータ作りにCosmos 3を使っていると発表しています。[s5]
4つ目はAIエージェントです。Google DeepMindは、3Dの世界で動くAI「SIMA」に、Genie 3が作った世界の中で目標を与える実験を行いました。[s1]
いまの限界
こうした研究があっても、ワールドモデルが世界の物理を理解したとは、まだ言えません。きれいな映像を作ることと、物理的に正しい未来を予測することは別の問題だからです。
Genie 3の限界(Googleの説明)
Genie 3 の限界(Googleの説明)
行動が限られる
直接できる行動の範囲
実在の場所
地理を完全には再現しない
続く時間
数分で、数時間ではない
Google自身も、Genie 3の限界を挙げています。AIが直接とれる行動の範囲はまだ限られていること、実在の場所を完全な地理の正確さでは再現できないこと、そして続けられるのは数分で、数時間ではないことです。[s1]
物理のルール違反を見抜くテスト
物理のルール違反を見抜くテスト
人
ほぼ満点
動画のAI
偶然に近い成績
出典: Meta AI(2025年6月11日)。動画のAIは当時のモデル
Metaが公開した、物理のルールを破る場面を見抜くテストでは、人はほぼ満点だったのに対し、当時の動画のAIは偶然に近い成績でした。[s3]
物理シミュレーターとの違い
物理シミュレーターとのちがい(一般的な整理)
| 項目 | シミュレーター | ワールドモデル |
|---|---|---|
| しくみ | 人が式を書く | 映像から学ぶ |
| 得意 | 書いた範囲は正確 | 幅広い場面 |
| 苦手 | 書いてない所 | 物理の保証なし |
昔からある物理シミュレーターとの違いも整理しておきます。物理シミュレーターは、人が式を書いて動かすため、書いた範囲では正確です。ワールドモデルは映像や行動から学ぶため、幅広い場面を作れますが、物理の正しさは保証されません。どちらが上というより、役割が違います。現在は、LLMや画像も読めるAIとワールドモデルを組み合わせる方法が注目されています。
ニュースの見方
ワールドモデルのニュースの見方
長さ・画質・何回の実験か
ゲーム・シミュレーション・実機
会社の発表か、第三者か
ワールドモデルのニュースを見るときは、3つの点に気をつけるとよいでしょう。1つ目は条件で、映像の長さや画質、何回の実験の結果かを確かめます。2つ目は、どこでの話かで、ゲームなのか、シミュレーションなのか、本物のロボットなのかを見ます。3つ目は、誰の評価かで、会社の発表なのか、第三者の検証なのかを区別します。
実際に試してみたい人は、モデルが公開されているV-JEPA 2とCosmos 3から始めることができます。[s3][s5]
まとめ
ワールドモデルは、行動したら世界がどう変わるかを予測するAIです。Googleは操作できる世界の生成、Metaは理解と計画、NVIDIAはロボット向けの土台と、3社は重点の置き方が異なります。[s1][s3][s5]
一方で、映像がリアルに見えることと、物理的に正しく予測できることは別です。会社の発表と第三者の検証を区別しながら、研究の進み具合を冷静に見ていく必要があります。
実践のポイント・まとめ
AIが先に結果を予想する仕組み
ワールドモデルを使うAIは、動く前に「こう動いたらどうなるか」をいくつも頭の中で試し、いちばん失敗しにくい動きを選びます。コップを押す前に、こぼれると想像する人間と同じ考え方です。
送る前にAIに反応を予想させる
同じ考え方は身近にも使えます。メールの文案をいくつか作ってAIに相手の受け止め方を予想させ、いちばん角が立たないものを選んでもらいましょう。ただし、予想は外れることもあるので、最後は自分で判断します。
AIが作った動画の不自然さを見抜く
物が急に消える、すり抜ける、影の向きがおかしいなど、物理のルールに反する場面がないかを見ましょう。2025年6月のMetaのテストでは、動画のAIはこうした違反を見抜くのが苦手でした。このチェックも完ぺきではないので、目安として使ってください。
出典・参考文献
- [s1] Google DeepMind「Genie 3: A new frontier for world models」 ↗ deepmind.google
- [s2] Google「Project Genie: Experimenting with infinite, interactive worlds」 ↗ blog.google
- [s3] Meta AI「Introducing the V-JEPA 2 world model and new benchmarks for physical reasoning」 ↗ ai.meta.com
- [s4] Assran ほか「V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning」 ↗ arxiv.org
- [s5] NVIDIA「NVIDIA Launches Cosmos 3, the Open Frontier Foundation Model for Physical AI」 ↗ nvidianews.nvidia.com
- [s6] NVIDIA Blog「How Cosmos 3 Helps Physical AI Think Before It Acts」 ↗ blogs.nvidia.com
- [s8] Hafner, Yan, Lillicrap「Training Agents Inside of Scalable World Models(Dreamer 4)」 ↗ arxiv.org
- [s9] Waymo「The Waymo World Model: A New Frontier For Autonomous Driving Simulation」 ↗ waymo.com
検証ファクト一覧を表示する(全23項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | ワールドモデルの定義(DeepMind):「世界についての理解を使って、その一部をシミュレートできるAI。環境がどう変わるかと、自分の行動がそれにどう影響するかを予測できる」 | [s1] | |
| F2 | Meta の説明:人は頭の中に世界の内部モデル(内部シミュレーター)を持ち、行動する前に結果を想像して、目標に合う行動を選ぶ。ワールドモデルにほしい力は ①理解(物・動きを見分ける)②予測(世界がどう変わるか、自分が動いたらどうなるか)③計画(目標への行動の並びを決める) | [s3] | |
| F3 | Genie 3(2025-08-05):文章から、リアルタイムで動き回れる世界を生成。24フレーム/秒・720p・数分間一貫性を保つ。前の約1分前までの様子を見て次のコマを作る | [s1] | 「largely(おおむね)consistent」。会社の発表 |
| F4 | Genie 3 の世界は、3Dの形を持たず、コマごとに(行動に応じて)作られる。コマを作るたびに、それまでの軌跡を見直す必要があり、誤差がたまりやすい | [s1] | 一貫性は「創発的な能力」と説明 |
| F5 | Genie 3 の例:ギリシャ神殿の世界で、左にあった木が、視界の外に出たあと戻ってきても同じ位置にある(0:00・0:20・0:40の図) | [s1] | |
| F6 | Genie 3 の限界(公式):①エージェントが直接できる行動の範囲が限られる ②複数のエージェントの複雑な相互作用は研究課題 ③実在の場所を完全な地理の正確さではシミュレートできない ④読める文字は、入力の説明に書いたときだけ出やすい ⑤連続の操作は数分で、数時間ではない | [s1] | |
| F7 | Genie 3 は DeepMind の SIMA(3D世界の汎用エージェント)の訓練・試験用の世界を作る実験に使われた。「Genie 3 はエージェントの目標を知らず、行動に応じて未来を作るだけ」 | [s1] | |
| F8 | Project Genie(2026-01-29):Google AI Ultra(米国、18歳以上)の購読者に提供。文章・画像から世界を作り、歩く・飛ぶ・運転するなどで探索し、リミックスできる。**1回の生成は60秒まで**。操作しにくい・遅れが出る・現実の物理や指示にあまり従わないことがある。「promptable events」(探索中に世界を変える機能)はまだない | [s2] | |
| F9 | V-JEPA 2(Meta、2025-06-11):1.2B パラメータ。ラベルなしの動画100万時間以上と画像100万枚で事前学習 → ロボットのデータ(映像+操作)**62時間**(DROID)で追加学習すると、計画に使える。ロボットの置かれる環境のデータは要らない(ゼロショット) | [s3] | |
| F10 | V-JEPA 2 の計画のしくみ:ゴールを**画像**で渡す。今の状態とゴールをエンコーダーで「表現」にして、いくつもの候補の行動を予測器で頭の中で試し、ゴールにいちばん近づくものを選ぶ。1手だけ実行して、また計画し直す(モデル予測制御) | [s3] [s4] | |
| F11 | V-JEPA 2 の成績:新しい物体・新しい環境でのつかむ・置く(つぎつぎのサブゴール画像つき)が成功率 **65〜80%** | [s3] | |
| F12 | V-JEPA 2 の限界(Meta):「いまは1つの時間の幅で学び、予測する」。食洗機に食器を入れる、ケーキを焼くなど、複数の時間の幅の計画は今後。感覚(視覚・音・触覚)をまとめるのも今後 | [s3] | |
| F13 | Meta が同時に出した物理推論のテスト(IntPhys 2・MVPBench・CausalVQA):人は 85〜95% 正解するが、いまの動画のモデルは「偶然に近い」成績(IntPhys 2)。人とモデルの差は大きい | [s3] | |
| F14 | Cosmos 3(NVIDIA、2026-05-31):「世界初の完全オープンなオムニモデル」。文章・画像・動画・環境音・行動(ロボットの関節の角度・つかむ位置など)を入力・生成できる。理解する部分(自己回帰のVLM)と作る部分(拡散)の2つを組み合わせた構造 | [s5] [s6] | |
| F15 | Cosmos 3 のサイズ:Super 64B・Nano 16B(公開ずみ)、Edge(近日。2026-08 に 4B 版の記事) | [s5] | |
| F16 | Cosmos 3 の使い道:①理解して考える VLM ②物理の世界を動画で予測する世界モデル ③ロボットを訓練する世界行動モデルの土台。例:ロボットの行動データを作る(Agile Robots)、自動運転の希少な場面(Li Auto)、倉庫の安全・街のカメラ | [s5] [s6] | 採用企業は NVIDIA の発表で名前が出た会社 |
| F17 | Cosmos 3 の主張:「訓練と評価の期間を月から日へ」「オープンなモデルの中で、世界の生成の正確さのリーダーボードで1位」 | [s5] | 会社の発表。「months to days」の裏づけの数字は発表にない |
| F18 | Dreamer 4(2025-09-29):Minecraft で、環境に触れず(人のプレイ動画 約2,500時間+操作の記録だけ)で、**ダイヤモンドを取った初めてのエージェント**。2万回以上のマウス・キーボード操作の並びを、画面の映像だけから選ぶ課題(慣れた人で約20分) | [s8] | |
| F19 | Dreamer 4 の成績(1000回の挑戦):石のつるはしまで 90%超、**鉄のつるはし 29%**、**ダイヤモンド 0.7%**。比較:VLA(Gemma 3)は鉄のつるはし 11%、OpenAI の VPT(追加学習版)は棒までで鉄のつるはしに届かず | [s8] | |
| F20 | Dreamer 4 の「想像の中での訓練(imagination training)」:学んだ世界モデルの中で、行動を強化学習で練習する。本物の環境とのやり取りはない(オフライン) | [s8] | |
| F21 | Waymo World Model(2026-02-06):Genie 3 を土台に、運転向けに追加学習。カメラとLiDARの両方の映像を作る。竜巻・ゾウ・ライオン・恐竜の着ぐるみの人・洪水・雪の道路など、実際にはほとんど集められない場面を作れる。操作は「運転の行動」「道路の配置」「言葉」の3つで変えられる | [s9] | 会社の発表。ベンチマークや第三者の評価は載っていない。Waymo 車は約2億マイルの完全自動運転 |
| F22 | Waymo の説明:運転のシミュレーターの多くは、自社が集めた走行データだけで一から学ぶ。Genie 3 は大量の動画で事前学習ずみなので、走ったことのない場面も試せる | [s9] | |
| F23 | Genie 3 の使い道(DeepMind):ロボットや自動運転などのエージェントを訓練する「無限に近い練習の世界」。エージェントの弱点を調べる試験にも | [s1] |
※ コップ・メール・AI動画・ゾウの絵は、説明のためのイメージ(生成イラスト)です。ロボットやAIのイラストは、各社の製品やロゴとは関係ありません。
※ 画面の図は、各社の発表・論文からの引用で、加工していません。Genie 3・Project Genie・Waymo・Cosmos 3 の説明は各社の発表で、独立した検証ではありません。V-JEPA 2 の65〜80%は Meta の研究室での実験、Dreamer 4 は論文の実験(Minecraft・1000回)です。
※ Project Genie は、発表の時点では米国の Google AI Ultra 向けの試作品で、国は順次拡大とされています。
※ ワールドモデルが「世界の物理を理解した」という意味ではありません。物理シミュレーターとの比較や、メール・AI動画の見方は目安です。