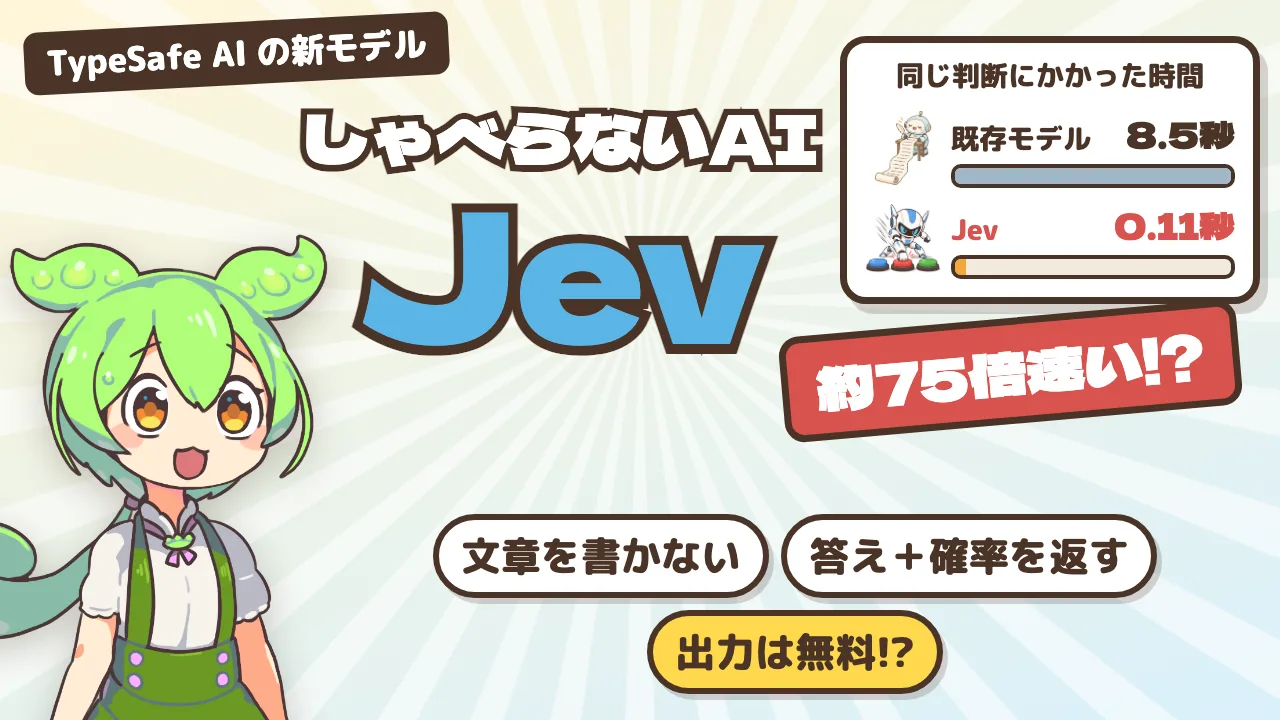
文章を書かずに、決めた選択肢から答えを選ぶAI「Jev」が2026年9月15日に公開されてから、わずか14日で、OpenAIのDecisions API、Liquid AIのd1、無料で公開されたLaya、自分のパソコンで動かせるOllamaの対応モデルなど、似たAIが次々と登場しました。
本記事では、この2週間の流れを整理し、新しい判断AIそれぞれの特徴、「Jev超え」「7.8倍速い」といったニュースの数字の読み方、そして自分の仕事に合わせた選び方をまとめます。
情報は2026年9月30日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- Jevの公開から14日で、OpenAIなど各社が判断AIに参入した。
- 「Jev超え」「7.8倍速い」といった数字は、誰がどう測ったかを確かめる。
- 自分のデータで比べて選び、自信度の低い答えは人が確認する。
基礎知識:判断だけするAI(判断AI)の仕組みと広がり
業務システムの中で、問い合わせの担当部署(配送・請求・技術)の振り分けや、緊急度の判定、写真から破損の有無を確かめる作業をAIに任せるとき、自由に文章を書くチャットAIを使うと、答えるまでに数秒かかり、費用もかさみ、ときには決めた選択肢以外の言い方が返ってきてシステムの連携が止まる、という問題があります。
そこで2026年9月に広がったのが、文章を書かず、「状態」「質問」「選択肢」を受け取って、選択肢ごとの確率と自信度だけを1回の計算で返す「判断AI」です。TypeSafe AIの「Jev」を皮切りに、わずか2週間でOpenAIの「Decisions API」(Lunaというモデルを使い、画像も読める)、Liquid AIの「d1」、オープンソースで手元のPCでも動かせる小さなモデル「Laya」(3億〜4億パラメータ)などが相次いで登場し、Ollamaも同じ型の判断モデルに対応しました。
呼び出しの形が各社でそろいつつあるため、個人情報を含むデータは手元で動くモデル(LayaやOllama)で処理し、画像付きの判断はOpenAIのDecisions API(限定プレビュー)に回す、といった使い分けや、自信度が目安(例:0.9)に届かない答えだけを人の確認に回す運用が考えやすくなっています。
Jevのライバルが続々と登場
Jevの公開からOpenAIの参入まで
Jevの発表から OpenAI の参入まで
文章を書かずに答えを選ぶAI「Jev」の公開から、OpenAIの参入まで、わずか14日でした。[s1][s8]答えを選んで確率を返す「判断AI」という新しい形が、一気に広がりつつあります。本記事では、この2週間に何が起きたか、新しいAIの違い、そして数字の読み方と選び方を整理します。
おさらい —— 判断AIとは
チャットAI
- 文章で答える
- 1文字ずつ書く
判断AI
- 選んで答える
- 確率を1回で出す
判断AIは、文章を書かないAIです。チャットAIが1文字ずつ文章を書いて答えるのに対し、判断AIは選択肢の中から答えを選び、確率を1回の計算で出します。
判断AIの答え方(例)
和菓子ECショップへの問い合わせ(例)
注文した抹茶大福がまだ届きません。明日のお祝いに使いたいのに……
※数値はイメージです(前回の例)
使うときは、いまの状況を書いた「状態」と、「質問」と「選択肢」を渡します。たとえば「この問い合わせの担当は?」と聞くと、「配送」が92%という形で答えが返ってくるため、プログラムでそのまま次の行動を決められます(数値はイメージ)。
「型を守る」と「正しい」は別
型は守る
決めた選択肢の外の答えは出ない
判断ミスはある
選んだ答えが正しいとは限らない
ただし、決めた選択肢の外の答えが出ない(型を守る)ことと、選んだ答えが正しいことは別です。判断AIも、答えを間違えることはあります。[s8]
2週間で何が起きたか
Jevから14日間の動き
Jevから14日間の動き
出典: 各社の発表・報道
9月15日にTypeSafe AIがJevを公開すると、17日には、AIエージェントを作る道具「LangChain」がJevに対応しました。[s13]エージェントの中で「急ぎの仕事かどうか」「どのAIに回すか」「危ない操作を止めるか」といった細かい判断を任せる使い方です。[s13]22日には、判断AIの成績を比べる評価表「Decision Index」がHugging Faceで公開され、9月後半には無料で使える「Laya」や「Jeff」も登場しました。[s5][s12][s14]
そして29日、OpenAIとLiquid AIが同じ日に判断AIを発表し、AIを自分のパソコンで動かすソフト「Ollama」も対応しました。[s1][s7]Jevが示した新しい形が、わずか2週間で一気に広がったことになります。
OpenAIの「Decisions API」
Decisions APIの仕組み
Decisions API のしくみ(OpenAI の説明)
出典: OpenAI「DevDay 2026 の振り返り」
いちばん大きなニュースは、OpenAIの「Decisions API」です。安くて速いモデル「GPT-6 Luna」の力を、あらかじめ決めた有限の答えの候補を持つ質問に集中させる仕組みで、使いみちとして、内容の分類、問い合わせの振り分け、エージェントの次の行動の選択が挙げられています。[s1][s11]大きな特徴は、文章だけでなく画像も読めることです。[s1]
写真付きの問い合わせの例(イメージ)
写真付きの問い合わせ(イメージ)
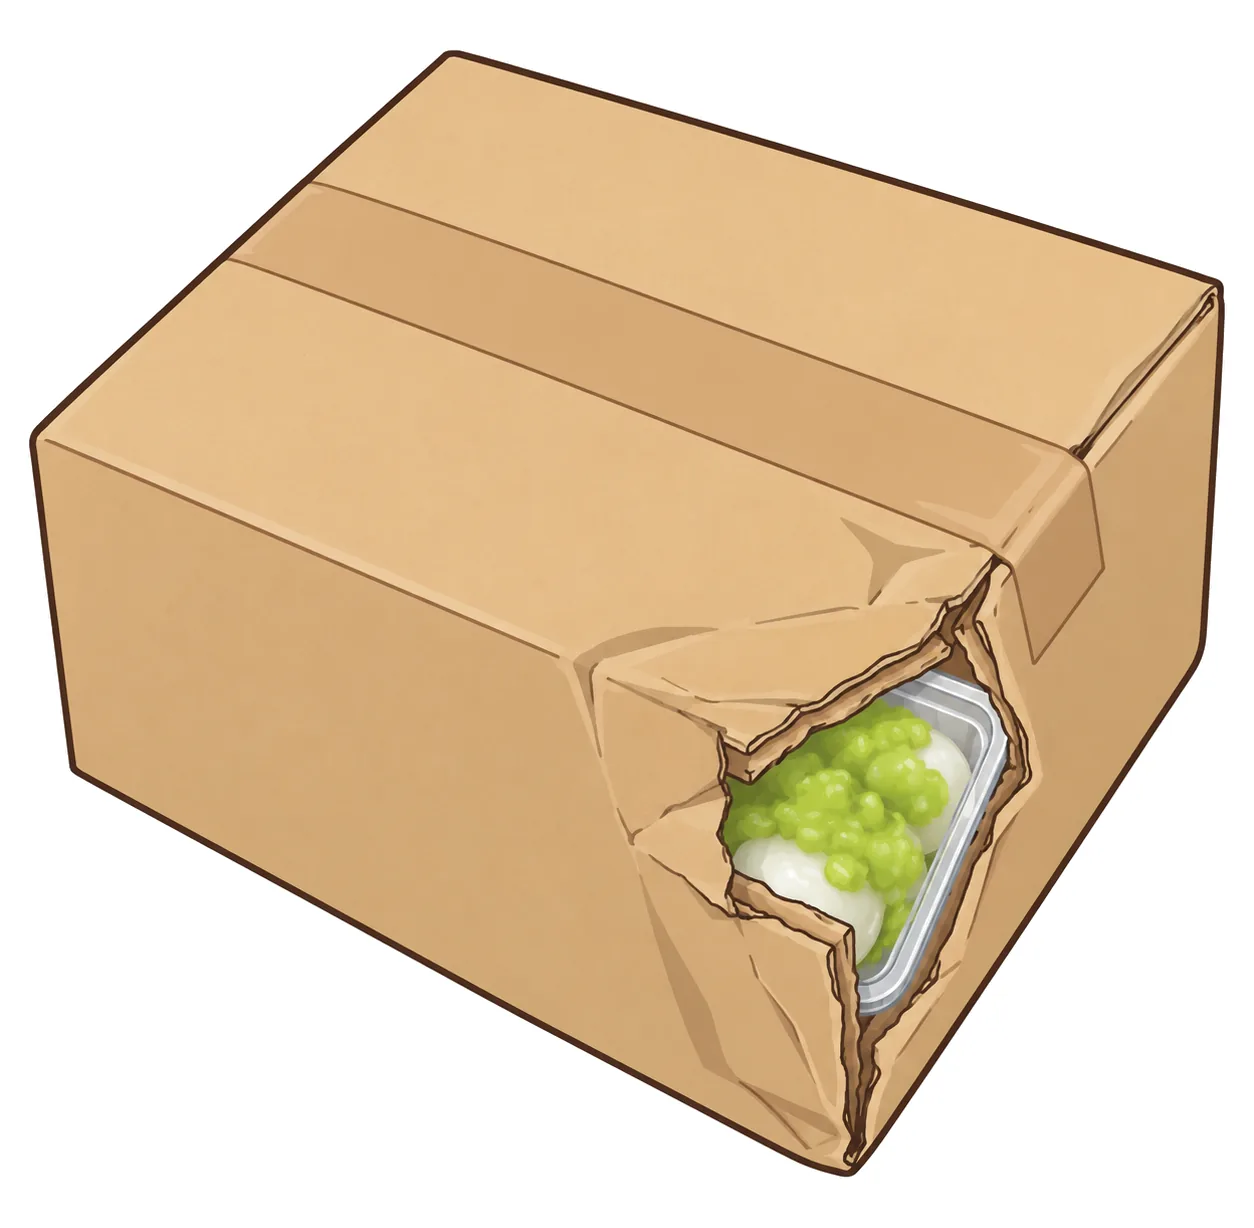
届いた箱がつぶれていました。中身は大丈夫でしょうか?
※数値はイメージです
たとえば「届いた箱がつぶれていた」という写真付きの問い合わせに、「箱は壊れているか」と「どう対応するか」の2つを聞いたとします。答えは、壊れているかが0.94でほぼ「はい」、対応は「交換品を送る」が90%で自信度0.91、という形で返ってくるイメージです。自信度が0.9を超えていれば、自動で進めてもよいという目安が使えます。
Decisions APIの注意点(9月30日時点)
Decisions API の注意点(9月30日時点)
限定公開
広く使えるのは数日後の予定
料金は未発表
判断APIとしての値段はまだ
中身は非公開
Jevと同じ仕組みかは不明
出典: OpenAI「DevDay 2026 の振り返り」
ただし、注意点が3つあります。いまは限定プレビューで、広く使えるのは数日後の予定であること。判断APIとしての料金がまだ発表されていないこと(参考として、GPT-6 Lunaの通常料金は入力100万トークンあたり0.10ドル)。そして、中身がJevのような専用のモデルなのかが公表されていないことです。[s1][s15]
「Jevに追従」の読み方
言えること
Jevの後から、同じ分野に参入した
言えないこと
Jevをまねた(中身は非公開)
報道では「Jevに追従」と書かれましたが、これは発表の時期がJevより後だったという意味です。OpenAIがJevをまねたとまでは言えません。[s1]
Liquid AIの「d1」と「Jev超え」
d1(ディーワン)
Liquid AI の最初の判断モデル
出典: Liquid AI の発表・公式ドキュメント
次は、米国のLiquid AIが発表した「d1」です。Liquid AIは、d1を「評価表でJevを上回った最初の判断モデル」と発表しました。[s9]質問の型はJevと同じ3つで、いまは無料で使え、料金は後日発表とされています。[s2][s9]
評価表の点数(Liquid AIの自社測定)
評価表の点数(Liquid AI の自社測定)
| 項目 | d1 | Jev |
|---|---|---|
| 総合 | 58.9 | 57.9 |
| 芸術 | 45.5 | 37.7 |
| 言語 | 67.6 | 62.0 |
| 検索・分類 | 60.7 | 55.4 |
| ツール | 74.1 | 75.1 |
| 知識 | 43.3 | 51.3 |
出典: Liquid AI の発表(Decision Index 0.2.1 を自社で再現・100点満点)
ただし、数字をよく見ると、総合点はd1が58.9、Jevが57.9で、差は1点です。分野ごとには、芸術や言語ではd1が上回る一方、知識の問題ではJevのほうが8点高い結果でした。しかも、これはLiquid AIが評価表を自分で再現して測った結果で、第三者の確認はまだありません。
だましの指示が入った問い合わせ(イメージ)
Liquid AIは、d1の強みとして、英語以外の言語に強いこと、長い入力をうまく扱えること、入力にまぎれた指示にだまされにくいことを挙げています。[s9]入力にまぎれた指示とは、問い合わせの文章の中に、AIへの命令をこっそり書いておく手口です。判断AIがこの命令にだまされると、勝手に最優先の扱いにされてしまいます。これも会社の主張なので、自分の使い方で確かめることが大切です。
無料で動かせる判断AI —— LayaとOllama
Laya(ラヤ)
インド発・無料で公開された判断モデル
出典: Laya 公式ページ・モデルカード
3つ目は、インドのConvAI Innovationsが無料で公開した「Laya」です。中身がApache 2.0のオープンソースとして公開されており、自分のコンピューターで動かせます。使用料はかかりませんが、動かすパソコンは自分で用意します。大きさは3億〜4億パラメータと、チャットAIよりずっと小さなモデルです。[s5][s6]
Layaの正解率(Laya自身の発表)
Laya の正解率(Laya 自身の発表)
出典: Laya モデルカード(型付き判断のテスト)
Layaは、弱点も正直に公開しています。そのまま使うと、テストの正解率は36%で、いつも一番多い答えを選ぶだけの場合(46%)より低い、あてずっぽう並みの水準です。しかし、その分野のデータで追加学習すると、77%まで上がりました。[s6]自分のお店のデータで練習させてから使う、ということです。
自分のパソコンで動かす判断AI
自分のパソコンで動かす判断AI
Ollama
判断AIを動かせるように
Nimble など
90億〜8億パラメータのモデル
Jeff
個人が作った小さなモデル
出典: Ollama ブログ、GIGAZINE
AIを自分のパソコンで動かすソフト「Ollama」も、判断AIに対応しました。いくつかの会社の判断用のモデルを選んで使え、Ollamaの発表では、Mac(M5 Max)で1回の判断が平均約0.09秒でした。[s7]個人が作った「Jeff」という、さらに小さな互換モデルもあります。[s12]データを外に出さずに判断できることは、個人情報を扱うお店にとって大きな利点です。
呼び出しの形がそろってきた
同じ書き方で、送り先を選べる
同じ書き方で、送り先を選べる
出典: 各社のドキュメント(/v1/systemone)
もう1つの大事な動きは、プログラムからAIに頼むときの書き方と宛先、つまり「窓口の形」がそろってきたことです。OllamaやLayaは、Jevと同じ名前・同じ形の窓口を作りました。[s6][s7]d1は、Jevの道具のまま送り先を変えるだけで使えます。[s2][s3]お店のプログラムをほとんど書き直さずに、乗り換えやすくなったのです。
ただし、これは正式な標準ではなく、OpenAIのDecisions APIは独自の形の窓口です。
判断AIの2つの作り方
判断AIの2つの作り方
判断専用のモデル
- Jev・d1・Laya など
- 判断のために作ったAI
ふつうのモデル
- OpenAI(Luna)を
- 判断の窓口に絞る
作り方も2つに分かれています。Jev・d1・Layaのように判断のために作った専用のモデルと、OpenAIのように、ふつうの安いモデルを判断の窓口に絞って使うやり方です。専用のモデルは速さや安さで有利かもしれず、OpenAIには画像も読めることや使い慣れた環境という強みがあります。どちらが優れているかは、まだ分かりません。
「7.8倍速い」の読み方
「7.8倍速い」の中身
「7.8倍速い」の中身
Laya
- 約33ミリ秒
- GPUで計算する時間だけ
Jev
- 236〜276ミリ秒
- ネット越しの往復込み
出典: Laya 公式ページ、TypeSafe AI 公式ブログ
Layaは「Jevの約7.8倍速い」とうたっています。しかし、Layaの約33ミリ秒はGPUの上でモデルが計算する時間だけであるのに対し、比べたJevの数字は、ネット越しに頼んで答えが届くまでの往復込みの時間です。[s5][s8][s10]お店の中で料理を作る時間と、出前が届くまでの時間を比べているようなもので、7.8倍をそのままAIの速さの差とは言えません。
選択肢が72個ある問題の正解率(Layaの比較)
選択肢が72個ある問題の正解率(Laya 自身の比較)
出典: Laya モデルカード(銀行の問い合わせ分類 Banking77)
Layaが公開した比較でも、Jevが強い問題があります。選択肢が72個ある銀行の問い合わせの分類では、Jevが87%、Layaが43%で、選択肢が多いとJevのほうがずっと正確でした。[s6][s10]
英語用のモデルにクメール語を読ませると
英語用のモデルにクメール語を読ませると
出典: Laya 公式ページ(Laya 自身の発表)
Layaはもう1つ、大事な失敗例も公開しています。英語用のモデルにカンボジアの言葉(クメール語)を読ませたところ、正解率は0%なのに、自信度は平均0.95でした。[s5]自信度が高いからといって、答えが正しいとは限らないのです。
どれを選ぶか
4つの判断AIの比較(9月30日時点)
4つの判断AI(9月30日時点)
| 項目 | Jev | OpenAI | d1 | Laya |
|---|---|---|---|---|
| 提供の形 | 会社のAPI | 会社のAPI | 会社のAPI | 無料で公開 |
| 読めるもの | 文章 | 文章・画像 | 文章 | 文章 |
| 料金 | 有料(安い) | 未発表 | いまは無料 | 無料 |
| 自分のPCで | × | × | 予定 | ○ |
| 使える人 | 先行公開 | 限定公開 | 公開中 | だれでも |
出典: 各社の発表(2026年9月30日時点)
Jev・OpenAI・d1は会社のサービス、Layaは無料で公開されたモデルです。画像を読めると発表しているのは、いまはOpenAIだけです。料金は、Jevが有料、OpenAIは未発表、d1はいまのところ無料です。自分のパソコンで動かせるのはLayaで、d1も将来できるようにする予定とされています。[s1][s2][s5][s9]
選び方の目安
選び方の目安
写真も判断
OpenAI の Decisions API
外に出さない
Laya・Ollama を自分のPCで
Jevのまま
送り先を変えて d1 を試す
件数が少ない
チャットAIで答えの形を指定
写真も判断したいならOpenAI、お客様の情報を外に出したくないならLayaやOllamaを自分のパソコンで、いまJevを使っているなら送り先を変えてd1を試す、というのが選び方の目安です。件数が少なく急がないなら、いまのチャットAIで答えの形を指定するだけでも十分なことがあります。[s9][s10]
自分のお店のテストで比べる
自分のお店のテストで比べる
決める前に、過去の問い合わせ100件ほどを、2〜3個のAIに同じように解かせて比べましょう。正解率だけでなく、自信度の高い答えが本当に当たっているかも確かめます。
自信度で行動を変える
自信度で行動を変える(目安の一例)
- 交換品の手配 0.91 → 自動で
- 0.7 → 人が確認
出典: TypeSafe ドキュメント(Liquid AI も同じ考え方の例を紹介)
そして、自信度の低い答えは人が確認する。どのAIを選んでも、この運用は変わりません。TypeSafeは0.9と0.5、Liquid AIは0.8と0.2という目安の例を示しています。[s2][s8]
まとめ
Jevの公開から14日で、OpenAIをはじめとする各社が判断AIに参入し、無料で動かせるモデルや、自分のパソコンで動かす方法も登場しました。[s1][s5][s7]
「Jev超え」や「7.8倍速い」といった数字は、誰がどのような条件で測ったかを確かめる必要があります。[s10]自分のデータで比べてから選び、自信度の低い答えは人が確認する、という基本を守って使いましょう。
実践のポイント・まとめ
Jevのライバルが2週間で続々
文章を書かずに答えを選ぶAI「Jev」の公開から14日で、9月29日にはOpenAIとLiquid AIが同じ日に判断AIを発表しました。OpenAIのDecisions APIは、画像も読める判断AIです(限定プレビュー)。
「Jev超え」は信じていい?
d1とJevの総合点の差は1点で、知識の問題ではJevが8点上でした。しかも、これはLiquid AIが自分で測った結果です。「〜超え」というニュースは、誰がどう測ったかを確かめましょう。
自信度0.95なら安心?
安心とは限りません。英語用のモデルに慣れない言語を読ませた例では、正解率0%なのに自信度は平均0.95でした。自分のデータで確かめてから使い、大事な判断は人が確認しましょう。
出典・参考文献
- [s1] OpenAI「DevDay 2026 の振り返り」 ↗ openai.com
- [s2] Liquid AI Docs「Decision Models」 ↗ docs.liquid.ai
- [s3] Liquid AI Docs「Decision Model Guide」 ↗ docs.liquid.ai
- [s5] Laya 公式ページ(ConvAI Innovations) ↗ laya.convaiinnovations.com
- [s6] Laya モデルカード(Hugging Face) ↗ huggingface.co
- [s7] Ollama ブログ「Ollama now supports Jev-style decision models」 ↗ ollama.com
- [s8] TypeSafe AI 公式ブログ「Introducing System One Models & Jev」 ↗ typesafe.ai
- [s13] LangChain ブログ「Building a harness with Jev」 ↗ langchain.com
- [s9] GIGAZINE「ベンチマークでJev超えな意思決定モデル『d1』が登場」 ↗ gigazine.net
- [s10] Techno-Edge「新種の"判断だけAI"が無料で使える『Laya』がオープンソースで登場。Jevの約7.8倍高速」 ↗ techno-edge.net
- [s11] ITmedia AI+「OpenAIが『Jev』に追従、『Decisions API』」 ↗ itmedia.co.jp
- [s12] GIGAZINE「無料でJev互換の小型高速意思決定モデル『Jeff』」 ↗ gigazine.net
- [s14] AI Weekly「Jev Decision Index ranks 30+ open-weight decision models」 ↗ aiweekly.co
- [s15] Vercel AI Gateway「GPT-6 Luna」 ↗ vercel.com
検証ファクト一覧を表示する(全33項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | 9/15 TypeSafe AI が Jev をアーリーアクセス公開→ 9/29 OpenAI が Decisions API を発表。**14日** | [s8] [s1] | |
| F2 | 9/17 LangChain が Jev の連携を公開。エージェントの中で「急ぎかどうか」「どのモデルに回すか」「危ない操作を止めるか」の判断に使う | [s13] | |
| F3 | 9/22 判断AI用の評価表「Decision Index」が Hugging Face 上に公開(作者 multimodalart)。37種類のテスト・13万2422件の問題で、Jev と30以上の公開モデルを比べる | [s14] | |
| F4 | 9/29 DevDay 2026 で発表。「あらかじめ定めた有限の回答候補を持つ、ユーザー定義の質問群に Luna の知能を集中させる」 | [s1] | |
| F5 | コンテキストは**テキストや画像**。用途は「コンテンツの分類」「リクエストの振り分け」「エージェントの次のアクションの選択」 | [s1] [s11] | |
| F6 | 9/29 から**限定プレビュー**、「数日以内に広く公開する予定」 | [s1] | |
| F7 | Decisions API 固有の**料金は未発表**。参考:GPT-6 Luna の通常料金は入力100万トークン0.10ドル・出力0.50ドル | [s1] [s15] | |
| F8 | 中身が Jev のような専用モデルかどうかは**公表されていない**。公式に分かるのは「Luna を使う」「有限の答えを返す」まで | [s1] | |
| F9 | 9/29 Liquid AI(米国のAI企業)が最初の判断モデル d1 を発表。「Decision Index で Jev を上回った最初のモデル」 | [s9] | |
| F10 | Liquid AI 自身が Decision Index 0.2.1 を再現して測った結果:総合 **d1 58.9 / Jev 1.13 57.9(差 +1.0)**。分野別:芸術 45.5/37.7(+7.8)、言語 67.6/62.0(+5.6)、検索・分類 60.7/55.4(+5.3)、ツール 74.1/75.1(−1.0)、知識 43.3/51.3(−8.0) | — | **Liquid AI の自社測定**(GIGAZINE も「独自に実行」と明記)。点数は0〜100 |
| F11 | Liquid AI の主張:多言語で強い、プロンプトインジェクション(入力に紛れ込ませた指示)に強い、長い入力に強い | [s9] | |
| F12 | 質問の型は Jev と同じ3つ(Noul / Choice / Score)。出力トークンは常に0 | [s2] | |
| F13 | **TypeSafe の SDK(TypeSafeClient)に送り先(base_url)を Liquid に変えるだけ**で使える。モデル名 `d1:free` | [s2] [s3] | |
| F14 | 記事時点で無料期間中、料金は後日発表。将来ローカルで動かせるかの質問に「もちろん」と回答 | [s9] | 予定であって、まだできない |
| F15 | 中身(パラメータ数・しくみ)は非公開 | [s2] [s3] | |
| F16 | 公式ドキュメントの例:有害な投稿か(はい・いいえ)の確率が0.8超ならブロック、0.2未満なら許可、その間は人が確認 | [s2] | |
| F17 | インドの ConvAI Innovations(CEO Nandakishor Mukkunnoth)が2026年9月に公開。**Apache 2.0 のオープンソース**(無料で自分の環境に置ける) | [s5] [s6] [s10] | |
| F18 | 文章を書かず、選択肢の確率を1回の計算で出す。英語版は ModernBERT-large ベースで4億2100万パラメータ、多言語版は mmBERT-base ベースで3億2200万パラメータ(チャットAIよりずっと小さい) | [s5] [s6] | |
| F19 | 1問あたり 32.8ミリ秒(GPU 1枚。モデルカードでは Tesla T4 で 32.8〜39.5ms) | [s5] [s6] | **モデルの計算だけ**の時間 |
| F20 | 100以上の言語。多言語版は最大8192トークン | [s5] [s6] [s10] | |
| F21 | 「Jevの約7.8倍速い」:Laya 32.8ms と Jev 236〜276ms の比較(Laya 側が掲げた数字)。Jev 側の公式値 70〜500ms は「西海岸のノートPCから測った、通信込みの応答時間」 | [s5] [s8] [s10] | **測り方が違う**(GPU上の計算だけ vs ネット越しの往復込み)。7.8倍をそのまま「モデルの速さの差」とは言えない |
| F22 | そのまま(追加学習なし)では型付き判断テストの正解率 0.362=**あてずっぽう並み**(多数派を選ぶだけで0.461)。その分野のデータで追加学習すると 0.766(Laya の比較表では Jev 0.727) | [s6] | |
| F23 | 選択肢が多い問題では Jev が強い:72択の銀行問い合わせ分類(Banking77)で Jev 0.870、Laya 0.425 | [s6] [s10] | |
| F24 | 英語用のモデルにクメール語(カンボジアの言葉)を読ませると、正解率0%なのに平均自信度 0.952 | [s5] | **自信度が高くても正しいとは限らない**。Laya は文字の種類でモデルを振り分けて対策 |
| F25 | MCP・LangChain/LangGraph・ONNX に対応。HTTP サーバーは Jev 互換の `/v1/systemone` | [s6] | |
| F26 | 9/29 Ollama 0.35 が Jev 型の判断モデルに対応。窓口は Jev と同じ名前の `/v1/systemone` | [s7] | |
| F27 | 対応モデル:Bespoke Labs の Nimble(90億パラメータ)、Together AI の tev1(40億・8億パラメータ) | [s7] | |
| F28 | Nimble 9B を M5 Max で動かすと1判断あたり平均91ミリ秒。追加の料金なし | [s7] | Ollama の測定 |
| F29 | Ollama の例:「二重に請求された、返金して」→ 担当「請求」0.985 | [s7] | |
| F30 | Jeff:個人開発(Firelex 氏)の Jev 互換モデル。Qwen3.5 0.8B/2B、Gemma 4 E2B を追加学習。RTX PRO 6000 で約22ms、M4 Max で約28ms。コード MIT・重み Apache 2.0。TypeSafe とは無関係 | [s12] | |
| F31 | 「決めた選択肢の外の答えは出ない」ことと「判断が正しい」ことは別。Laya の F22・F24 がその具体例 | [s8] [s6] [s5] | |
| F32 | 自信度(確率)に応じて、自動で実行・人が確認・人に任せる、を分けるのが各社共通のおすすめ(TypeSafe の目安 0.9/0.5、Liquid の例 0.8/0.2) | [s8] [s2] | |
| F33 | 既存の方法:チャットAIの構造化出力でも答えの形は決められる。件数が少ない・速さがいらないなら、それで十分なこともある | [s9] [s10] |
※ 各社の速さ・点数・正解率は、それぞれの会社の発表(自社測定)にもとづきます。独立した第三者の検証ではありません。
※ d1 と Jev の点数は、Liquid AI が評価表(Decision Index 0.2.1)を自社で再現して測った結果です。
※ OpenAI の Decisions API は2026年9月30日時点で限定プレビューで、判断API としての料金や中身のしくみは公表されていません。
※ 記事中のお店の問い合わせ例(写真付きの問い合わせなど)の数値はイメージです(実際のAIの出力ではありません)。
※ ロボットのイラストはイメージで、各社の製品やロゴとは関係ありません。