年末のお歳暮の注文が120件。AIに配送の段取りを頼みたいのに、新しい会話のたびに「卵は使わない」から説明し直し、サイトでエラーが出ると「できませんでした」で止まってしまう――。AIに仕事を任せるときによくある不満です。
Metaが2026年10月12日に発表した「Muse Wonder」は、会話をまたいで大事なことを覚える「Active Memory」と、難しい目標でも投げ出さずに続ける「Active Focus」を打ち出したモデルです。本記事では、Metaのデモ動画(結婚式の席決め・ランニングの計画)でその動きを確かめ、上位版のWonder Fullとの違い、ダウンロードできない理由、第三者の評価とMetaの表から見る得意と苦手、APIとMuse Codeの料金、使う前の注意点までを整理します。
情報は2026年10月13日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- Muse Wonderは、会話をまたいで覚え、投げ出さずに作業を続けることを目指したMetaの新しいモデル。
- 第三者の総合指数では上位版のFullが2位タイ。ただしテストごとに得意と苦手がある。
- 上位版のWonder Fullは、Muse Codeの月50ドル以上のプランだけで使える。
- Muse Codeの「協力モード」と、送信や支払いの前の確認に注意する。
基礎知識:Meta「Muse Wonder」の2つの特長
「Muse Wonder」(と上位版の「Muse Wonder Full」)は、MetaがAIの研究開発の組織を作り直したうえで、2026年10月12日に発表した最上位のモデルです。文章・画像・動画・音声・PDFを読み、文章で答えます。これまでのLlamaシリーズとは違い、モデルの重みは公開されておらず、APIの「Meta Model API」と、開発用のエージェント「Muse Code」を通じて使います。手元で動かしたい人向けには、小さなオープンモデル「Muse Glimmer」が別にあります。
Muse Wonderの特長は2つです。会話をまたいで利用者の前提や仕事のルールを持ち続ける「Active Memory」と、難しい目標に向かって、別のやり方を試し、つまずきを越え、新しい情報に合わせて進める粘り強さを持たせた「Active Focus」です(どちらもMetaの説明)。
単発の知識クイズよりも、道具やブラウザ、コードの実行環境を組み合わせて実際の仕事を最後までやり切る力と、根拠のない作り話の少なさに重点を置いて作られています。Metaは「必要なら確認を求め、大事な操作の前には確かめる」と説明しており、モデルカードは、取り消せない操作の前に人が確認する仕組みを利用者の側でも足すよう勧めています。
AIに毎回同じ説明をしていないか
AIに仕事を任せるときの3つの不満
忘れる
毎回、同じ説明から
止まる
エラーでお手上げ
こわい
勝手に払う・送る?
AIに仕事を任せるときの不満は、大きく3つあります。新しい会話のたびに同じ説明から始めなければならないこと、エラーが出るとそこで止まってしまうこと、そして勝手に支払いや送信をしないかという不安です。Metaが10月12日に発表したMuse Wonderは、まさにこの3つを狙ったモデルです。[s1][s2]
覚える
会話をまたいで
投げ出さない
別のやり方で続ける
確認する
大事な操作の前に
覚えること、投げ出さずに続けること、大事な操作の前に確認すること。Muse Wonderは、この3つを目指しています。[s1][s2]ただし、すべてのテストで1位というわけではなく、注意点もあります。[s4][s12]
Muse Wonderとは
MetaのAIの1年
MetaのAIの1年
FacebookやInstagramを運営するMetaは、2025年夏にAIの開発組織を作り直しました。[s1][s14]2026年4月に最初のモデル「Muse Spark」、9月に利用者の代わりに動くエージェント「Muse」を出し、10月12日に最も高性能なモデルとしてMuse Wonderを発表しました。[s1][s2][s10][s11]
重みは公開されていない
Muse Wonder
重みは公開しない
Muse Glimmer
ダウンロードできる小さいモデル
Muse Wonderのモデルの重みは公開されていないため、ダウンロードして自分の機械で動かすことはできません。[s15]使うのは、ネット越しのAPIか、Metaの開発の道具であるMuse Codeからです。[s1][s5]手元で動かしたい人には、小さなMuse Glimmerが別に用意されています。[s17]
Muse Wonderの仕様
Muse Wonder
Meta(2026年10月12日)
さらに上位の「Wonder Full」もありますが、これは別のモデルで、Muse Wonderの考える強さを最大にしてもFullにはなりません。[s1][s5]Fullは、Muse Codeの月50ドル以上のプランでだけ使えます。[s3][s5]読めるのは文章・画像・動画・音声・PDFで、答えは文章で返します。[s3][s5]
特長① 覚えるAI —— Active Memory
毎回はじめましての店員と、常連を覚えている店員
毎回はじめまして
- 前の話を覚えていない
- 毎回、最初から説明
常連を覚えている
- 好みや苦手を覚えている
- 必要なときに思い出す
1つ目の特長は、会話をまたいで大事なことを覚えておく「Active Memory」です。[s1][s2]お店にたとえると、毎回はじめましての店員には好みを一から説明し直す必要がありますが、常連を覚えている店員は、苦手なものを自分から思い出してくれます。
読める量
いま広げられる資料の量
覚える
前の会話の大事なことを残す
ここで区別したいのは、読める量と覚えることの違いです。約100万トークンという読める量は、一度に机に広げられる資料の量にあたります。[s5]これに対して覚えることは、前の会話から大事なことを残し、必要なときに取り出すことです。[s1]
お店のAIのメモ(イメージ)
お店のAIのメモ(イメージ)
お店の例でいえば、「卵は使わない」「火曜は休み」といった条件や、お客様ごとののし紙の書き方のような細かいことを覚えておくイメージです。途中で送料が変われば、古いメモは使わずに新しいほうを使います(イメージ)。
MemoryBench(Metaの社内のテスト)
MemoryBench(Metaの社内のテスト)
Metaは、この力を自社のテスト「MemoryBench」で測っています。長い会話に、関係のない話やあとで変わる情報を混ぜ、大事な事実を覚えているかを見るものです。Muse Wonderは85.6で1位でしたが、Metaが自分で作ったテストです。[s3][s4]何を、どれくらいの期間覚えるのかといった細かい仕組みも、まだ公開されていません。[s1][s3]
特長② 投げ出さないAI —— Active Focus
投げ出さないための流れ
投げ出さないための流れ
2つ目の特長は、難しい目標でも投げ出さずに続ける「Active Focus」です。[s1][s2]従来のAIはエラーで止まってしまうことがありましたが、Muse Wonderは、計画し、動かし、うまくいったかを確かめ、だめならやり方を変えてもう一度試す、という流れをくり返します。[s1]また、大事な操作の前には手を止めて確認するとMetaは説明しています。[s1][s2]
Metaのデモ:結婚式の席決め
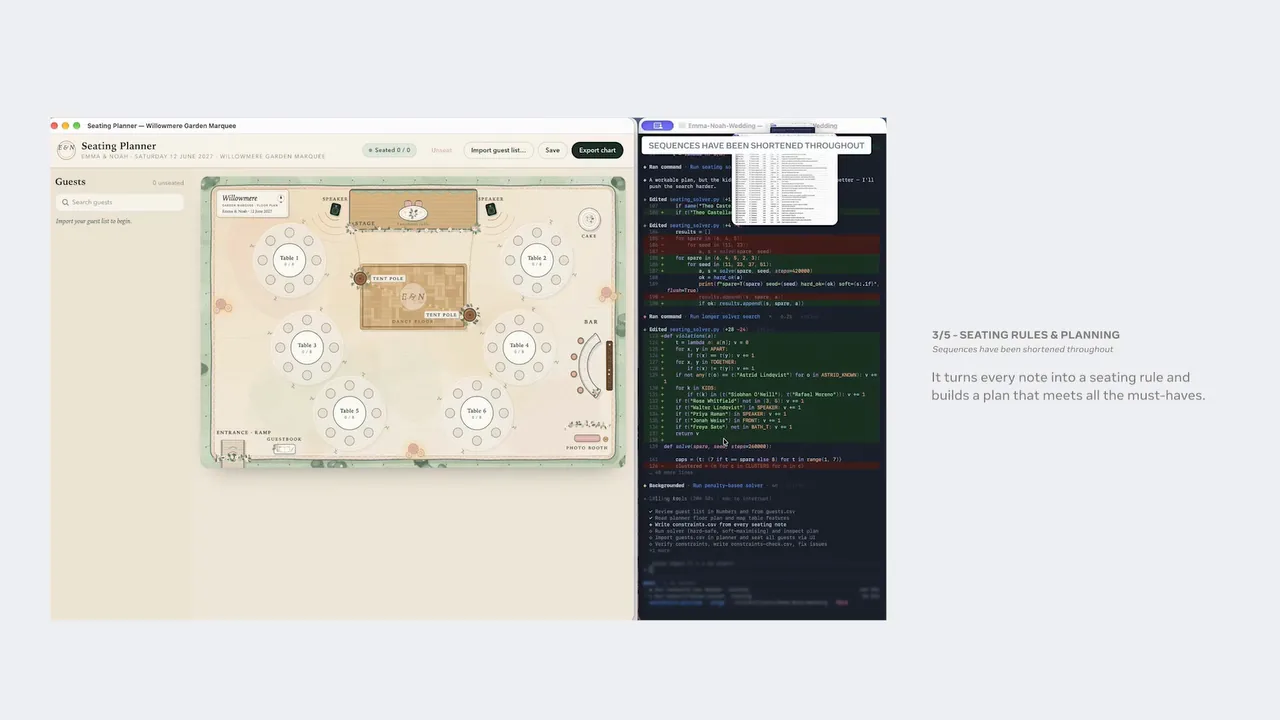
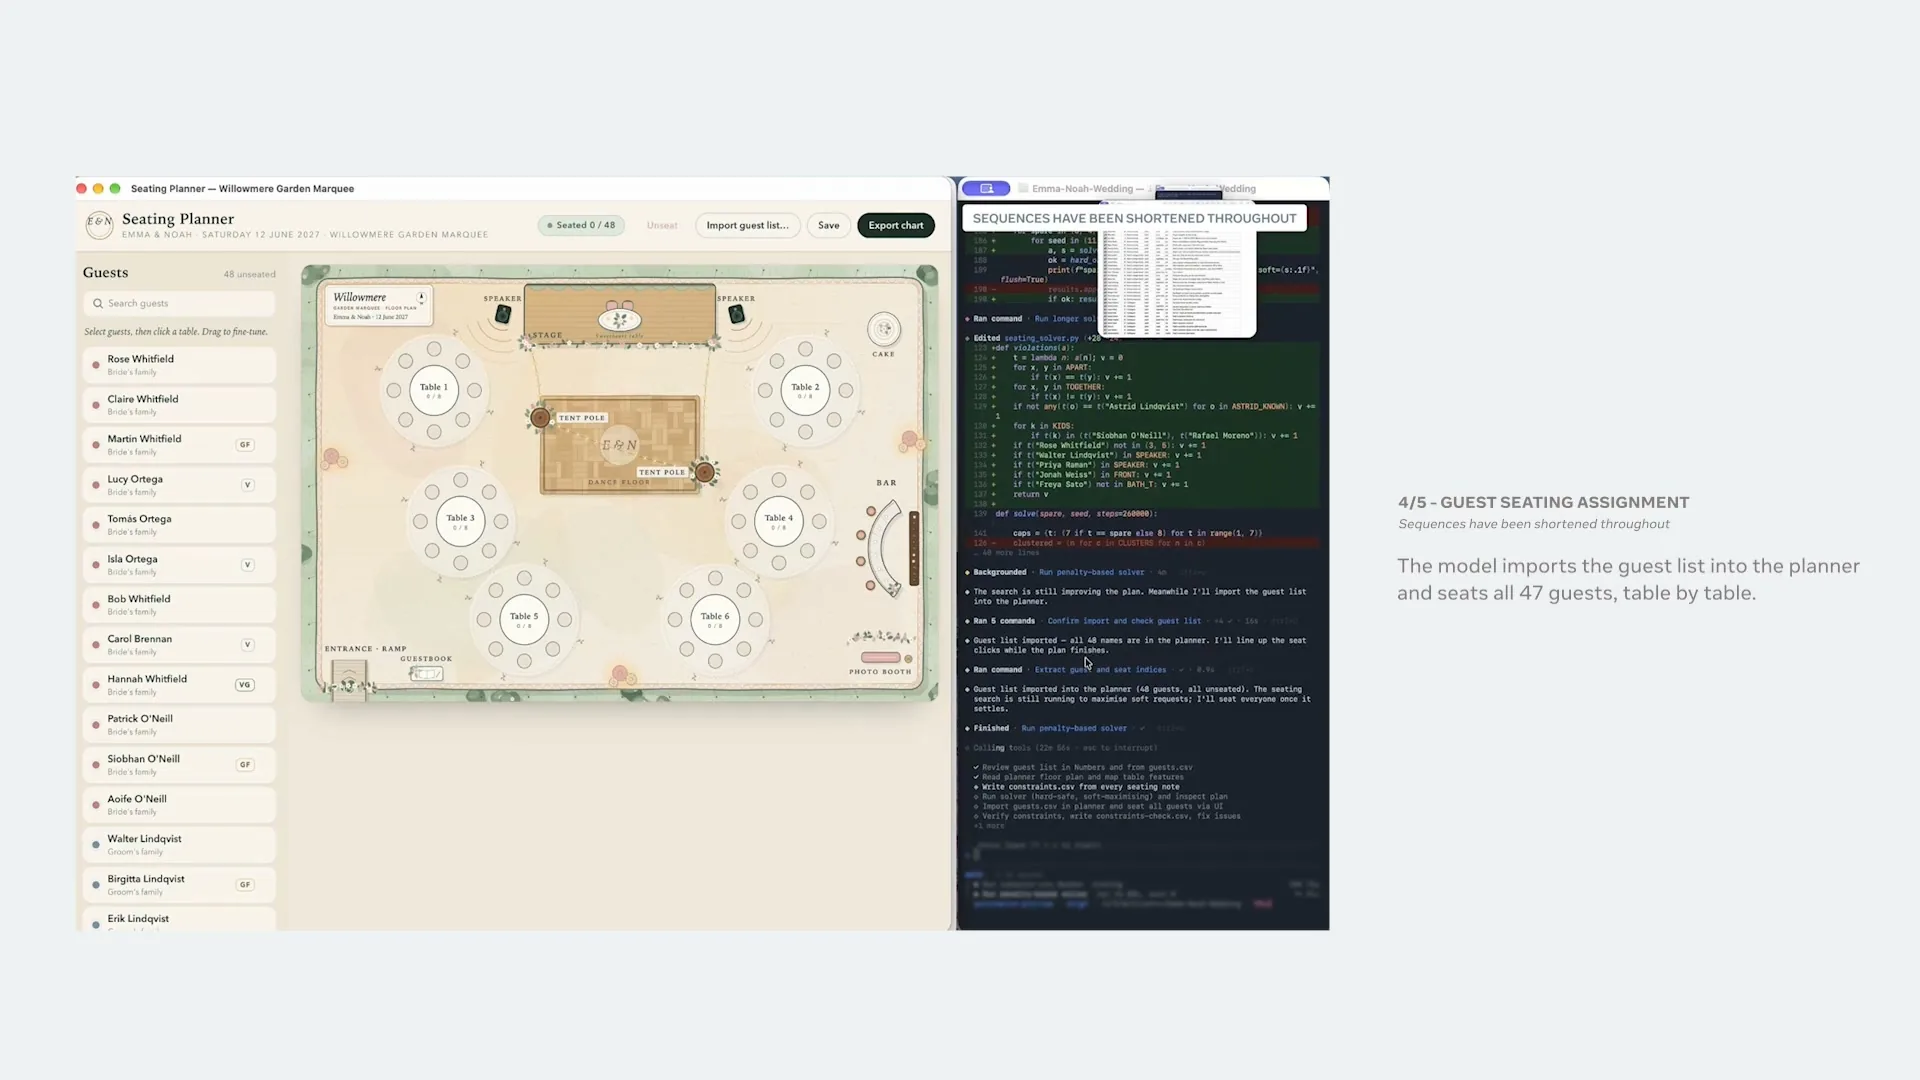
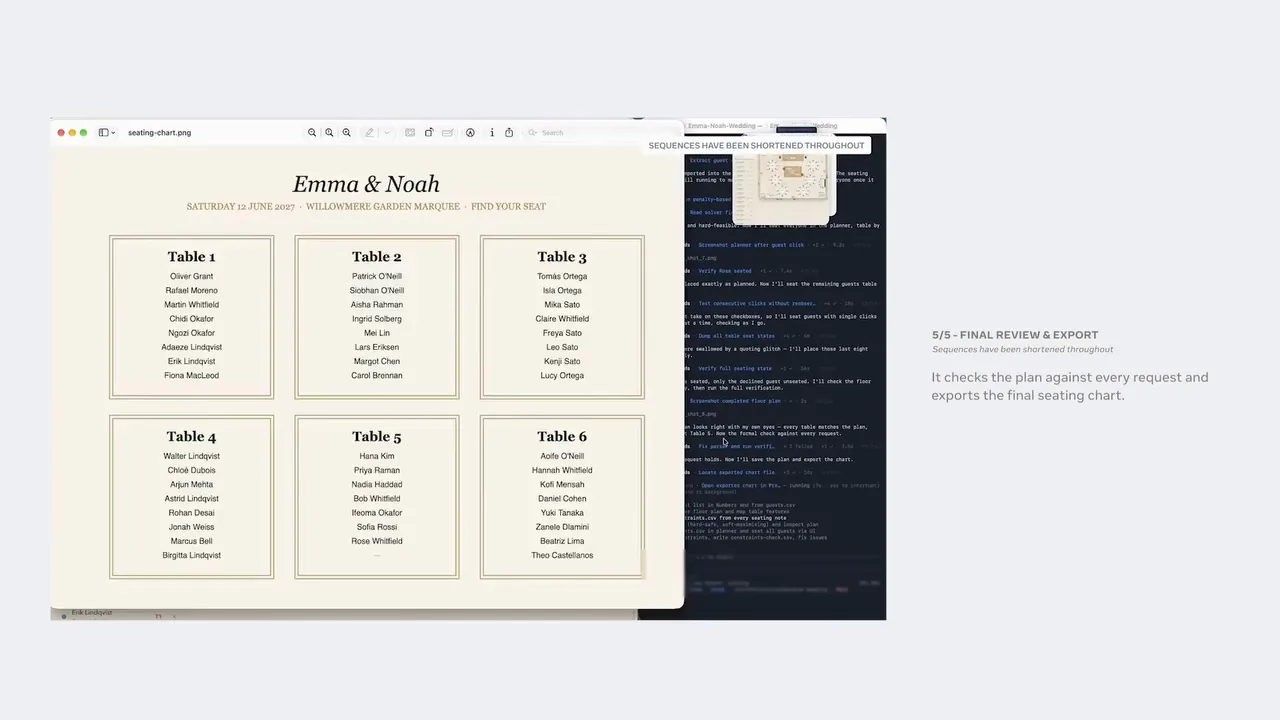
- 車いす・アレルギー・「この2人は離して」
- メモを1つずつルールにする
- 会場の図に47人を座らせる
- 全部の希望を確かめてから書き出す
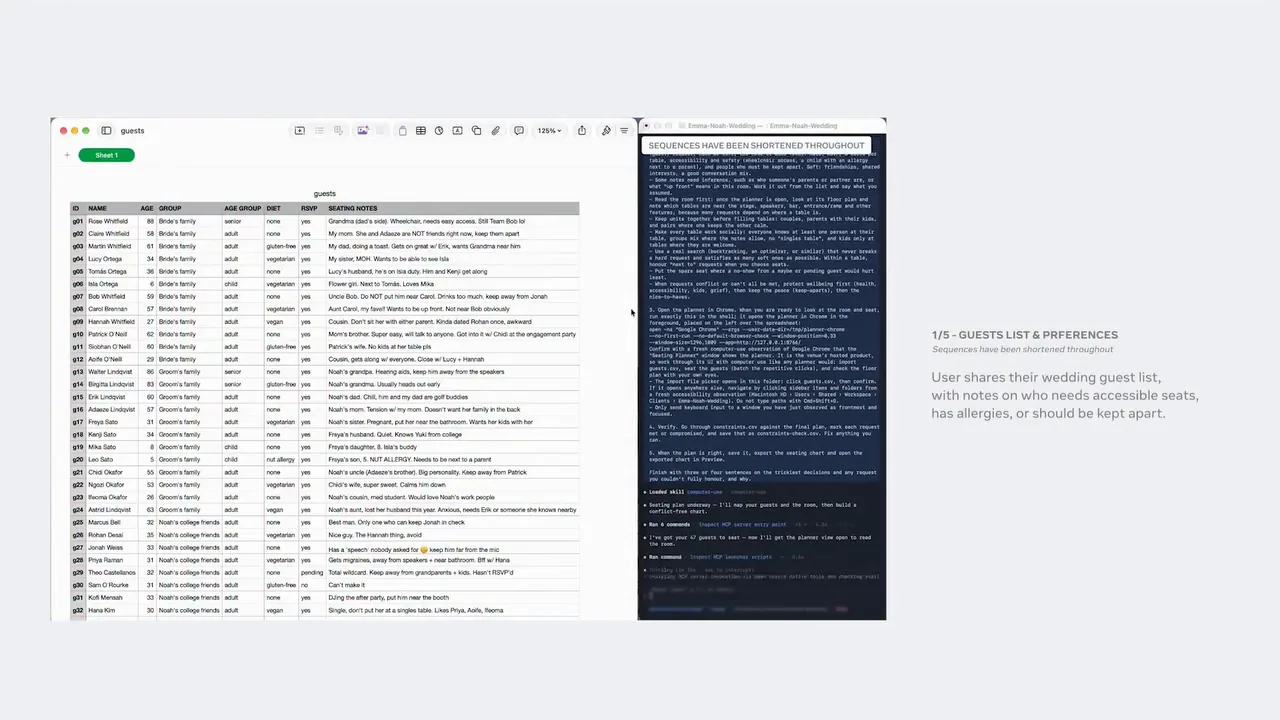
Metaのデモ動画では、結婚式の席決めを任せています。ゲスト47人のリストに、車いす・アレルギー・「この2人は離して」といったメモが付いています。Muse Wonderは、メモを1つずつ席のルールにして計画を立て、会場の図に全員を配置し、最後にすべての希望を守れているかを確かめて席の表を書き出しました。[s1][s4]
ただし、これは会社のデモで、途中を短くした動画です。いつも同じ結果になるとは限りません。[s4]Meta自身も、使う道具や作業場(ハーネス)の作りによって性能が変わると書いています。[s3]
Metaのデモ —— 週末のランニングの計画
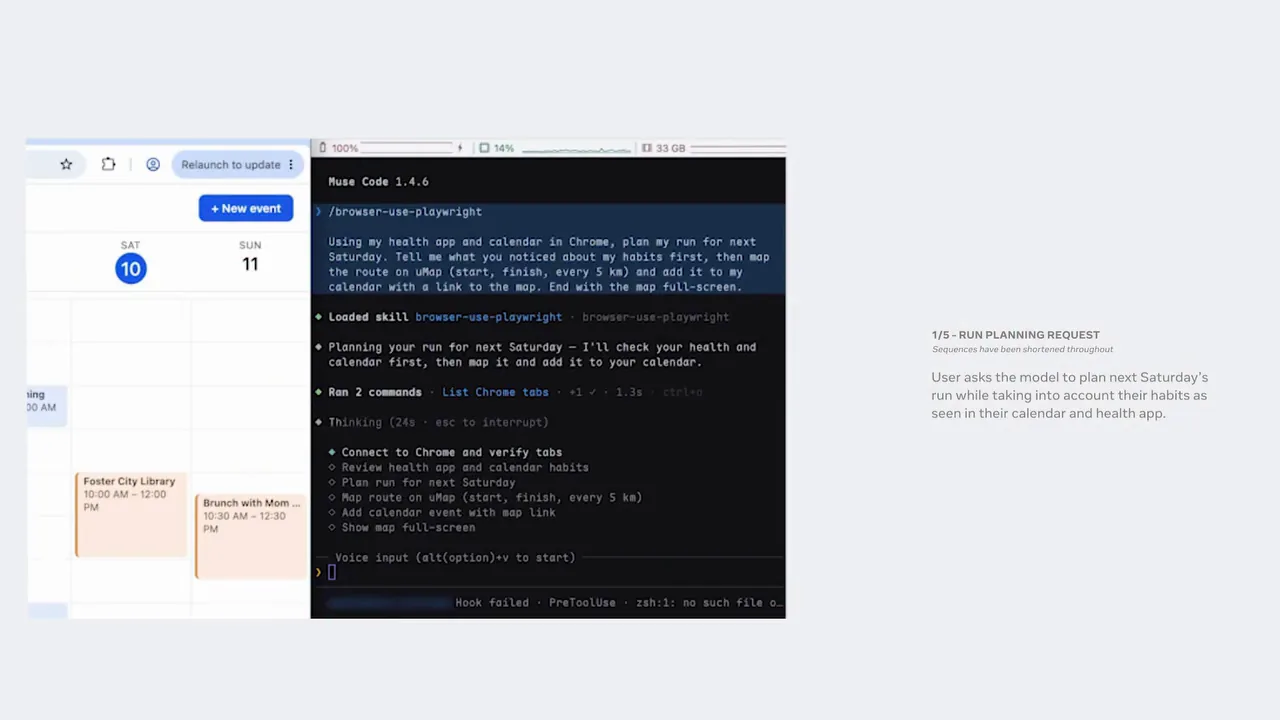
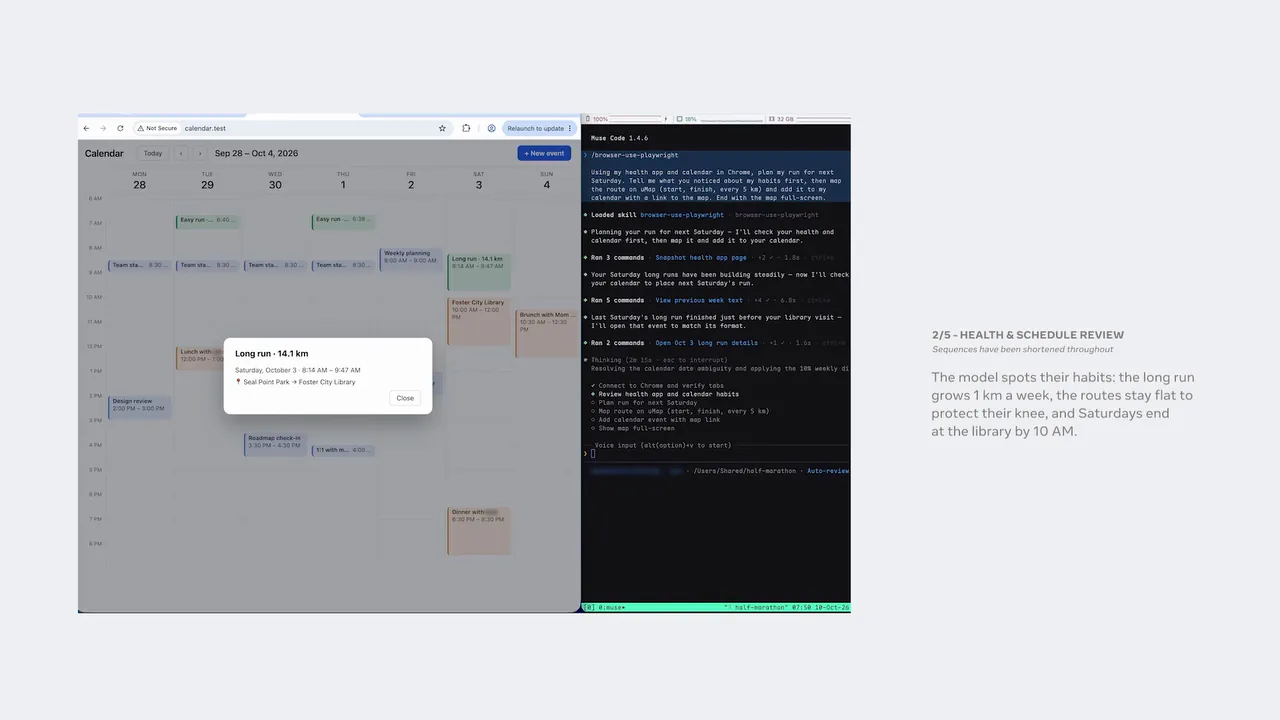
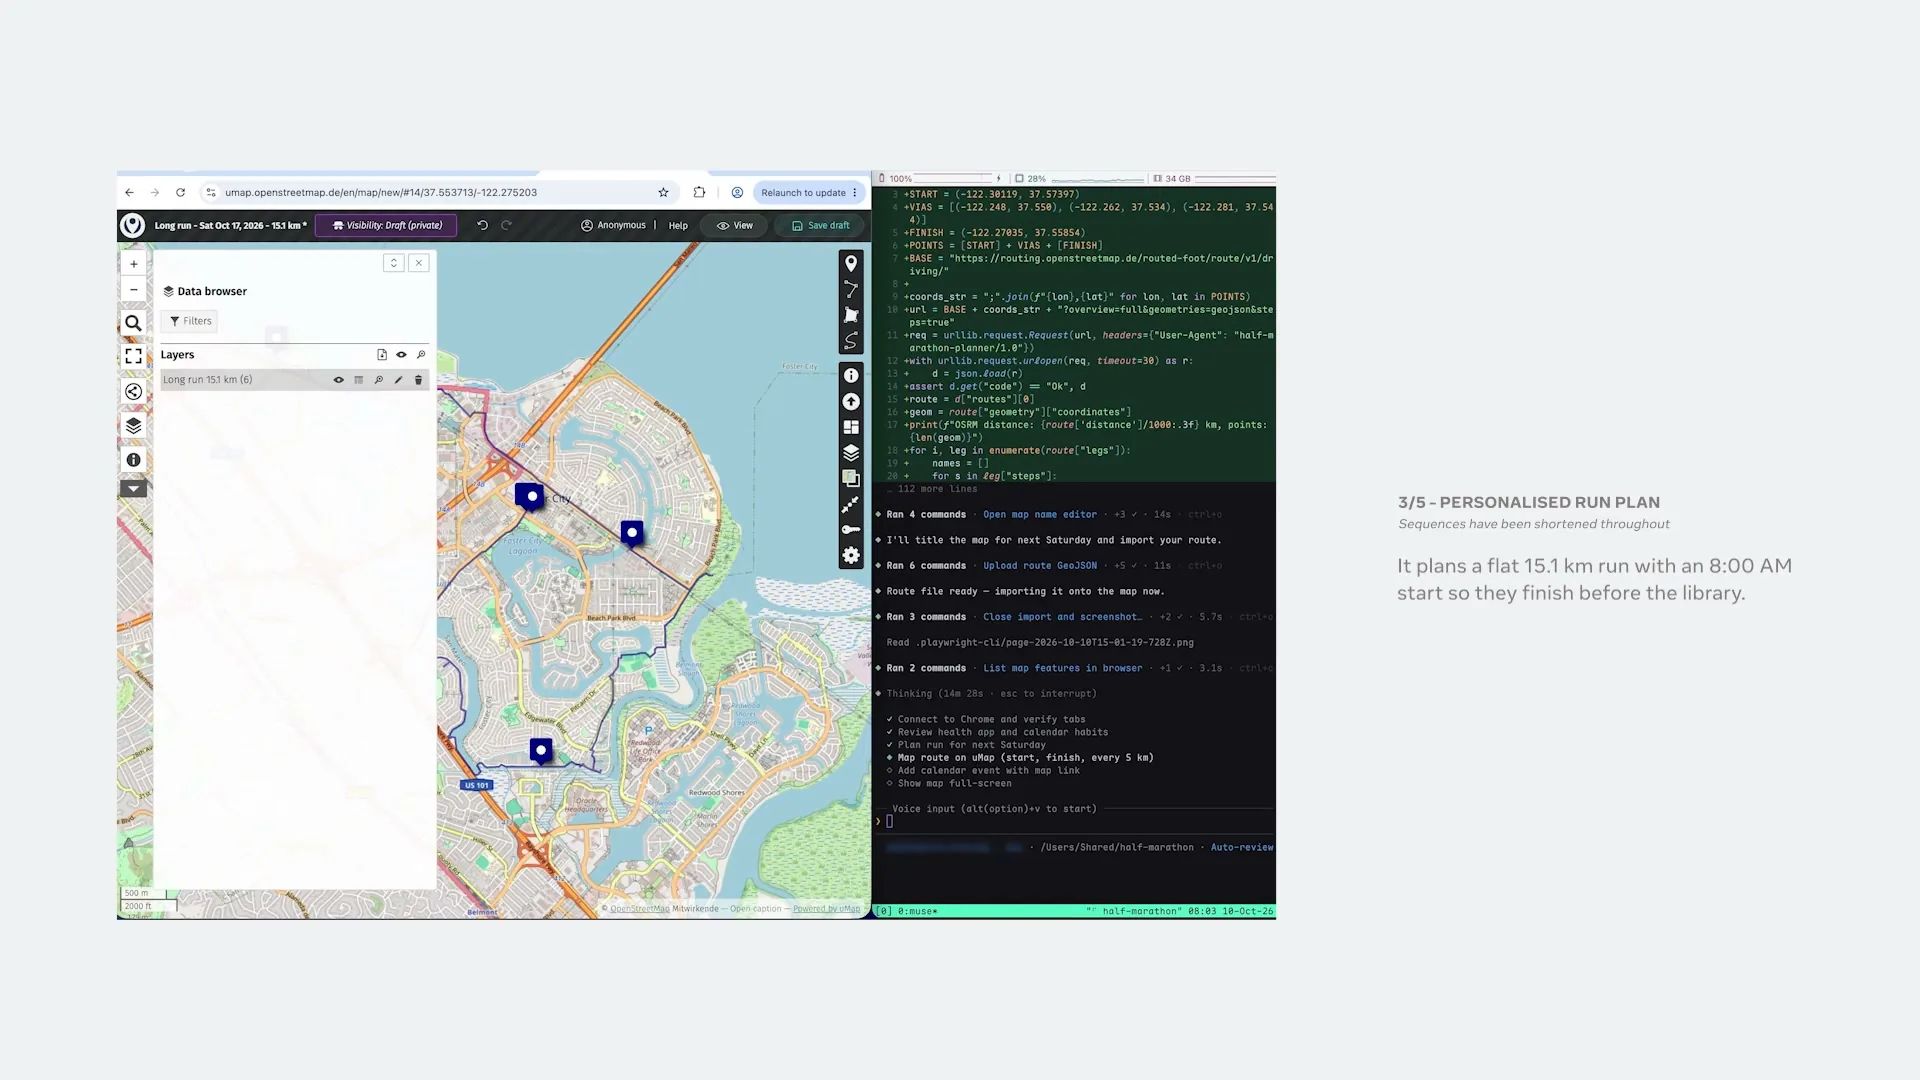
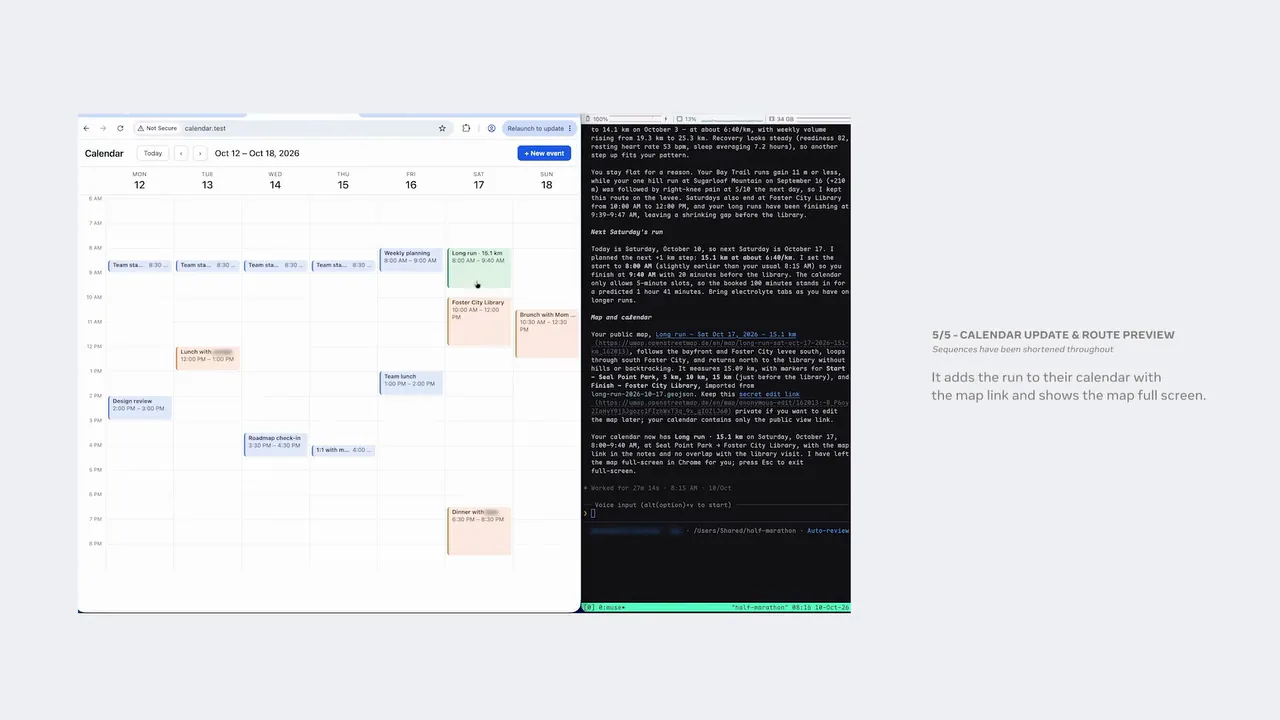
- 健康アプリとカレンダーを見て、来週土曜の計画を
- 長い距離は、毎週1kmずつ伸ばしている
- 膝のために平らな道。土曜は10時に図書館
- 平らな15.1kmを、朝8時から
- 地図のリンクつきで予定に入れる
もう1つのデモは個人の用事で、走るのが趣味の人の週末の計画です。「健康アプリとカレンダーを見て、来週土曜の計画を立てて。先に気づいた習慣を教えて」と頼むと、Muse Wonderは、長い距離を毎週1kmずつ伸ばしていること、膝のために平らな道を選んでいること、土曜は10時に図書館に行くことを見つけました。[s1][s4]
そのうえで、平らな15.1kmのコースを朝8時に出発する計画を立て、図書館に間に合うようにしました。地図に5kmごとの印を付け、カレンダーへの登録まで行っています。[s1][s4]答えを返すだけでなく、仕事を最後まで進めるのがエージェントのAIです。[s1]
お店に当てはめると(イメージ)
お店に当てはめれば、いつもの条件を言わなくても思い出し、配送のサイトでエラーが出ても別の方法で準備を進め、最後の送信の前に担当者に確認する、という動きが期待されます(イメージ)。確認のボタンを押すのは担当者の仕事です。
テストの成績 —— ほかのAIと比べると
第三者の総合指数(10月12日)
Artificial Analysis の総合の指数(10月12日)
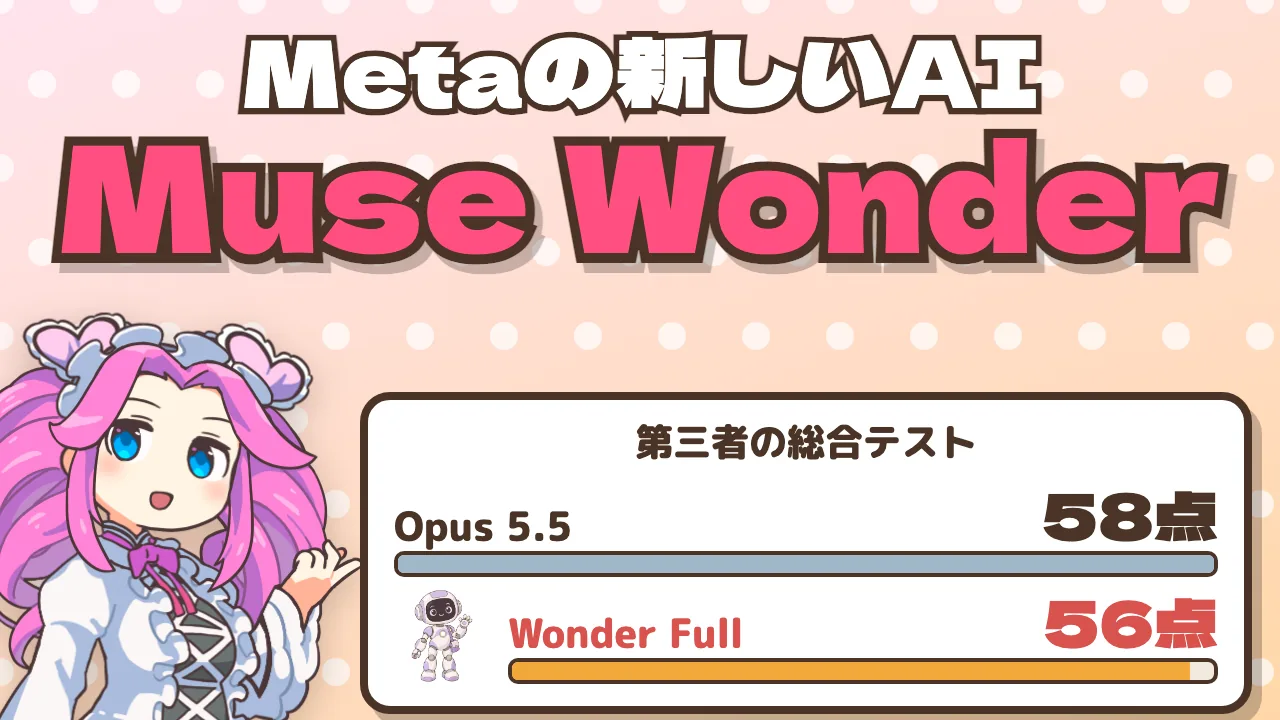
第三者の評価機関Artificial Analysisが10種類のテストをまとめた総合指数では、1位はClaude Opus 5.5の58点でした。Wonder Fullは56点でClaude Sonnet 5.5と並ぶ2位、ふつうのWonderは52点で、GPT-6 Astraなどの53点とほぼ並びます。[s12]6週間前に出たMetaのモデル(Muse Spark 1.3)の48点から、大きく伸びました。[s12]
Metaが出した比較表
Metaが出した表(いちばん強い設定)
| 項目 | Wonder Full | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| 法律の書類 | 13.1 | 8.6 | 4.2 |
| 大きな開発 | 57.5 | 42.5 | 46.3 |
| 仕事の自動化 | 45.4 | 41.6 | 41.2 |
| ターミナル | 57.1 | 59.1 | 59.6 |
| ゼロから作る | 59.0 | 52.5 | 70.5 |
| 画面の操作 | 78.4 | 75.8 | 81.8 |
テストごとに見ると、得意と苦手があります。Metaの表で、Fullが上回ったのは、法律の書類づくり、非常に長い開発、仕事の自動化でした。下回ったのは、ターミナルの作業、ゼロからプログラムを作ること、画面の操作です。[s4]
法律の書類づくり(全部の基準を満たした割合)
法律の書類づくりの13.1%は低く見えますが、これは成果物がすべての基準を満たし、でっち上げのチェックも通った課題の割合です。いちばん良くても約8件に1件で、法律の仕事はどのAIにとってもまだ難しいことが分かります。[s3][s4]なお、この表は、測った会社も使った道具もまちまちで、同じ条件での比較ではありません。[s3]
でたらめの割合(低いほどよい)
でたらめの割合(低いほどよい・Artificial Analysis)
第三者の評価では、知識の問題は苦手で、Wonder Fullは30点(Opus 5.5は46点)でした。一方で、分からない問題で分からないと言わずに間違えた割合は23%で、総合45点以上のAIの中で2番目に低い値でした。[s12][s13]物知りクイズより、道具を使って仕事を仕上げるのが得意なモデルと言えます。[s12]
どこで使えるか、料金はいくらか
Meta Model API
自分のアプリから。Wonderだけ
Muse Code
開発のエージェント。Fullも
Muse
個人のエージェント。アメリカのみ
入り口は3つあります。自分のアプリから呼び出すMeta Model API、ターミナルで動くプログラミング用のエージェント「Muse Code」、そして個人向けのエージェント「Muse」です。ただし、Museはいまは米国だけで、Wonderはこれから入る予定です。[s1][s5][s8][s10]
APIの料金
APIの料金(100万トークンあたり・米ドル)
| 項目 | Muse Wonder | Muse Spark 1.3 |
|---|---|---|
| 入力 | $4.00 | $1.25 |
| キャッシュ済みの入力 | $0.20 | $0.15 |
| 出力 | $20.00 | $4.25 |
APIの料金は、100万トークンあたり入力4ドル・出力20ドルで、前のモデルのMuse Spark 1.3(入力1.25ドル・出力4.25ドル)よりかなり高くなっています。[s6]例として、資料を10万トークン読ませて2万トークン書かせると、入力0.4ドルと出力0.4ドルで合計0.8ドル、約127円です(試算)。[s6][s18]
1つの課題の平均の費用
1つの課題の平均の費用(Artificial Analysis)
ただし、エージェントは何度も読み書きをくり返すため、1回の試算より費用はかさみます。Artificial Analysisのテストでは、1つの課題あたりの平均費用は4.52ドルで、前のモデルの約2.8倍でした。Opus 5.5(5.98ドル)より安く、GPT-6 Astra(3.26ドル)より高い、中くらいの水準です。[s12]
Muse Codeの月額プラン
Muse Code の月額プラン(米ドル)
| 項目 | 月額 | 使える量 | Full |
|---|---|---|---|
| Everyday | $5 | 基本 | × |
| High | $15 | 5倍 | × |
| Power | $50 | 20倍 | ○ |
| Maximum | $200 | 80倍 | ○ |
Wonder Fullを使えるのは、Muse Codeの月額プランのうち50ドルと200ドルのものだけです。[s7][s8]1ドル159円で換算すると、月50ドルは約7,900円で、地域によって条件が変わることもあります。[s7][s18]Metaは、長く複雑な仕事にはWonder、数が多く速さと安さが大事な仕事にはSparkを使うよう案内しています。[s5]
使う前の注意
協力モードと標準モード
協力モード
最初からオン。学習に使われる
標準モード
学習には使われない
1つ目は、学習への協力の設定です。Muse Codeの月額プランは、最初から「協力モード」がオンになっており、送った文章やコード、ファイルがMetaの将来のAIの学習に使われます。[s7]設定でいつでも切れますが、効くのは切ったあとからです。[s7][s15]個人情報や社外秘の情報を入れる前に、設定を確かめましょう。なお、APIで使うWonderは、学習に使わないモードだけです。[s6]
2つ目は、支払い・送信・削除といった取り消せない操作は、人が確認することです。[s3]3つ目は、苦手なこともあるとMeta自身が書いている点です。立体や空間の理解は苦手で、すべての言語で評価しているわけではありません。[s3]
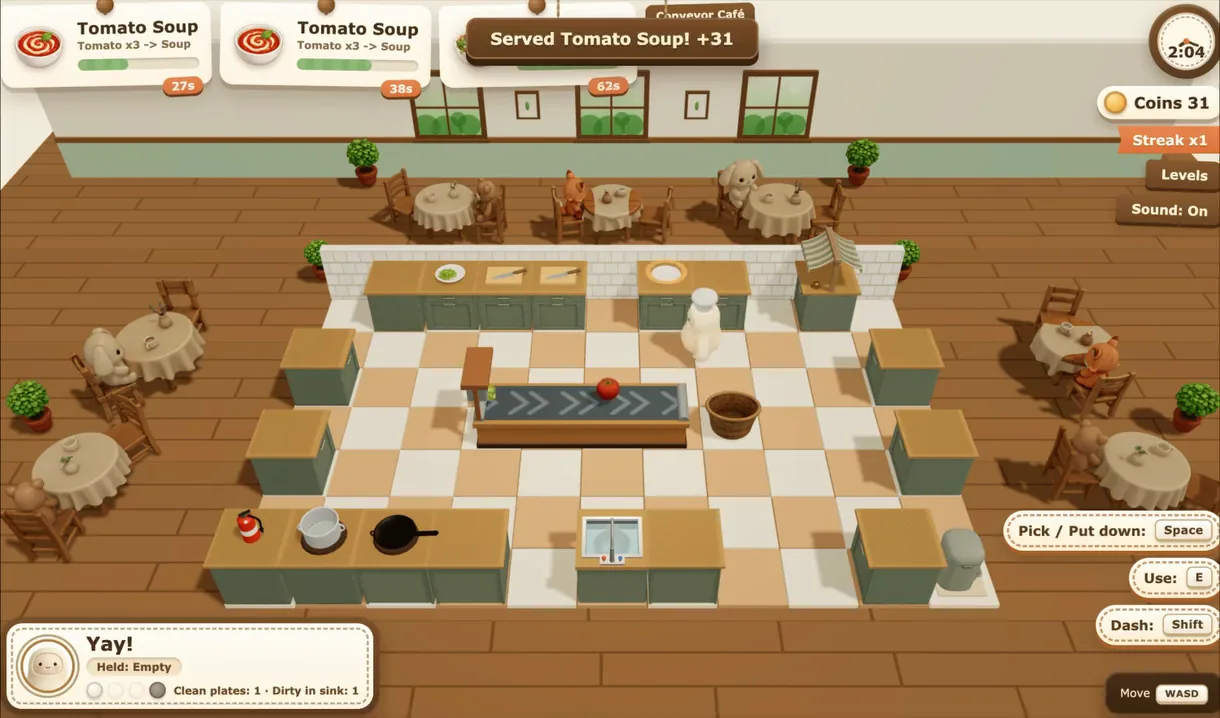
- 画像をもとに作った、3Dのキッチンのゲーム
デモでは画像から3Dのキッチンのゲームを作っていますが、苦手と書かれている以上、結果は自分で確かめる必要があります。[s1][s3]
相手のお店と、使える国
4つ目は、AIが使えるかどうかは相手しだいだということです。9月には、AmazonがMuseによる買い物を止めたと報じられました。自動の道具に買い物をさせるかどうかは、お店が決めることだという考えです。[s16]また、Museのアプリはいま米国だけです。開発者向けのAPIなどは、申し込むときに使える国を確かめましょう。[s7][s9][s10]
ほかのAIとどう選ぶか
頭(モデル)と作業場(道具)
頭(モデル)と作業場(道具)
| 項目 | Meta | Anthropic | OpenAI |
|---|---|---|---|
| 頭(モデル) | Muse Wonder | Claude | GPT |
| 開発の道具 | Muse Code | Claude Code | Codex |
| アプリから | Meta Model API | Claude API | OpenAI API |
ほかのAIと比べるときは、頭にあたるモデルと、作業場にあたる道具をセットで見ることが大切です。同じモデルでも、作業場の作りしだいで結果が変わるからです。[s3]
前からある「忘れない」方法
条件のメモ
毎回はじめに渡す
ルールのファイル
開発の道具に置く
記憶の機能
ほかのチャットAIにも
また、条件を覚えてほしいだけなら、以前からある方法もあります。お店の条件をメモにして毎回はじめに渡す、開発の道具にルールのファイルを置く、ほかのチャットAIの記憶の機能を使う、といった方法でも、「忘れる」問題はかなり防げます。
試すときの4つの手順
Muse Wonderを試すなら
何段もある長めの仕事
卵は使わない・火曜は休み
時間・直した回数・費用
協力モード・送信の前の確認
試すなら、まず何段もある長めの仕事を1つ決め、守ってほしい条件をメモにします。次に、同じ仕事をほかのAIにも頼み、かかった時間・直した回数・費用を記録して比べます。最後に、協力モードと送信の前の確認の設定を見ておきましょう。
まとめ
Muse Wonderは、会話をまたいで覚え、投げ出さずに作業を続けることを目指したMetaの新しいモデルです。[s1]第三者の総合指数では上位版のFullが2位タイでしたが、テストごとに得意と苦手があり、知識の問題は苦手です。[s4][s12]
上位版のFullはMuse Codeの月50ドル以上のプランだけで使えます。[s5]使うときは、協力モードの設定と、送信や支払いの前の確認に気をつけ、自分の仕事でほかのAIと比べてから選ぶのがおすすめです。[s3][s7]
実践のポイント・まとめ
AIに毎回同じ説明をしていないか
Muse Wonderは会話をまたいで覚える機能を打ち出していますが、何をどれくらい覚えるかはまだ公開されていません。守ってほしい条件をメモにして毎回はじめに渡すだけでも、「忘れる」問題はかなり防げます。
Metaの新AI「Muse Wonder」とは
覚えて投げ出さないことを目指した、Metaの最上位のモデルです。使えるのはAPIと開発の道具のMuse Codeからで、上位版のFullは月50ドルからのプランだけで使えます。
Metaの新AIはダウンロードできる?
Muse Wonderの重みは公開されていないため、ダウンロードはできません。使うのはネット越しのAPIか、開発の道具のMuse Codeからです。ダウンロードできるのは、小さなMuse Glimmerです。
月額のAIなら学習に使われない?
限りません。Muse Codeの月額プランは最初から協力モードがオンで、送った内容が学習に使われます。設定でいつでも切れますが、効くのは切ったあとからです。どのAIでも、使う前に設定を確かめましょう。
出典・参考文献
- [s1] Meta AI Research「Muse Wonder: A Frontier Model For Personal & Professional AI Agents」 ↗ research.meta.ai
- [s2] Meta Newsroom「Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents」 ↗ about.fb.com
- [s3] Meta「Muse Wonder Model Card」 ↗ research.meta.ai
- [s4] Meta for Developers「Muse Wonder」モデルのページ(ベンチマークの表・料金・プラン、2026年10月13日閲覧) ↗ dev.meta.ai
- [s5] Meta Model API ドキュメント「Models」 ↗ dev.meta.ai
- [s6] Meta Model API ドキュメント「Pricing and rate limits」 ↗ dev.meta.ai
- [s7] Muse Code ドキュメント「Subscriptions」 ↗ dev.meta.ai
- [s8] Meta for Developers「Muse Code」製品ページ ↗ dev.meta.ai
- [s9] Meta「Meta Model API Model Designation and Geographic Use Policy」 ↗ dev.meta.ai
- [s10] Meta Newsroom「Introducing Muse: The World’s First Personal AI Agent Built for Everyone」 ↗ about.fb.com
- [s11] Meta Newsroom「Introducing Muse Spark: MSL’s First Model, Purpose-Built to Prioritize People」 ↗ about.fb.com
- [s12] Artificial Analysis「Muse Wonder and Muse Wonder Full: a material jump in intelligence over previous Meta models」 ↗ artificialanalysis.ai
- [s13] Artificial Analysis「AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models」arXiv:2511.13029 ↗ arxiv.org
- [s14] TechCrunch「Meta releases its first frontier model, Muse Wonder」 ↗ techcrunch.com
- [s15] VentureBeat「Meta's new Muse Wonder and Muse Wonder Full models achieve frontier performance, but only the weaker one is available via API」 ↗ venturebeat.com
- [s16] Bloomberg(The Star 掲載)「Amazon blocks Meta’s Muse AI agent from its retail site」 ↗ thestar.com.my
- [s17] Meta Model API ドキュメント「Open-weight models」 ↗ dev.meta.ai
- [s18] 欧州中央銀行(ECB)「Euro foreign exchange reference rates」 ↗ ecb.europa.eu
検証ファクト一覧を表示する(全32項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | Meta は2026年10月12日に Muse Wonder と Muse Wonder Full を発表。「いちばん高性能なモデル」で、個人と仕事のエージェントの作業で最先端の成績と説明 | [s1] [s2] | 会社の説明 |
| F2 | 開発は Meta Superintelligence Labs(MSL)。14か月前にAIの取り組みを作り直し始めた。最初のモデル Muse Spark は2026年4月8日、個人向けのAIエージェント Muse は9月8日 | [s1] [s10] [s11] [s14] | |
| F3 | Muse Wonder は Meta Model API と Muse Code で使える。Wonder Full は Muse Code の月額プランの人だけ(API はなし) | [s1] [s5] | |
| F4 | Muse Wonder の推論の強さを max にしても Wonder Full にはならない(別のモデル) | [s5] | |
| F5 | モデルの重みは公開されない(ダウンロードして自分の機械では動かせない)。ダウンロードできる Meta のモデルは 30B の Muse Glimmer | [s15] [s17] | |
| F6 | 入力:テキスト・画像・動画・音声・PDF。出力:テキスト。1回に読める量(コンテキスト)は 1,048,576 トークン(約100万)。推論の強さは minimal〜max | [s3] [s5] | |
| F7 | Active Memory:会話をまたいで、その人について大事なことを持ち続け、いまの作業に関係する細かいことを自分から取り出す | [s1] [s2] | Meta の説明。保存の中身・期間の詳細は発表にない |
| F8 | Active Focus:難しい目標に向かって続ける。別のやり方を試す・つまずきを越える・新しい情報に合わせる。必要なら確認を求め、大事な操作の前には確かめる | [s1] [s2] | |
| F9 | MemoryBench(Meta の社内のテスト):64K〜100K トークンの長い会話で、大事な事実を覚えているか。関係のない会話や、あとで書き換わる情報も混ぜる。Wonder 85.6・Wonder Full 85.5・Opus 5.5 81.5・GPT-6 Astra 81.4・Fable 5.1 79.0 | [s3] [s4] | 社内のテスト |
| F10 | Meta のデモ「土曜のランニングの計画」:Muse Code に「健康アプリとカレンダーを見て、来週土曜のランニングを計画して。先に気づいた習慣を教えて」→ 習慣(長い距離は毎週1kmずつ伸ばす・膝のために平らな道・土曜は10時に図書館)→ 平らな15.1kmを朝8時から → 地図に5kmごとの印 → カレンダーに地図のリンクつきで登録 | [s1] [s4] | |
| F11 | Meta のデモ「結婚式の席決め」:ゲストのリストとメモ(車いす・アレルギー・離したい人)→ 会場の配置 → 席のルールを書き出す → 47人を席に → 全部の希望を確かめて書き出す | [s1] [s4] | |
| F12 | Meta のデモ「画像から3Dのキッチンのゲームを作る」 | [s1] | |
| F13 | Meta の表(max の設定):Wonder Full が上=法律 Harvey LAB-AA 13.1(Astra 8.6・Opus 4.2)、超長期の開発 SWE-Marathon 57.5(42.5・46.3)、業務の自動化 AutomationBench 45.4(41.6・41.2)。Wonder Full が下=ターミナル Terminal-Bench 57.1(59.1・59.6)、ゼロから作る ProgramBench 59.0(52.5・70.5)、パソコン操作 OSWorld 78.4(75.8・81.8)、健康 HealthBench Pro 62.3(65.3・65.6) | [s4] | 会社の発表。測った会社・道具がまちまち(s3) |
| F14 | Harvey LAB-AA の数字は「法律の資料から作った成果物が、全部の基準を満たし、でっち上げのチェックも通った課題の割合」 | [s3] | |
| F15 | Meta の表は、第三者の結果・社内・自己申告がまざる。SWE-Marathon は相手が Codex・Claude Code で動かした結果で「同じ道具での比較ではない」と Meta 自身が書いている | [s3] | |
| F16 | Artificial Analysis の総合の指数(10種類のテスト):Opus 5.5 58、Sonnet 5.5 56、Wonder Full 56、Fable 5.1・GPT-6 Astra・Gemini 4 Argon 53、Wonder 52、GPT-6.1 Sol 52、Spark 1.3 48。Spark 1.3 から6週間で+8 | [s12] | 第三者の評価 |
| F17 | 第三者の評価で伸びたところ:ターミナルの作業 Terminal-Bench 4.0 は Spark 1.3 の33%から57%へ | [s12] | |
| F18 | 知識(AA-Omniscience、−100〜100):Wonder Full 30・Wonder 25、Opus 5.5 46・GPT-6 Astra 43。ハルシネーション率(答えられなかった問題で、分からないと言わずにまちがえた割合)は Wonder Full 23%・Wonder 27%(Spark 1.3 は33%)。45点以上のモデルで2番目に低い | [s12] [s13] | |
| F19 | API の料金(100万トークンあたり):Wonder 入力 $4・キャッシュ済み $0.20・出力 $20。Spark 1.3 は $1.25・$0.15・$4.25。Web検索は1,000回で $2.50 が別 | [s6] | |
| F20 | 試算:入力10万・出力2万トークン(キャッシュなし)で Wonder は $0.80(1ドル159円で約127円) | [s6] [s18] | 試算 |
| F21 | Artificial Analysis の10種類のテストの1つあたりの平均の費用:Wonder $4.52、Spark 1.3 $1.60(2.8倍)、Opus 5.5 $5.98、GPT-6 Astra $3.26 | [s12] | |
| F22 | Muse Code の月額:Everyday $5・High $15(Everyday の5倍)・Power $50(20倍、Wonder Full あり)・Maximum $200(80倍、Wonder Full あり)。特典と提供は地域で変わる | [s7] [s8] | |
| F23 | Muse Code の月額プランは、標準で Contributor mode(送った文章・コード・ファイルと答えを Meta が将来のモデルの学習に使う。そのかわり使える量が増える)。設定でいつでも切れ、切ったあとの内容は使われない | [s7] [s9] | |
| F24 | API で使う Wonder は Standard mode だけ(送った内容は学習に使わない) | [s5] [s6] | |
| F25 | Meta の使い分けの案内:長く複雑な仕事(たくさんのファイルの変更・何時間も動くエージェント・手分け)は Wonder、量が多い・速さ・安さが大事な仕事は Spark | [s5] | |
| F26 | モデルカードの限界:不正確な答えはありうる。新しい状況の何段もの推論でまちがえることがある。見た目・空間、とくに3Dは苦手。すべての言語で評価はしていない。設定・道具・エージェントの作業場で性能が変わる。18歳未満向けではない | [s3] | |
| F27 | モデルカードのすすめ:現実の操作をするエージェントでは、取り消せない操作の前に人が確認するなどの安全策を足す | [s3] | |
| F28 | Muse(個人向けエージェント):9月8日、アメリカで iOS・Android・muse.ai。メールの送信・買い物の前に確認する。学習に使わない設定も選べる。いまは Muse Spark で動き、Wonder は加入者から順に | [s1] [s10] | |
| F29 | Amazon は9月20日の夜から Muse の買い物を止めた。外の会社の自動の道具で買い物することを認めていない、参加するかはお店が決めること、と説明 | [s16] | 報道(Bloomberg) |
| F30 | Muse Code:ターミナルで動くコーディングエージェント。いつも複数のエージェントで手分け・全部の操作を記録して追える。承認・サンドボックスの仕組み | [s8] [s5] | |
| F31 | Meta Model API の使えない国のリストに日本は入っていない。ただし Meta が有効にした国だけで使える | [s9] | |
| F32 | 学習は Meta の Prometheus(ギガワット級のデータセンター、オハイオ州) | [s1] [s14] |
※ 画面に出したMetaの画面(結婚式の席決め・ランニングの計画・3Dのキッチンのゲーム)は、Metaの研究ブログとモデルのページに載っているデモ動画からの引用です。動画は「途中を短くしている」とMetaが画面に書いています。画像は加工していません。
※ MemoryBench の数字はMetaの社内のテストの結果です。Metaの表の数字は、Metaが集めた結果(第三者・社内・各社の発表がまざり、使った道具も同じではありません)です。総合の指数・1つの課題の費用・知識とでたらめの割合は、Artificial Analysis の独立評価(2026年10月12日)です。
※ 円の金額は、1ドル=159円(欧州中央銀行の参照レート、2026年10月12日から計算)で換算した試算です。税・検索の追加料金は入れていません。
※ 記事中のお店の例(お歳暮120件・条件のメモ・AIとのやりとり)はイメージで、Muse Wonder で実際に動かしたものではありません。生成したイラスト(ロボット)は、Metaの製品やロゴとは関係ありません。
※ 機能・料金・提供の状況は2026年10月13日時点のMetaの発表とドキュメントによります。