2026年10月15日、NVIDIAはオープンモデル「Nemotron 3.5 Super VL」と、手元のPC向けの「Nemotron 3.5 Bolt 74B-A9B 24GB」を公開しました。「740億パラメータのAIが24GBに入る」という点が注目されています。
本記事では、NVIDIAの発表・技術レポート・モデルカードと、第三者の評価機関Artificial Analysisの数字をもとに、なぜ24GBに収まるのか、実際に動かすには何GBの機器が要るのか、速さと成績はどの程度か、クラウドのAIとどう使い分けるかを整理します。
情報は2026年10月19日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- 74Bのモデルを約24GBに収める設計だが、公式の動かし方は28GB用と32GB用で、機器は32GB以上が目安。
- NVIDIAの比較表では14項目中10項目で1位。ただし第三者の総合指数は21で、最上位のクラウドAI(58)とは差がある。
- すべてをローカルに移すのではなく、機器・仕事の種類・データの扱いの3点で使い分けるのが現実的。
基礎知識:Nemotron 3.5 BoltとローカルLLMの仕組み
「Nemotron 3.5」は、NVIDIAが2026年10月15日に公開した、重みを公開しているAIモデルのシリーズです。データセンター向けの大きなモデル「Nemotron 3.5 Super VL」と、それを小さくして手元のPCで動かせるようにした「Nemotron 3.5 Bolt 74B-A9B 24GB」などで構成されます。
ChatGPTやClaudeのようなクラウドのAIは、入力を事業者のサーバーに送って答えを作ります。これに対して「ローカルLLM」は、モデルの重み(パラメータ)を手元のPCや自社のサーバーのメモリに読み込み、その場で答えを作る方式です。データを外に送らずに済む一方で、モデル全体を載せるだけのメモリが必要になります。
Boltは、全体で740億(74B)のパラメータを持ちながら、1語を出すごとに計算に使うのは90億(9B)だけという「MoE(Mixture of Experts)」の構造です。さらに専門家部分の重みを1つあたり約2ビットに縮め(精度は量子化を意識した蒸留=QADで取り戻す)、小さな下書き用モデルが先に候補を出して本体がまとめて確かめる「投機的デコーディング」を組み合わせて、約24GBのメモリに収めることを設計目標にしています。ただし、この24GBは文字だけ・同時に1件という条件での見積もりで、公式の動かし方は28GB用と32GB用です。
NVIDIAが手元のPC向けモデルを公開
- 10月15日の発表。題名は「データセンターから手元へ」
- Boltは「ローカルのNVIDIA機器」向け
NVIDIAは10月15日の発表を「データセンターから手元へ」と題し、BoltをローカルのNVIDIA機器向けのモデルとして紹介しました。[s1]同じ発表によると、Super VLとBolt 74Bはすでに公開されており、さらに小さいBolt E4B 4GBは10月23日に公開される予定です。[s1][s8]
発表された3つのモデル
Nemotron 3.5 の3つ(NVIDIAの発表)
| 項目 | Super VL | Bolt 74B | Bolt E4B |
|---|---|---|---|
| 大きさ | 120B | 74B | 約4GB |
| 向き | 企業のサーバー | 手元のPC | 音声・キャラ |
| 公開 | 公開ずみ | 公開ずみ | 10月23日予定 |
NVIDIAの発表。Bolt E4Bは10月19日の時点でまだ
3つのうち、本記事の主役は真ん中のBolt 74Bです。企業のサーバーで動かすSuper VLとは違い、手元のPCで動かすことを前提に作られています。[s1][s3]
「74B-A9B」が意味すること
B=10億(Billion)。パラメータ=モデル内部の重み係数
名前の「74B-A9B」は、モデル全体のパラメータが740億、1語を出すときに実際に使うのが90億という意味です。[s3]入力ごとに必要な専門家だけを呼び出して計算するこの仕組みを、MoE(Mixture of Experts)と呼びます。[s3]
ここで押さえておきたいのは、速さとメモリで効く数字が違うことです。1回に使う9Bが少ないほど計算は速くなりますが、使っていない専門家もメモリには置いておく必要があるため、必要なメモリは全体の74Bで決まります。
なぜ74Bが24GBに収まるのか
120Bの親モデルから作ったのに、24GBに収まるのはなぜ?
小さくする3つの工夫
小さくする3つの工夫
120B → 74B
約2ビットにする
速くする
Boltは、大きなSuper VLを3つの方法で小さくしたモデルです。[s2][s3]1つ目は、専門家の数を減らす圧縮です。NVIDIAのStar Elasticという方法で、層ごとに専門家の数を512人から240〜496人に、1回に選ぶ人数を22人から9人に減らし、120Bを74Bにしました。[s3]
Super VL から Bolt へ(技術レポート)
| 項目 | Super VL | Bolt |
|---|---|---|
| 全体 | 120B | 74B |
| 1回に使う分 | 12B | 9B |
| 専門家(1つの層) | 512人 | 240〜496人 |
| 1回に選ぶ人数 | 22人 | 9人 |
NVIDIAの技術レポート(表1)
圧縮したあとは、元のSuper VLの答えをお手本にして学び直します(蒸留)。この学び直しには1,200億トークンを使い、GPU128枚で約64時間かかりました。[s3]それでも、圧縮した直後の時点では9つのテストの平均点が57.6点から54.7点へ、約5%下がっています。これは仕上げの調整を行う前の数字です。[s3]
9つのテストの平均点(NVIDIAの技術レポート)。手直し前の数字
2つ目は、数値を粗く持つ量子化です。ふつうは1つの数値を16ビットで持ちますが、Boltの専門家部分は約2ビット(正確には2.0625ビット)で持ち、大きさは計算上で約7.8分の1になります。[s3]粗くすると精度が落ちるため、粗い状態のまま親モデルを手本に学び直す「QAD(量子化を意識した蒸留)」で精度を取り戻しています。[s3]
- 親のSuper VL(120B)
- 圧縮した74B 約148GB
- Bolt 24GB
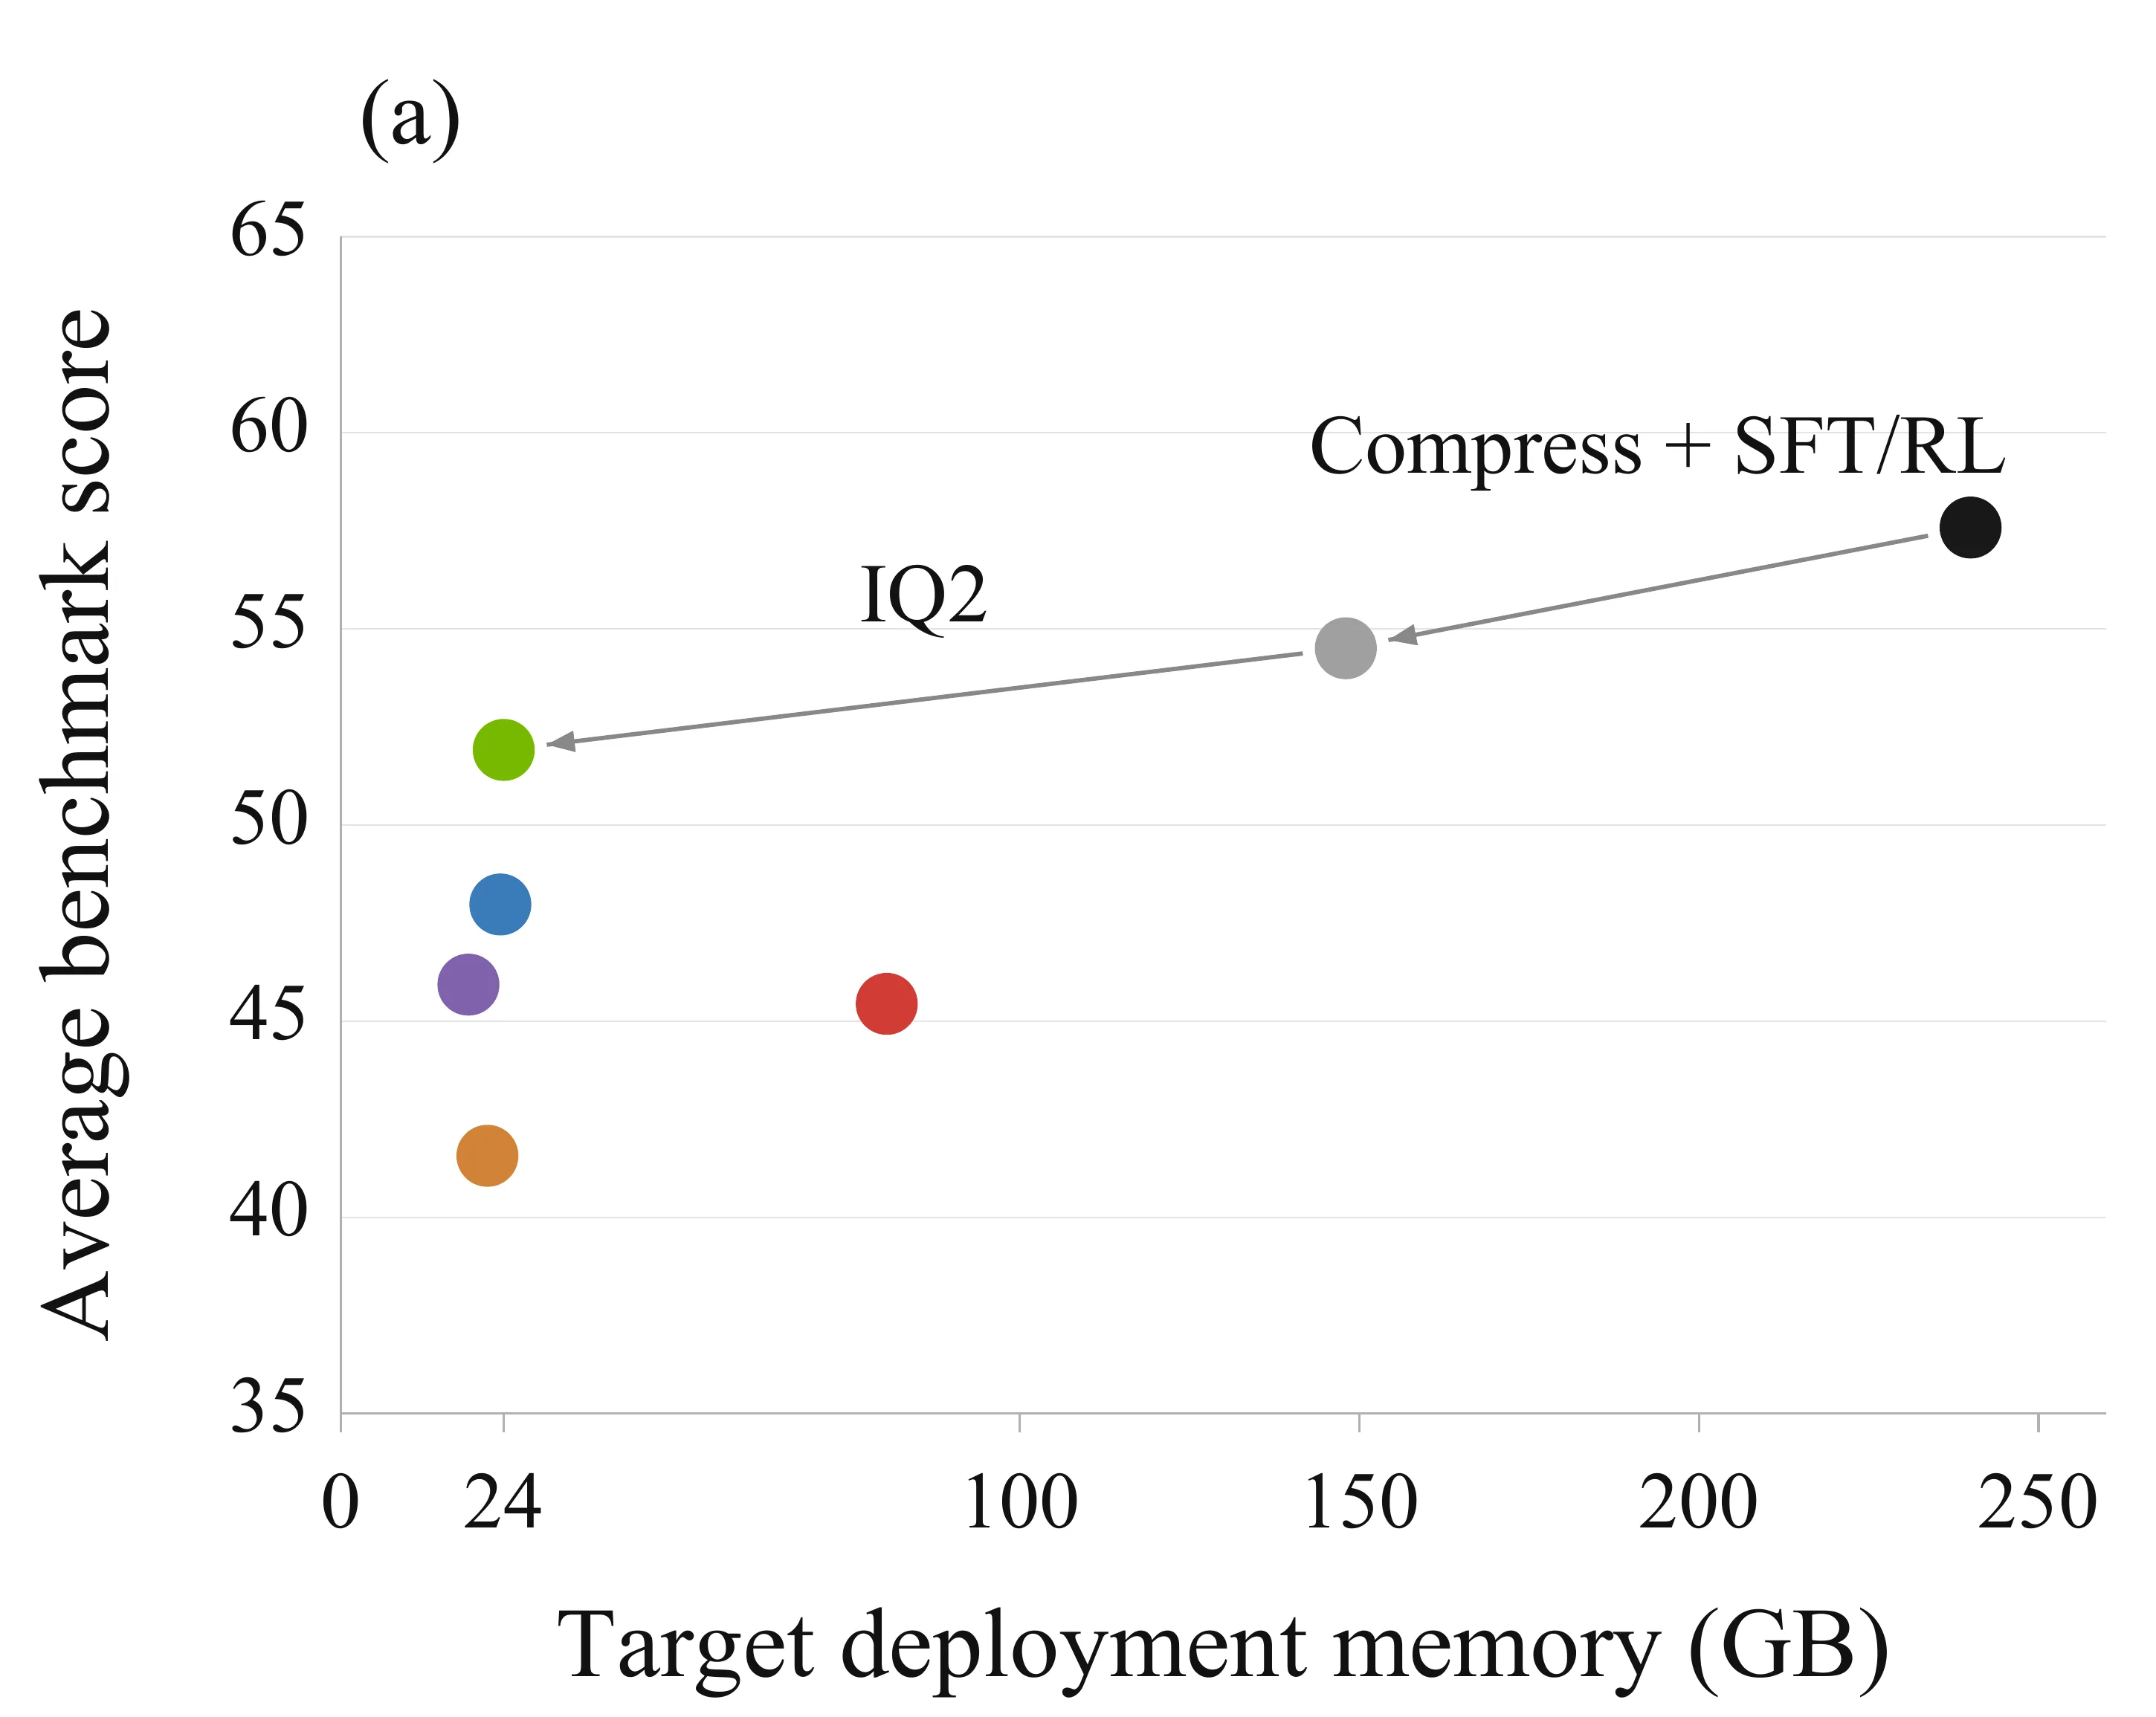
技術レポートによると、圧縮した74Bを16ビットで持つと約148GBになるところ、量子化後は22.1GBになりました。約85%小さくなった計算で、いずれもNVIDIAの測定です。[s3]
3つ目は、速さのための下書き役(ドラフトモデル)です。小さなモデルが先に数語ぶんの候補を書き、本体がまとめて確かめるため、1語ずつ書くより速く出力できます。[s3]NVIDIAは、最初から小さなモデルを作るより、大きなモデルを圧縮したほうが良い結果になると説明しています。[s2][s3]
ただし、この主張はNVIDIA自身の実験と過去の研究にもとづくもので、独立した検証は確認できませんでした。[s2][s3]
本当に24GBで動くのか
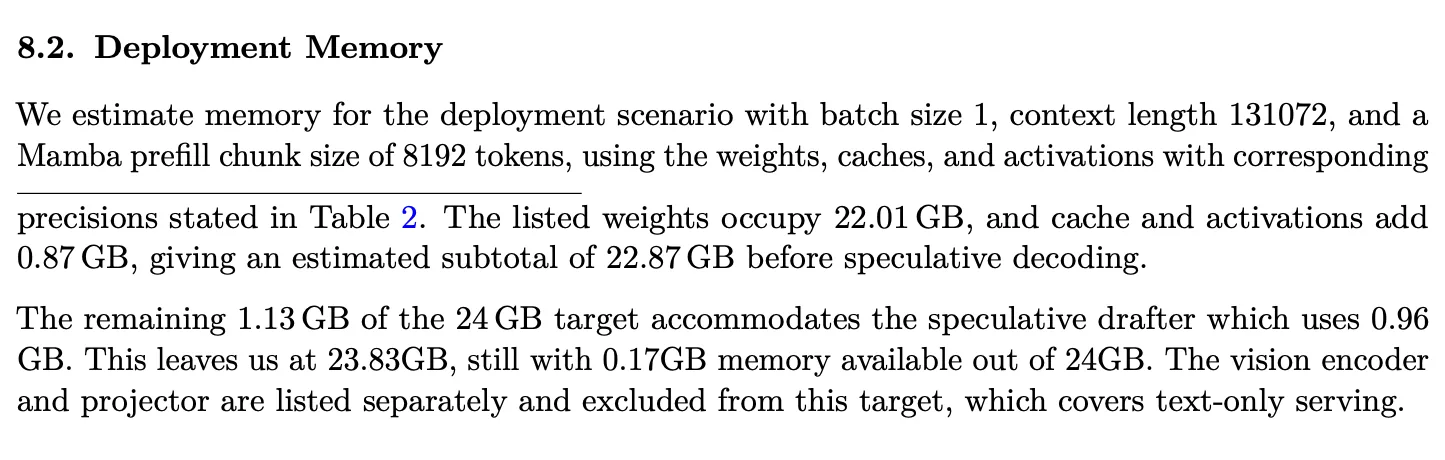
- 重み 22.01GB+メモ 0.87GB
- ドラフトモデル(0.96GB)を含めて 23.83GB
- 画像の部品は含めない。文字だけの見積もり
「24GB」はNVIDIAの設計目標で、技術レポートには内訳と前提が書かれています。[s3]重みが約22GB、会話の文脈を覚えておくKVキャッシュと作業用のメモリが約0.9GB、下書き役のモデルが約1GBで、合計は約23.8GBです。24GBぎりぎりの数字と言えます。[s3]
公式の見積もりの前提
公式の見積もり(文字だけ・同時に1件)
技術レポート8.2節。文脈13万トークン・同時1件・画像の部品は入れていない
この見積もりには3つの前提があります。文字だけを扱うこと、同時に処理するのが1件であること、そして画像を読むための部品を含めていないことです。[s3]
モデルカードの動かし方は28GB用と32GB用
モデルカードの動かし方(llama.cpp)
| 項目 | 28GB用 | 32GB用 |
|---|---|---|
| 機器 | RTX Spark 64GB/GPU32GB〜 | RTX Spark 128GB/GPU48GB〜 |
| 文脈の長さ | 65,536トークン | 262,144トークン |
RTX Spark=NVIDIAのノート向けチップ。GPU=搭載ビデオメモリ(VRAM)容量
一方、Hugging Faceのモデルカードに載っている公式の動かし方は2種類で、24GB用はありません。28GB用はRTX Spark 64GBか32GB以上のGPU、32GB用はRTX Spark 128GBか48GB以上のGPUが対象です。[s5]
公開されたファイルの合計
Hugging Faceのファイルの大きさの合計(約24.8GB)。KVキャッシュ・推論バッファ用は別
公開されているファイルの大きさを足すと、本体・画像の部品・下書き役で約24.8GBになります。[s5]実際にはこれに文脈を覚えておくメモリが加わるため、動かす機器としては32GB以上が目安です。[s3][s5]NVIDIAの言う「ほかのアプリと並べて動く」も、メモリの大きい機器を前提にした話だと考えるのが自然です。[s1][s5]
では、どんな機器なら動かせる?
対象となる機器と値段
機器の値段(ドル・Artificial Analysisの表)
発売時の希望価格・試作機の値段。変わることがある(AAの記事)
公式の動かし方に載っているのはNVIDIAの機器だけです。Artificial Analysisの表では、32GBのGeForce RTX 5090(カードのみ)が約2,000ドル、128GBのDGX Sparkが約4,000ドルでした。128GBのRTX Sparkノートの試作機は約5,900ドルです。いずれも発売時の希望価格などで、変わることがあります。[s11]
RTX Spark(NVIDIAの発表)
Windowsのノート
10月16日発売
メモリは最大128GB
CPUとGPUで共有
ローカルAI向け
エージェントを手元で
RTX Sparkを積んだWindowsのノートは10月16日に発売され、メモリは最大128GBをCPUとGPUで共有します。[s8][s11]MacやAMDの機器は公式の動かし方に載っていないため、動くかどうかは自分で確かめる必要があります。[s5]
速さ —— NVIDIAの測定から
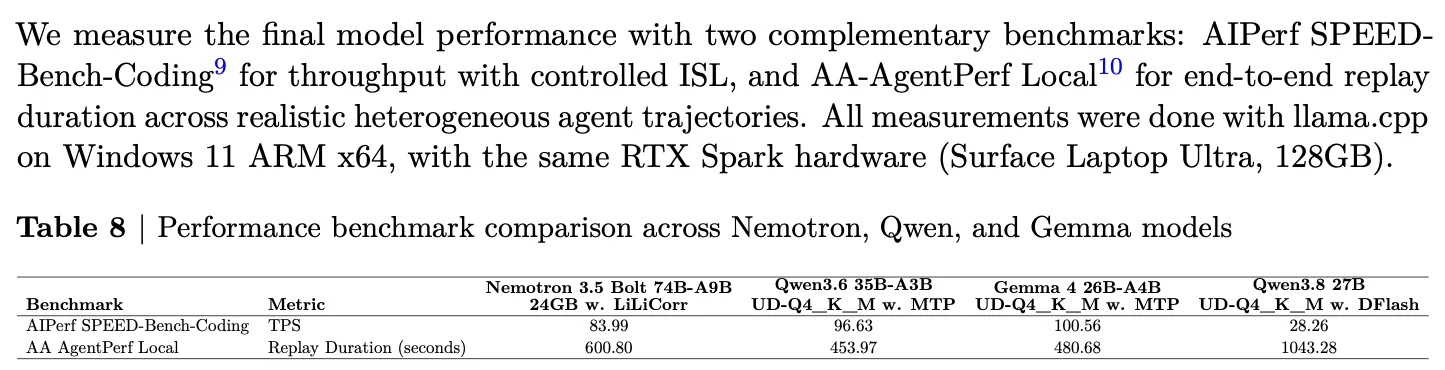
- Bolt 83.99
- 測った機械:Surface Laptop Ultra(128GB)
NVIDIAは、Boltが1秒間に約84トークンを出力すると書いています。[s3]トークンはAIが文章を数える単位で、日本語ならおおよそ数文字にあたります。測定に使ったのは、メモリ128GBのノートPC「Surface Laptop Ultra」です。[s3]
同じノートPCでの比較
速さ(NVIDIAが同じ128GBのノートで測定)
| 項目 | Bolt 74B | Qwen3.6 35B | Gemma 4 26B | Qwen3.8 27B |
|---|---|---|---|---|
| 1秒に出す量 | 84 | 97 | 101 | 28 |
| 仕事の再生時間 | 約10.0分 | 約7.6分 | 約8.0分 | 約17.4分 |
NVIDIAの技術レポート(表8)。比べた3つは4ビット。Boltはドラフトモデル併用時
同じ機械でほかのモデルも測っており、1秒あたりの出力量ではQwen3.6とGemma 4がBoltを上回ります。27BのQwen3.8と比べると、Boltは約3倍速い結果でした。[s3]録画した8つの作業を再現する時間では、Qwen3.6が約7.6分、Boltが約10分でした。[s3]
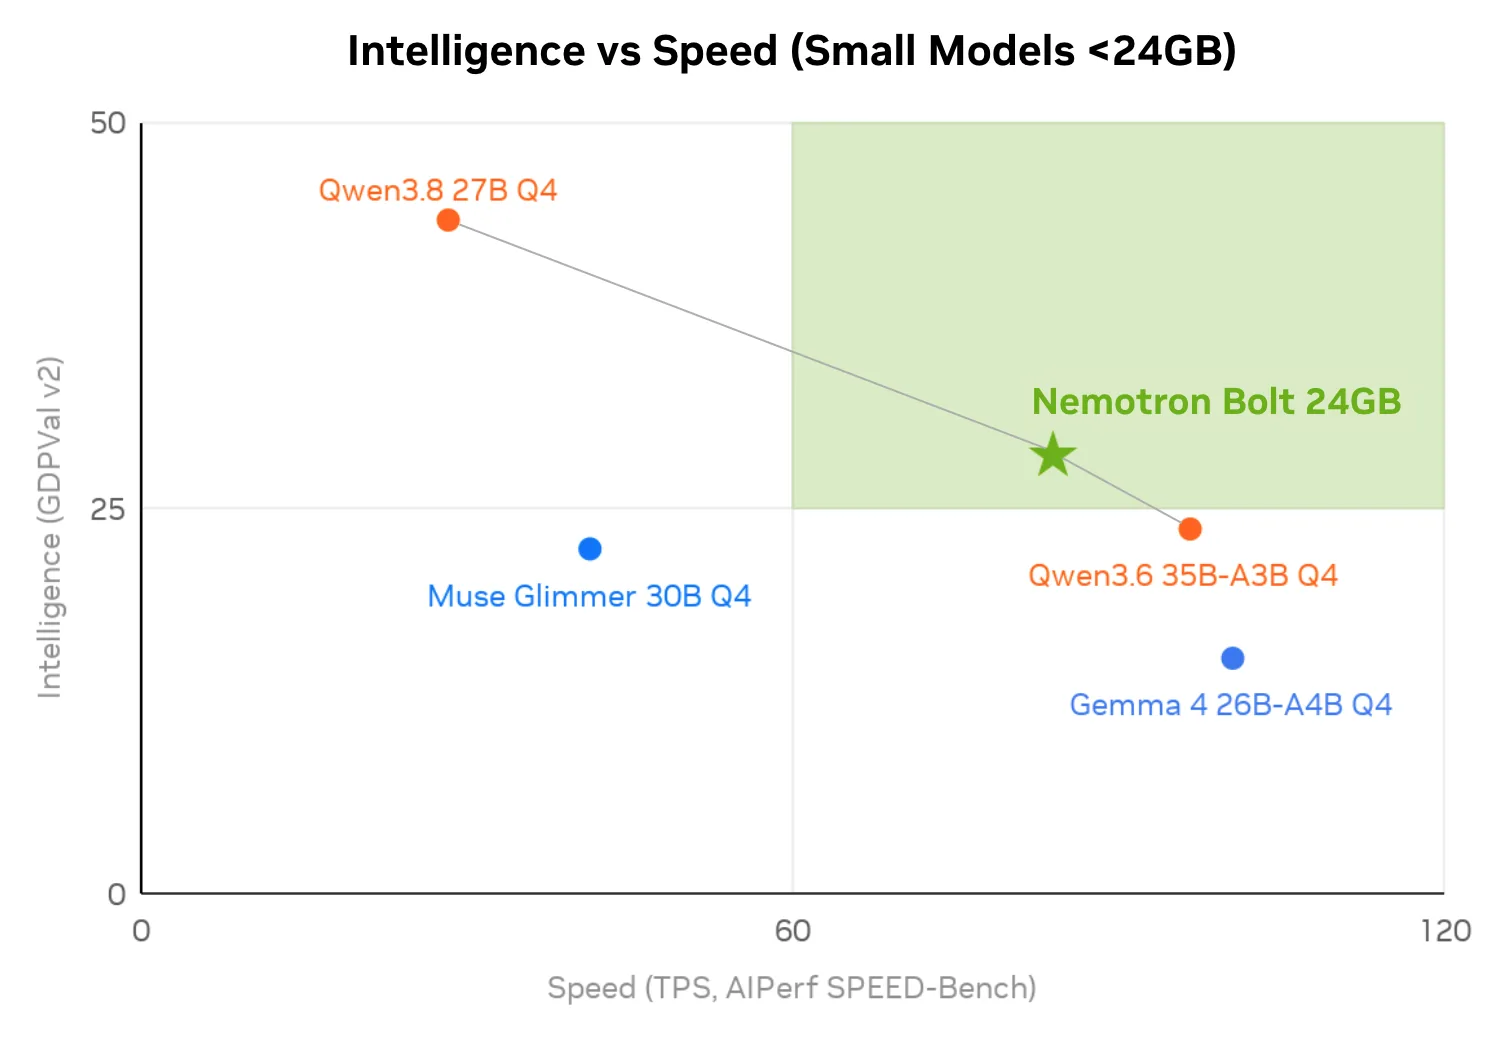
- Qwen3.8 27B 賢いけれど遅い
- Qwen3.6 35B 速いけれど…
- Bolt 真ん中
NVIDIA自身も、Boltを「速さと賢さのバランス」をとったモデルと位置づけています。技術ブログの図では、左上に賢いが遅いモデル、右下に速いが賢さは控えめなモデルが並び、Boltはその中間に置かれています。[s2]
速さは「1秒の量」だけでは決まらない
指数のテスト1問が使う出力(千トークン)
Artificial Analysisの記事(2026年10月15日)
実際の待ち時間は、1秒あたりの出力量だけでなく、答えるまでに必要な出力量でも変わります。Artificial Analysisの測定では、Boltは指数のテスト1問あたり約8.2万トークンを出力しており、Super VLの約1.8倍でした。考える量が多いぶん、時間もかかります。[s10]
成績 —— NVIDIAの比較表を読む
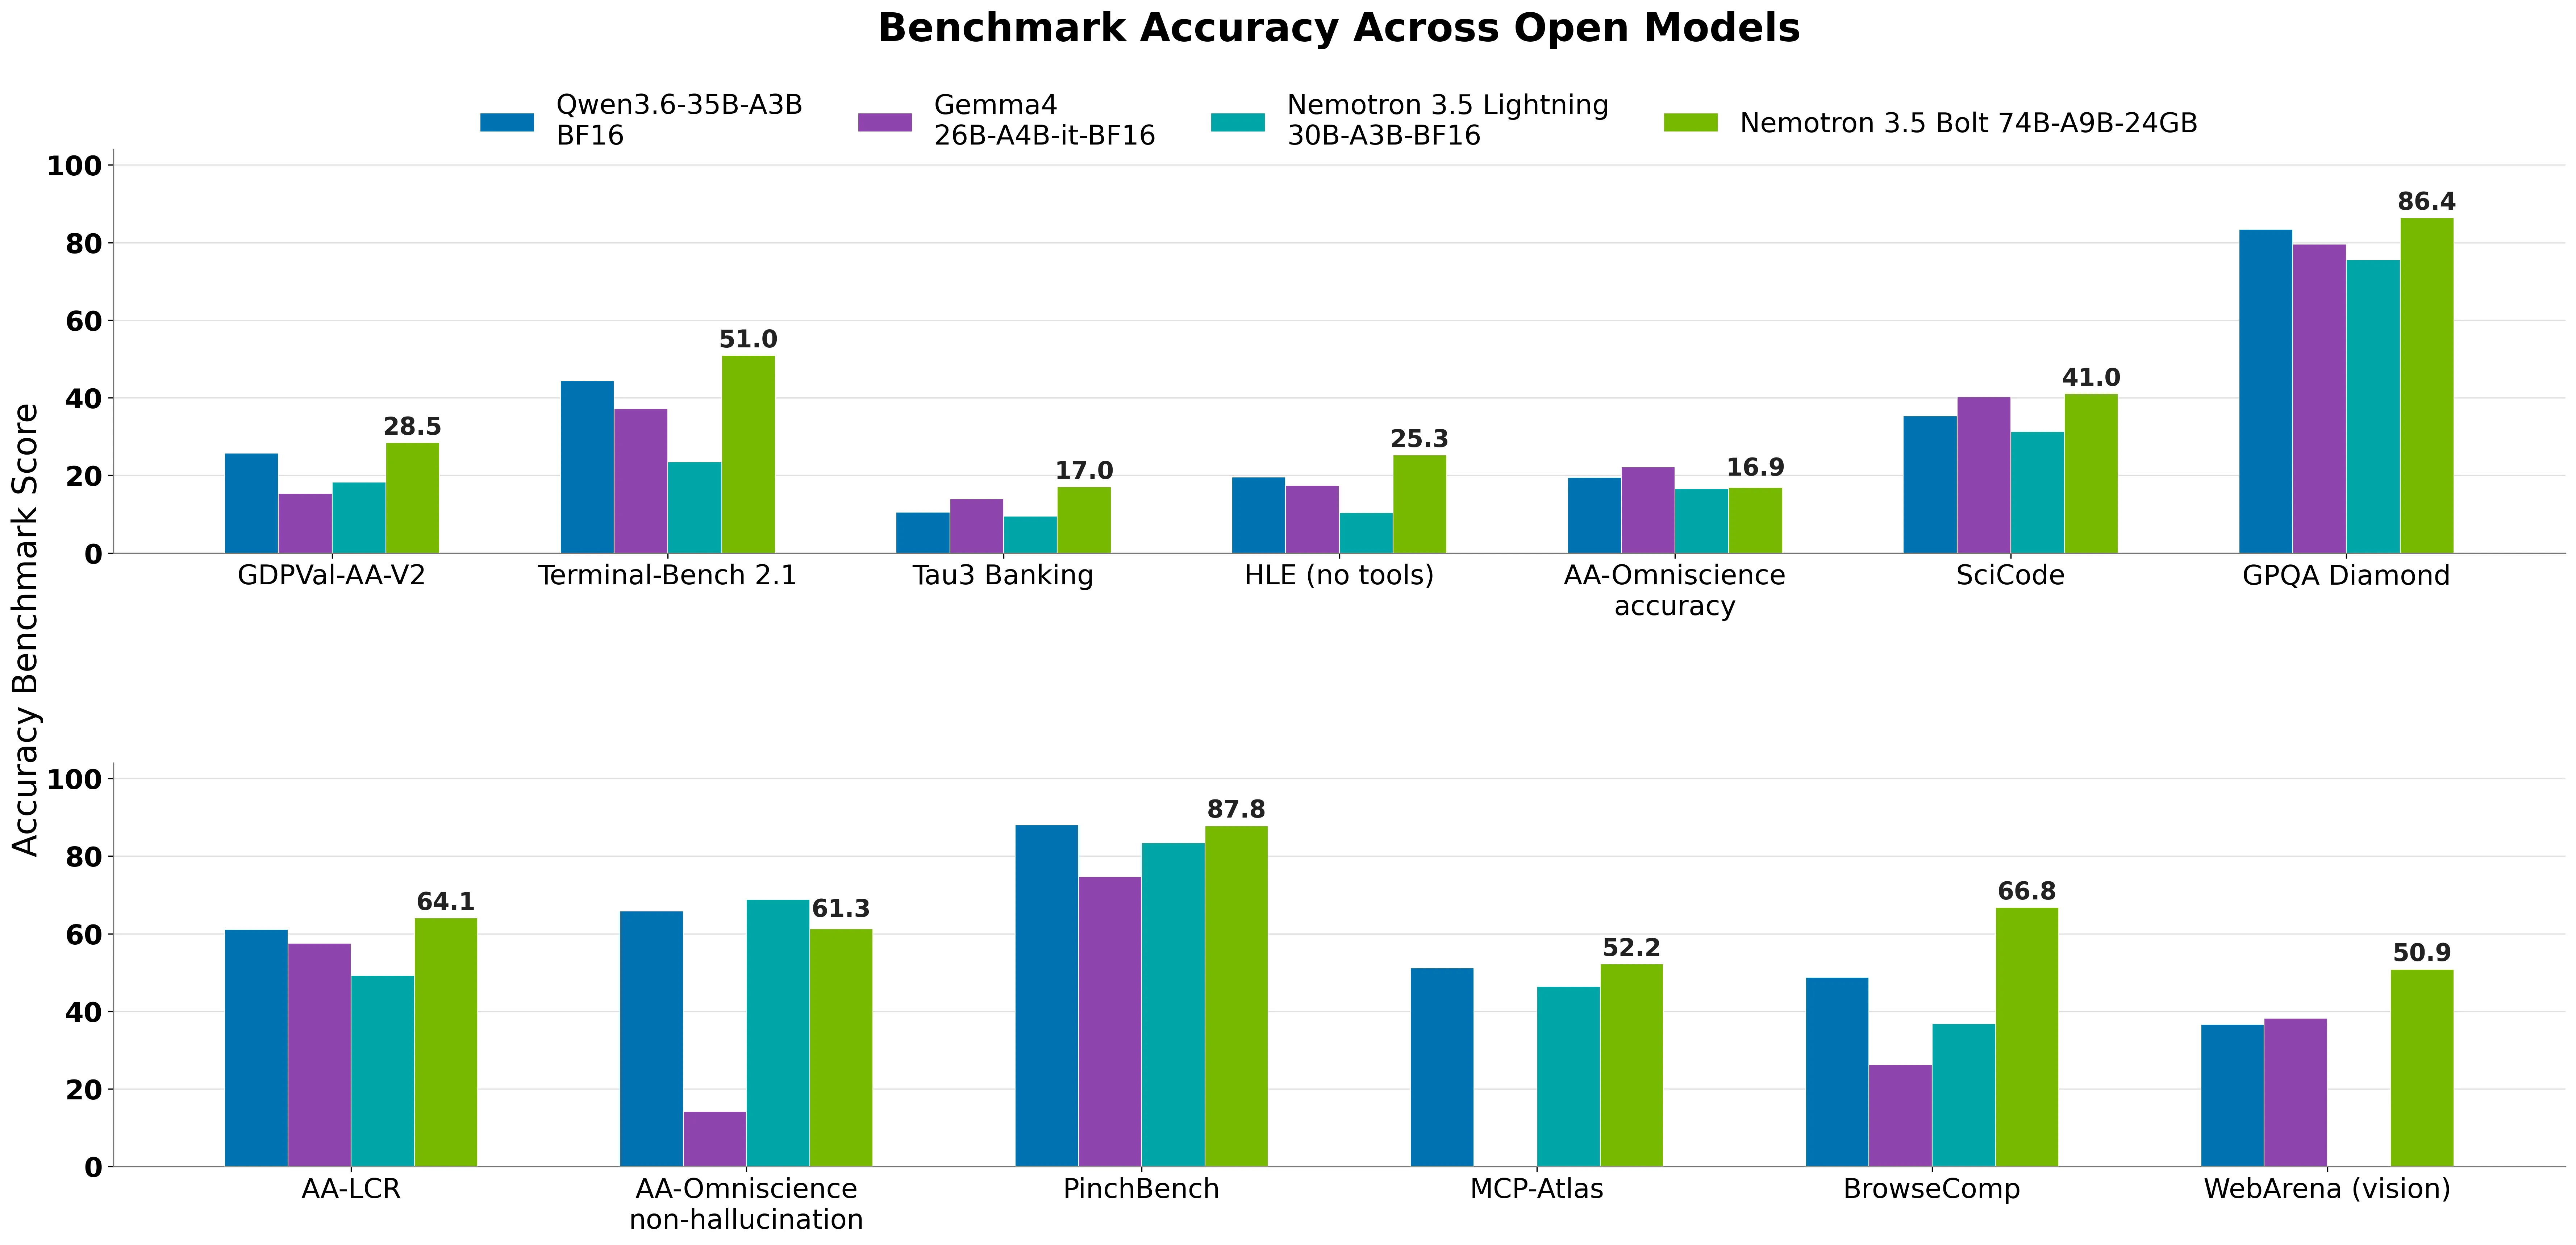
- 緑がBolt 24GB
NVIDIAは、同じくらいの大きさのQwenとGemmaとBoltを比べた表を公開しています。比べた相手は圧縮していない16ビット(BF16)の状態で測られています。[s2][s3]
NVIDIAの比較表(点数が高いほどよい)
NVIDIAの表(点数が高いほどよい)
| 項目 | Bolt 24GB | Qwen3.6 35B | Gemma 4 26B |
|---|---|---|---|
| Terminal-Bench 2.1 | 51.0 | 44.4 | 37.2 |
| BrowseComp | 66.8 | 48.7 | 26.3 |
| WebArena | 50.9 | 36.6 | 38.2 |
| GPQA(理科の難問) | 86.4 | 83.4 | 79.6 |
| PinchBench | 87.8 | 88.1 | 74.7 |
| IFBench(指示を守る) | 66.2 | 63.7 | 77.3 |
| 知識の正答率 | 16.9 | 19.5 | 22.2 |
NVIDIAの技術レポート(表7)。黄色い丸が1位
14項目のうち、Boltが1位なのは10項目です。[s3]ターミナル(CLI)の操作、Webでの調べもの、画面を見て操作するテストで強く、調べもののBrowseCompでは66.8対48.7と大きな差がつきました。[s3]一方で1位でない項目もあり、PinchBenchではQwenが0.25点上回っています。[s3]
「1位」は比べ方しだい
MCP-Atlas(道具を使う力のテスト)。NVIDIAの技術レポート(表7の注)
NVIDIAの言う「1位」は、同じくらいの大きさのモデルの中での話です。[s1][s3]たとえば道具を使う力を測るMCP-Atlasでは、Qwenが自社で公表した値は62.8点ですが、NVIDIAが測り直した値は51.2点でした。公表値で比べればBoltは負けることになり、測り方で順位が入れ替わる例と言えます。[s3]
2ビットにする前と後
2ビットにする前と後(NVIDIAの表)
| 項目 | 前(BF16) | 後(24GB版) |
|---|---|---|
| Terminal-Bench 2.1 | 53.9 | 51.0 |
| BrowseComp | 70.0 | 66.8 |
| HLE(難問) | 28.7 | 25.3 |
| 知識の正答率 | 21.8 | 16.9 |
NVIDIAの技術レポート(表7)。点数が高いほどよい
量子化の前後で比べると、すべての項目で点数が下がっています。とくに知識の正答率は21.8から16.9へ、4.9点下がりました。[s3]技術レポート自身も、この量子化は精度をある程度失うことを前提にしていると書いています。[s3]
第三者の評価
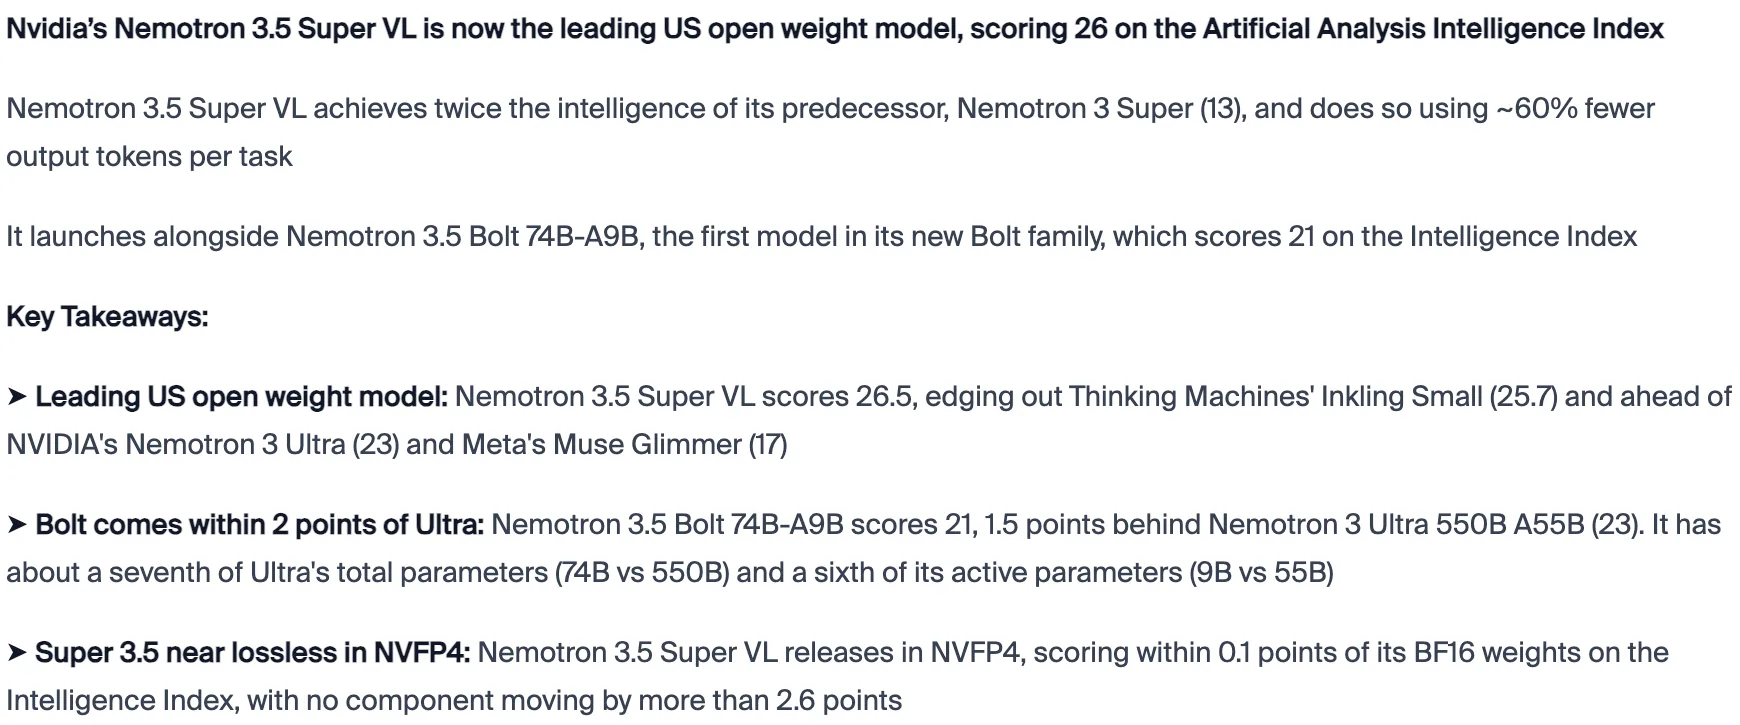
- Super VL は26.5。米国のオープンで1位
- Bolt は21。Ultra(23)に1.5点差
第三者の評価としては、Artificial Analysisが10月15日に総合指数を公表しました。Super VLは26.5で、米国のオープンモデルでは1位です。[s10]Boltは21で、1つ前の世代の大型モデルUltra(23)に1.5点差まで迫りました。Ultraは5,500億パラメータなので、Boltはその約7分の1の大きさです。[s10]
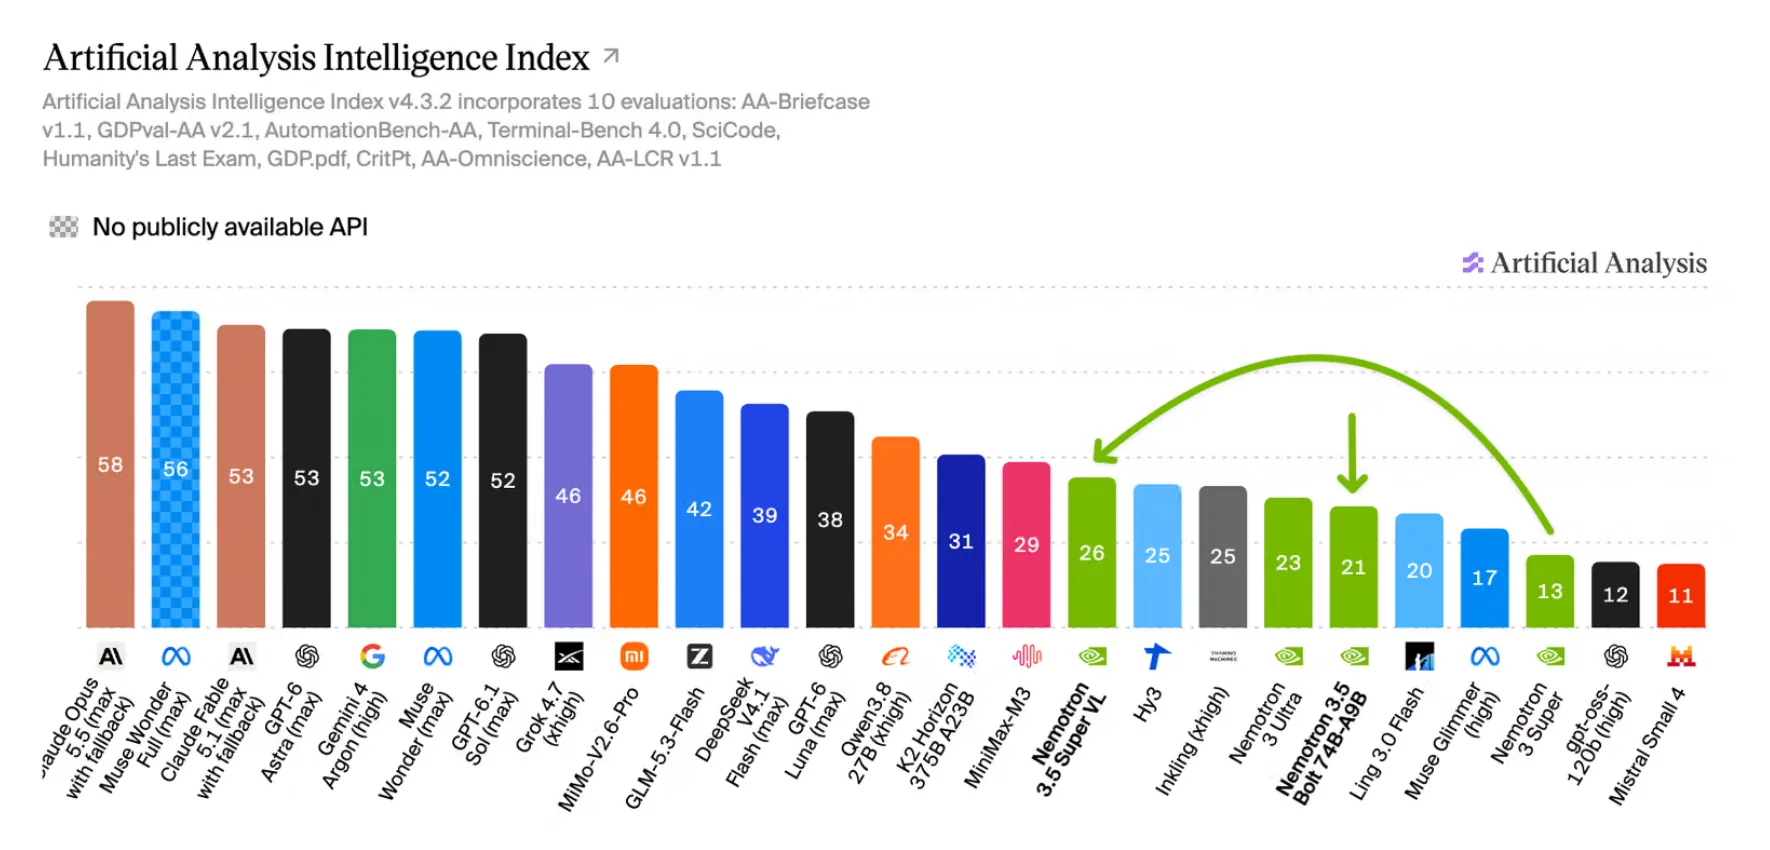
- Claude Opus 5.5 は58
- Qwen3.8 27B は34
- Bolt は21
この指数は10種類のテストをまとめた点数で、最上位のクラウドAIは58と、Boltの約2.8倍あります。[s10]賢さだけで比べれば、27BのQwen3.8(34)のほうがBoltより上です。各モデルの考える強さの設定は異なるため、目安として見る必要があります。[s10]100B未満のオープンモデルの中では、Boltは4位です。[s10][s12]
大きいほうのSuper VL
Nemotron 3.5 Super VL
Super VLは企業のサーバー向けのモデルで、文字・画像・動画を1つのモデルで読めます。[s1][s6]学習データと作り方も公開されており、自社のデータで調整しやすいことが特徴です。[s1][s7]Artificial Analysisの測定では約630トークン/秒と、最速クラスの出力速度でした。[s10]
活用・カスタマイズ(NVIDIAの発表)
Atlassian
JiraやConfluenceの横断検索
CrowdStrike
セキュリティの調査
Perplexity
検索とエージェント
Salesforce
行政の業務の自動化
NVIDIAは、AtlassianやCrowdStrikeなど各社の活用例も紹介しています。[s1]ただし、Scale AIの「推論費用を40分の1に」のような数字は会社の見込みであり、実績ではありません。[s7]
クラウドのAIとどう使い分けるか
ローカルで動くなら、ChatGPTやClaudeは不要になる?
クラウドAIとローカルAI
| 項目 | クラウドAI | ローカルAI |
|---|---|---|
| 賢さ | ◎ 最上位 | △ Boltは中くらい |
| 初期費用 | ◎ ほぼなし | × 機器代が要る |
| 毎月 | △ 使った分 | ○ 電気代 |
| データ | △ 事業者しだい | ○ 手元に置ける |
| 手間 | ○ すぐ使える | △ 自分で設定 |
ここまでの数字から整理した目安
ここまでの数字を見るかぎり、そうとは言えません。賢さでは最上位のクラウドAIとの差が大きく、初期費用や設定の手間もかかります。一方で、データを手元に置けることはローカルの明確な利点です。[s1][s10][s11]
費用だけで比べると
試算:1回=入力10万+出力1万、1日20回×22日。AIの性能は同じではない
費用の面では、例として、1回に10万トークンを読んで1万トークンを書く作業を、1日20回・平日22日続ける場合を試算しました。安いクラウドAIであるDeepSeek flashの通常料金なら、1か月で約9ドルです。RTX Spark 128GBの約5,900ドルは、その約53年分にあたります。[s9][s11]
ただし、AIの性能は同じではなく、PCはほかの仕事にも使えるため、これは単純な比較ではありません。ローカルにする理由は、安さよりも、データを外に出さないことと、使う量を気にせず自分で調整できる自由度のほうにあります。[s1]
ローカルにする理由
データを手元に
外に送らず処理できる
使う量を気にしない
課金メーターがない
自分で調整
重みが公開されている
注意したいのは、AI本体が手元にあっても、Web検索などの道具は外部と通信することです。技術レポートの調べものテストも、検索サービスのAPIを使って測られています。[s1][s3]また、AIがファイルやコマンドを操作できるぶん、動ける範囲を限る仕組みも必要で、NVIDIAはサンドボックスのOpenShellとMXCを用意しました。[s8]
NVIDIA自身も「すべてをローカルに」とは言っていません。Switchyardというルーターで、問い合わせをローカルとクラウドに振り分ける構成を示しており、エージェントのHermesが10月後半に対応する予定です。[s8]
試すときの手順
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \ NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf
llama-server \ --model "$MODEL" \ --ctx-size 65536 \ --cache-type-k q8_0手元で動かす場合、公式の手順はllama.cppを使う方法です。まず約22GBある重みのファイルをダウンロードし、次にサーバーを起動して文脈の長さなどを指定します。[s5]NVIDIAは、OllamaやLM Studioでも使えると説明しています。[s1]
試す順番
32GB以上のNVIDIA機か
本物のデータは使わない
今のAIと比べて決める
いきなり本番のデータで試すのは避け、まず機器のメモリが足りるかを確かめ、ダミーの仕事で動作を見て、いま使っているAIと同じ依頼を並べて比べる、という順に進めると安全です。
なお、小さいBolt E4B 4GBは10月23日に公開予定で、音声アシスタントやゲームのキャラクター向けとされています。[s1][s8]本記事の時点ではまだ試せません。
まとめ —— 使い分けの3つの観点
使い分けの3つの見方
32GB以上のNVIDIA機がある?
調べもの・画面操作・ターミナル(CLI)
外に出せない情報?
ローカルとクラウドのどちらを使うかは、3つの観点で判断できます。1つ目は機器で、32GB以上のメモリを持つNVIDIAの機器がなければ、まずはクラウドを使うのが現実的です。2つ目は仕事の種類で、NVIDIAの表ではBoltは調べものや画面操作が得意でしたが、いちばん難しい推論は最上位のクラウドAIが上回ります。[s3][s10]3つ目はデータで、外に出せない情報を扱う仕事ほどローカルの価値が大きくなります。
Boltは、74Bのモデルを約24GBに詰め込んだ意欲的なモデルですが、公式の動かし方は28GB用と32GB用です。[s5]NVIDIAの比較表では14項目中10項目で1位でしたが、第三者の総合指数は21でした。[s3][s10]数字の前提を確かめたうえで、すべてをローカルに移すのではなく、機器・仕事・データに合わせて使い分けることをおすすめします。
実践のポイント・まとめ
22GBのAIは何GBのメモリで動く?
モデルのファイルが22GBでも、動かすには会話の文脈を覚えておくメモリや、ほかのアプリの分も要るため、合計で30GBほどが目安になります。メモリが足りないと、動かないか、非常に遅くなります。
1分のショート動画で見る「74B-A9B」はどう読む?
前の数字(74B)はモデル全体の大きさで、必要なメモリに効きます。後ろの数字(A9B)は1回に使う分で、速さに効きます。後ろの数字が小さいからといって、軽いモデルだとは限りません。
1分のショート動画で見る「Q4」「Q2」とは何か
数値を何ビットで持つかを表す量子化の種類で、数字が小さいほど軽くなる代わりに精度が落ちます。メモリに入る範囲で、いちばん細かいものを選ぶのが基本です。研究では、同じメモリなら大きいモデルを粗くしたほうが良い場合もあります。
1分のショート動画で見るローカルAIなら絶対に安全?
データを外に送らない点は安全ですが、Web検索などの道具は外部と通信します。また、ファイルを操作する権限を渡すと、誤って消すこともあります。使える道具と触れるフォルダは、必要な分だけに絞りましょう。
1分のショート動画で見る出典・参考文献
- [s1] NVIDIA Blog「Open From Data Center to Desktop…」 ↗ blogs.nvidia.com
- [s2] NVIDIA Nemotron 技術ブログ「Nemotron 3.5 Bolt 74B-A9B 24GB」 ↗ research.nvidia.com
- [s3] NVIDIA技術レポート「Nemotron 3.5 Bolt 74B-A9B 24GB」 ↗ research.nvidia.com
- [s4] Hugging Face「NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB」モデルカード ↗ huggingface.co
- [s5] Hugging Face「NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF」モデルカード ↗ huggingface.co
- [s6] Hugging Face「NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16」モデルカード ↗ huggingface.co
- [s7] NVIDIA Technical Blog「Nemotron 3.5 Super VL Powers Specialized Agents…」 ↗ developer.nvidia.com
- [s8] NVIDIA Blog「All Systems Go: Global PC App Ecosystem Ready for NVIDIA RTX Spark」 ↗ blogs.nvidia.com
- [s9] DeepSeek API Docs「Models & Pricing」 ↗ api-docs.deepseek.com
- [s10] Artificial Analysis「NVIDIA Releases Nemotron 3.5 Super and Nemotron 3.5 Bolt」 ↗ artificialanalysis.ai
- [s11] Artificial Analysis「First AA-AgentPerf-Local results for an NVIDIA RTX Spark N1X laptop」 ↗ artificialanalysis.ai
- [s12] Artificial Analysis「Nemotron 3.5 Bolt 74B-A9B」モデルページ ↗ artificialanalysis.ai
検証ファクト一覧を表示する(全19項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | 2026-10-15、NVIDIA が Nemotron 3.5 の Super VL と、エッジ向けの Bolt 2つを発表。Super VL と Bolt 74B-A9B 24GB は公開ずみ、Bolt E4B 4GB は **10月23日**(日付は 10/19 時点でまだ) | [s1] [s8] | |
| F2 | Super VL:120B・活性12B のオープンモデル。文字・画像・動画を読む。文脈は最大100万トークン。重みと学習データ・レシピを公開(OpenMDW-1.1)。NVIDIA は「同じ大きさの open model より1枚のGPUで最大5倍の処理量」と説明 | [s1] [s6] [s7] | 速さ・精度は NVIDIA の発表。BF16 の動かし方は H100 4枚か GB200 2枚 |
| F3 | Bolt 74B-A9B 24GB:全体74B・1トークンで使うのは9B の MoE。Mamba と Transformer のハイブリッド。画像・動画も読める(出力は文字)。文脈は最大256Kトークン。日本語を含む6言語。ライセンスは OpenMDW-1.1 | [s3] [s4] | |
| F4 | Bolt は Super VL(120B-A12B)を圧縮したもの。Star Elastic(NVIDIA の圧縮の仕組み)で、専門家の数を層ごとに 512→240〜496 に、1トークンで選ぶ数を 22→9 に減らして 120B→74B。回復の学習に1,200億トークン(128GPU・約64時間)。圧縮のあと、平均点は 57.58→54.74(−2.85点、−4.94%)まで下がった(圧縮の直後・手直し前) | [s2] [s3] | |
| F5 | 量子化:専門家の重みを IQ2_XXS(1要素あたり2.0625ビット)に。量子化を意識した蒸留(QAD)で精度を戻す。**圧縮した74Bの BF16(148GB)→ 22.1GB(−85.1%)**。BF16 74.89B×2バイト≒149.8GB(HF のファイル合計と一致) | [s3] [s4] | 「16ビット→約2ビット」で約7.8分の1(計算) |
| F6 | 「24GB」の中身(設計目標):重み22.01GB+キャッシュと作業0.87GB=22.87GB、ドラフトモデル(0.96GB)を含めて23.83GB。**前提は 同時1件・文脈131,072・文字だけ。画像の部品(ビジョンエンコーダ)は入れていない** | [s3] | |
| F7 | 公式の動かし方(モデルカード):**28GB 用=RTX Spark 64GB か RTX のGPU 32GB 以上、文脈65,536、KV キャッシュ8ビット**/**32GB 用=RTX Spark 128GB か GPU 48GB 以上、文脈262,144**。llama.cpp。Windows・Linux。vLLM 版は Linux・Blackwell(SM120/121) | [s4] [s5] | |
| F8 | ファイルの大きさ(HF API):本体 GGUF 22.02GB、画像の部品(mmproj)1.73GB、ドラフトモデル(LiLiCorr)1.00GB。合計 約24.75GB | [s5] | 計算(デシマルGB) |
| F9 | ドラフトモデル(LiLiCorr):1.13B の小さなドラフトモデルが7語ぶんの下書きを一度に作り、本体が確かめる(推測デコーディング)。平均で4.68語(貪欲)/4.25語(サンプリング)が採用される。NVIDIA 自身の測定 | [s2] [s3] | |
| F10 | 速さ(NVIDIA が測定。Surface Laptop Ultra・メモリ128GB・llama.cpp・Windows):Bolt 83.99 トークン/秒、Qwen3.6-35B-A3B 96.63、Gemma 4 26B-A4B 100.56、Qwen3.8 27B 28.26。実際の作業の再生(8つの作業)にかかる時間:Bolt 600.80秒(約10.0分)、Qwen3.6 453.97秒(約7.6分)、Gemma 4 480.68秒(約8.0分)、Qwen3.8 1043.28秒(約17.4分)。比べた3つは4ビット(UD-Q4_K_M) | [s3] | 自社の測定。Bolt はドラフトモデルつき |
| F11 | 成績(NVIDIA の表。Bolt 24GB と、BF16 の Qwen3.6-35B-A3B・Gemma 4 26B-A4B):14項目のうち Bolt が1位は10(GDPVal・Terminal-Bench 2.1・Tau3 Banking・HLE・SciCode・GPQA・AA-LCR・MCP-Atlas・BrowseComp・WebArena)。1位でないのは4(AA-Omniscience の正答率 16.90〈Gemma 22.17〉と「でたらめを答えない率」61.27〈Qwen 65.85〉、PinchBench 87.82〈Qwen 88.07〉、IFBench 66.17〈Gemma 77.25〉)。MCP-Atlas の Qwen は NVIDIA の測り直し 51.2(Qwen の公表は 62.8) | [s3] [s4] | 自社の表。Terminal-Bench は 2.1(AA の指数の 4.0 とは別) |
| F12 | 圧縮・量子化での落ち(Bolt の BF16 → 24GB):Terminal-Bench 53.93→50.98、HLE 28.73→25.30、BrowseComp 70.00→66.75、AA-Omniscience 正答率 21.80→16.90、GPQA 88.83→86.43。親の Super VL(BF16)は Terminal-Bench 61.94 | [s3] | |
| F13 | 第三者(Artificial Analysis。指数 v4.3.2):Bolt は **21(21.4)**。100B 未満のオープンモデルで4位・米国で1位。Nemotron 3 Super(12.8)より8.6点上、NVIDIA の Ultra(550B-A55B)23 より1.5点下。同じ図で Qwen3.8 27B 34、DeepSeek V4.1 Flash 39、Claude Opus 5.5 58(最上位)。Super VL は26.5(米国のオープンで1位) | [s10] [s12] | |
| F14 | AA:Bolt は指数の測定で出力トークンが多い(1タスクあたり82k、Super VL は46k、Ultra は28k。合計2.3億トークン、中央値は1億)。Super VL の速さは約630トークン/秒(DeepInfra・NVFP4・100kトークンの入力)で、AA が測った中で指数20以上でいちばん速い | [s10] [s12] | |
| F15 | 機器:RTX Spark は Windows on Arm のノート向けの NVIDIA のチップ(N1X)。メモリは最大128GB(CPU・GPUで共有)。ノートは **10月16日**発売。AA が試した 128GB の試作機は **$5,899.99**。ほかの値段(AA の表・発売時の希望価格):DGX Spark $4,000、GeForce RTX 5090(メモリ32GB)カード $2,000 | [s8] [s11] | 為替・在庫は変わる。「公式の動かし方は NVIDIA の機器だけ」 |
| F16 | 使い道・組み合わせ(NVIDIA の説明):ローカルのエージェント(Hermes・OpenClaw など)に仕事を任せ、調べもの・文章・コードのデバッグを、クラウドに送らずにできる。Bolt E4B 4GB は音声アシスタント・ゲームのキャラ(ACE)向け。ローカルとクラウドを使い分ける Switchyard(オープンソースのルーター)、サンドボックス OpenShell・MXC を用意 | [s1] [s8] | Hermes の Switchyard 対応は10月後半の予定 |
| F17 | 企業の活用(NVIDIA の発表):Atlassian(Jira・Confluence の検索)、CrowdStrike(セキュリティ)、Salesforce、Perplexity、Dassault Systèmes など。Scale AI は Skydance の与信エージェントで推論費用を40分の1にする見込み(「will decrease」) | [s1] [s7] | 会社の見込み・発表 |
| F18 | 比べ方の注意:Bolt の精度の表は競合が BF16(圧縮なし)。NVIDIA の図は「4ビットで24GB に入るモデル」を比べる、と書く。速さの比較は競合が4ビット・MTP(先読み)つき | [s2] [s3] | |
| F19 | 安いクラウドの例(DeepSeek flash・オフピーク・2026-10-19 に確認):100万トークンあたり、入力 $0.15・出力 $0.60 | [s9] | 料金は変わる |
※ 画面の図・表・文章はNVIDIAとArtificial Analysisの公式の資料の引用で、加工していません。ロボットなどの絵は生成イラストで、各社の製品やロゴとは関係ありません。
※ 成績・速さ・メモリの数字はNVIDIAが自分で測ったもの(相手の点数も同じ表)です。第三者の評価はArtificial Analysisの指数だけです。
※ 料金はDeepSeek API(10月19日確認)、機器の値段はArtificial Analysisの表(発売時の希望価格)で、変わることがあります。「約53年分」は例の試算(1日20回×平日22日・1ドル150円)で、AIの性能は同じではありません。