チャットAIに「この洗濯物、たたんでおいて」と頼んでも、返ってくるのはたたみ方の説明です。文章はいくらでも書けても、体がなければ洗濯物には触れません。
本記事では、現実の世界で「見て・考えて・動く」AI=フィジカルAIについて、家事がAIにとって難しい理由、頭脳となるVLAの仕組み、データ不足を乗りこえる工夫、2026年の最前線、そしてロボットを使うときやロボットの動画を見るときの注意点を解説します。
情報は2026年9月30日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- フィジカルAIは、現実の世界で「見て・考えて・動く」AI。
- 家事が難しいのは、やわらかい物、力かげん、お手本のデータ不足のため。
- 成功率99%でも失敗は重なる。見張り役の仕組みと、動画の見方が大事。
基礎知識:フィジカルAIとVLA(視覚・言語・行動モデル)の仕組み
フィジカルAIとは、文章や画像を作るだけでなく、カメラやセンサーで現実の世界の様子を見て、次の動きを考え、モーターで体を動かして作業するAIのことです。人型ロボットだけでなく、配膳ロボットや自動運転車、配送ロボットも含まれます。工場の産業用ロボットが、教えられた位置と手順を正確にくり返すのに対し、フィジカルAIは、物の形や置き場所が毎回変わる場面でも、様子を見て動きを変えます。
人には簡単な洗濯物たたみや片付けが、AIにはとても難しいことは「モラベックのパラドックス」と呼ばれます。布は置くたびに形が変わり、力かげんも難しく、そして何より、文章のように大量の「ロボットの動きのデータ」がネットにはありません。
この壁を越える中心の技術が「VLA(視覚・言語・行動モデル)」です。チャットAIと同じような頭脳に、カメラの映像と言葉の指示を入れ、腕や指の動きを出させます。最近は、何をするかをじっくり決める頭脳と、腕や指をすばやく動かす頭脳の2つに分ける形(NVIDIAのGR00T N1、Google DeepMindのGemini Roboticsなど)や、コンピューターの中の仮想世界で大量に練習させる方法で、研究と実証が進んでいます。
AIは賢いのに、洗濯物は?
チャットAIに洗濯物たたみを頼むと
チャットAIに「この洗濯物、たたんでおいて」と頼むと、返ってくるのはTシャツのたたみ方の説明です。チャットAIには、手も足もありません。どんなに賢くても、体がなければ洗濯物には触れないのです。
フィジカルAI:現実の世界で、見て・考えて・動くAI
現実の世界で、見て・考えて・動くAI
いま、AIに体を持たせる技術が急速に進んでいます。それが「フィジカルAI」です。フィジカルは「物理的な」という意味で、現実の世界で働くAIのことを指します。本記事では、AIに家事が難しい理由、頭脳の仕組みと最前線、そして注意点を順に見ていきます。
フィジカルAIとは
フィジカルAIの基本のくり返し
フィジカルAIの基本のくり返し
フィジカルAIは、3つのことをくり返して働きます。カメラやセンサーでまわりの様子を見て、AIが次にどう動くかを考え、モーターで実際に体を動かします。そして、動いた結果をまた見て、次の動きを考えます。
もう身近にある「見て・考えて・動く」機械
もう身近にある「見て・考えて・動く」機械
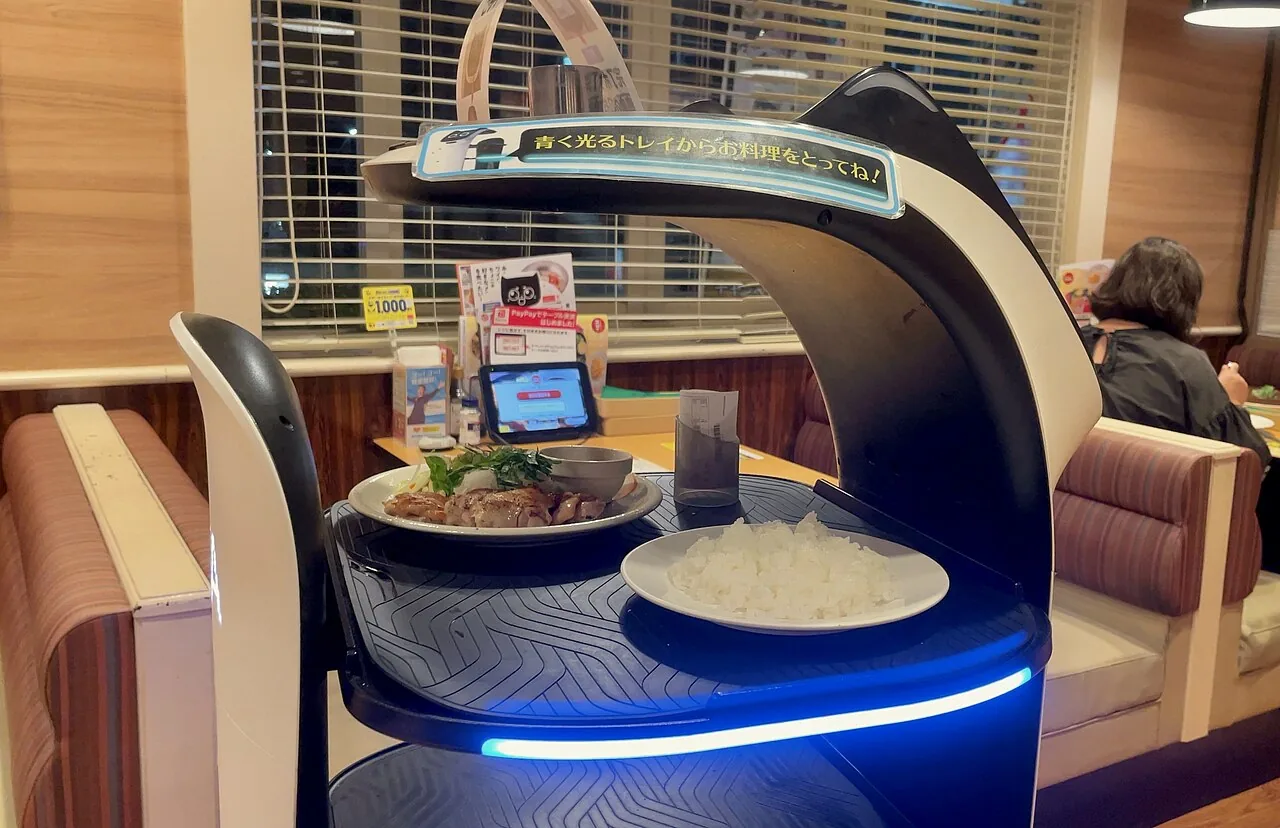
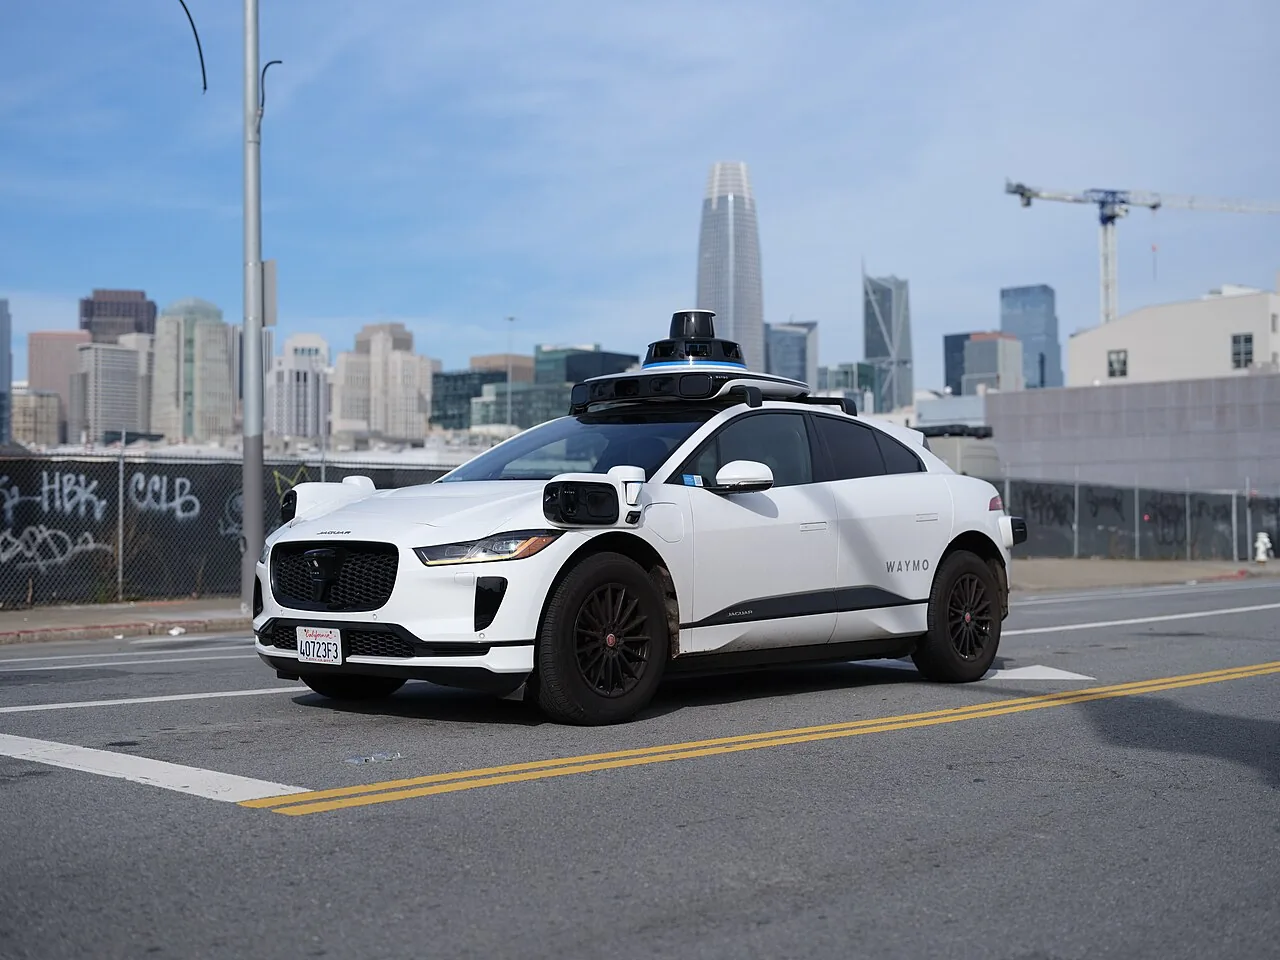
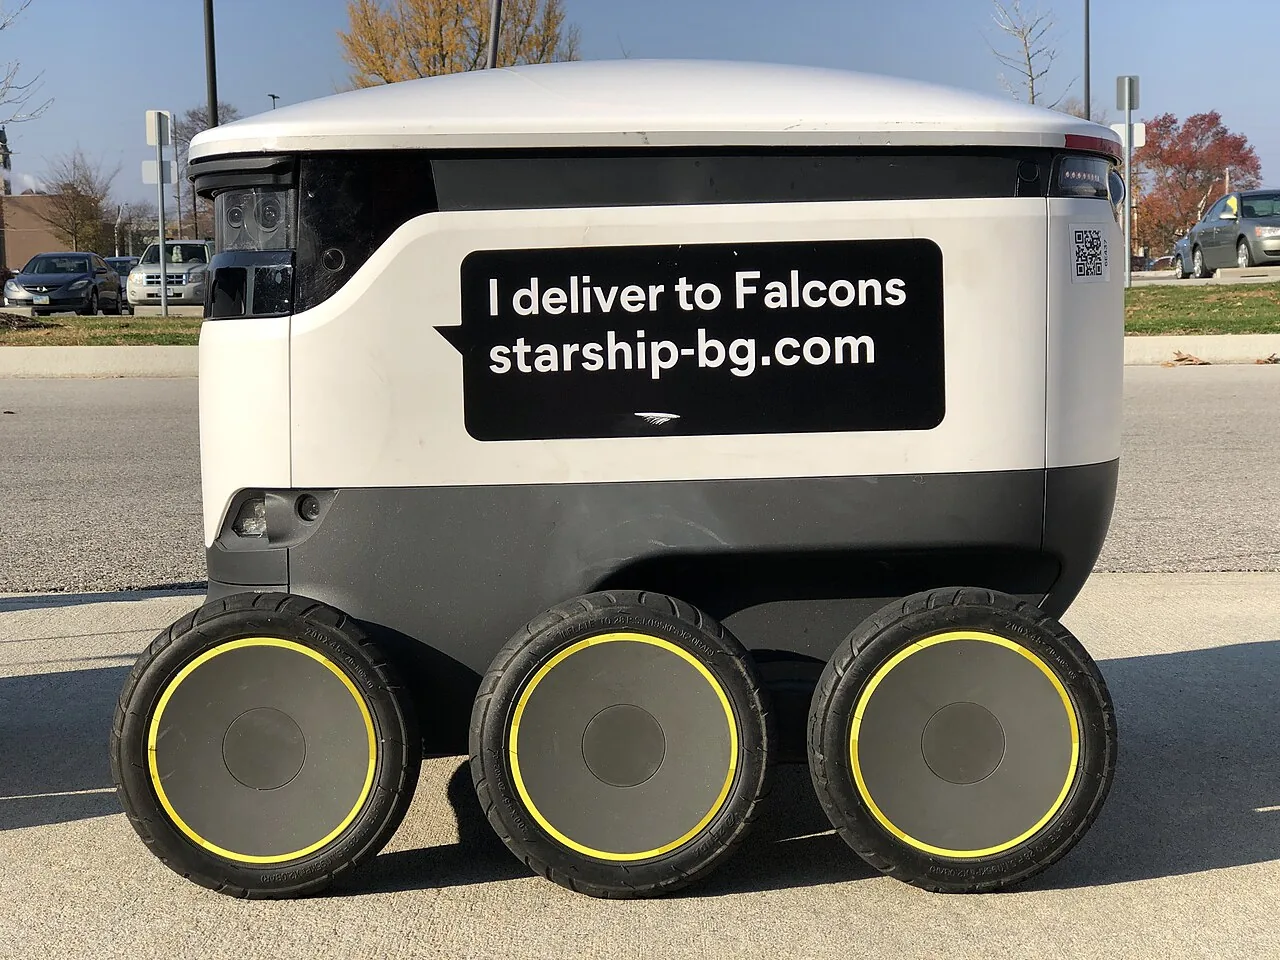
写真: Wikimedia Commons
こうした機械は、すでに身近にあります。ファミレスで料理を運ぶ配膳ロボット、アメリカで運転手なしに走るタクシー、歩道を走って荷物を届ける配送ロボットなどです。賢さの程度はさまざまですが、人型のロボットだけがフィジカルAIではありません。
工場のロボットと、フィジカルAIの違い
工場のロボットと、フィジカルAIの違い
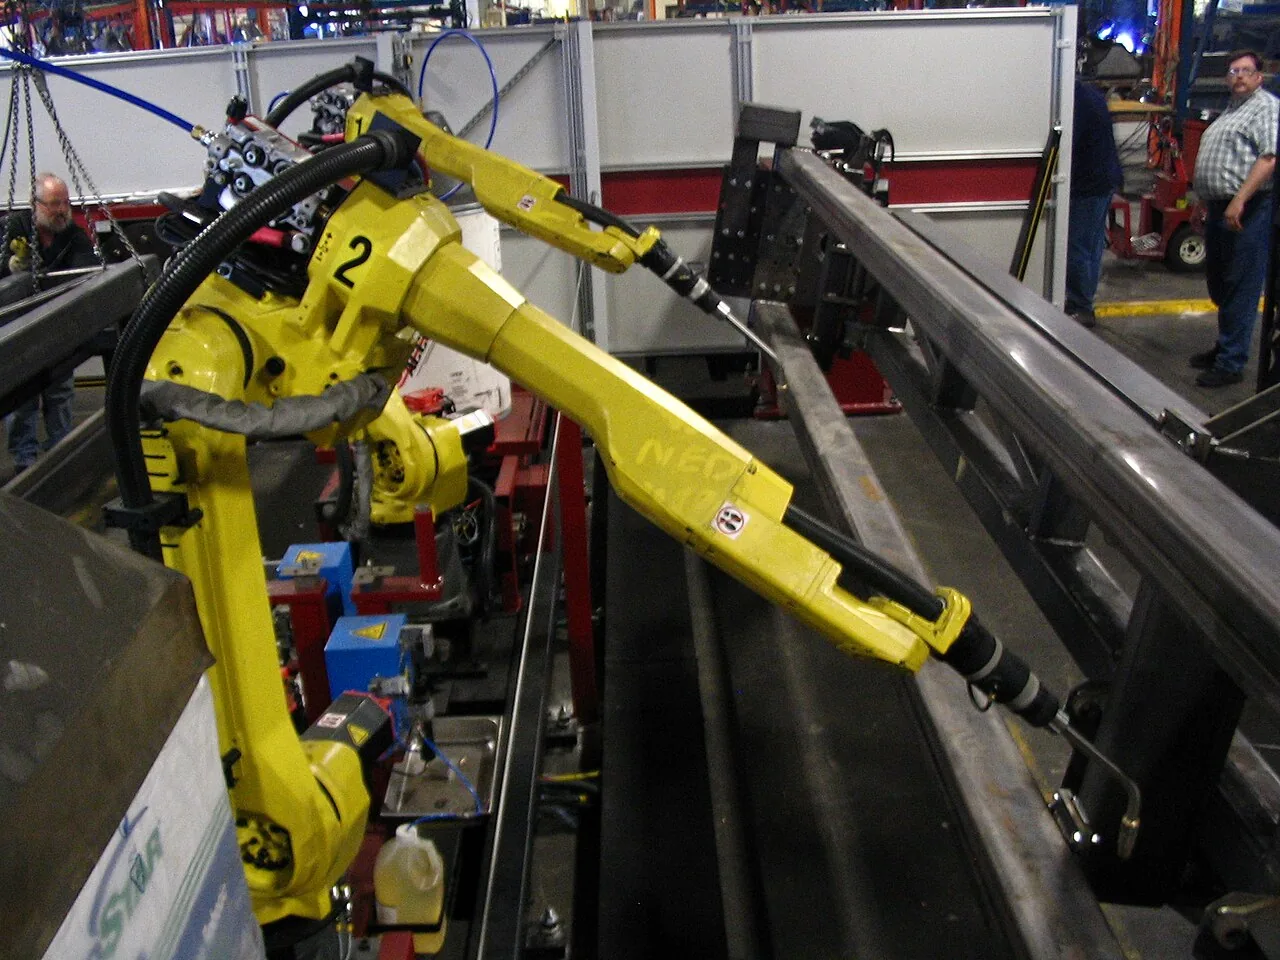
教えた通りに動く
- 決まった作業は速くて正確
- 置き場所がずれると苦手
見て判断して動く
- その場に合わせて動きを変える
- まだ遅く、失敗もある
左の写真: Phasmatisnox / CC BY 3.0(Wikimedia Commons)
工場の産業用ロボットは、人が教えた動きを正確にくり返すのが得意です。世界のロボット生産の約4割(38%)は、日本が占めています。[s15]ただ、物の置き場所がずれたり、初めての物が来たりすると苦手です。フィジカルAIは、見て判断し、その場に合わせて動きを変えます。とはいえ、決まった作業なら、いまも工場のロボットのほうが速くて確実です。
なぜAIに家事は難しいのか
AIの得意と苦手は、人間とあべこべ
AIの得意と苦手は、人間とあべこべ
得意
- 文章・計算・チェス
- 人には難しいこと
苦手
- 洗濯物・片付け
- 子どもでもできること
参考: モラベックのパラドックス(1988年)
AIは難しい文章や計算が得意なのに、子どもでもできる片付けや洗濯物たたみはとても苦手です。これは「モラベックのパラドックス」と呼ばれる、1988年からある指摘です。[s18]
洗濯物たたみが難しい3つの理由
洗濯物たたみが難しい3つの理由
形が毎回違う
やわらかく、置くたびに形が変わる
力かげん
強いと破れ、弱いと落とす
お手本が少ない
動きのデータは、ネットにない
洗濯物たたみには、3つの難しさがあります。1つ目は、服がやわらかく、置くたびに形が変わることです。2つ目は力かげんで、強すぎると破れ、弱すぎると落とします。3つ目が最も大きな問題で、お手本になる動きのデータが少ないことです。
学ぶための材料
学ぶための材料
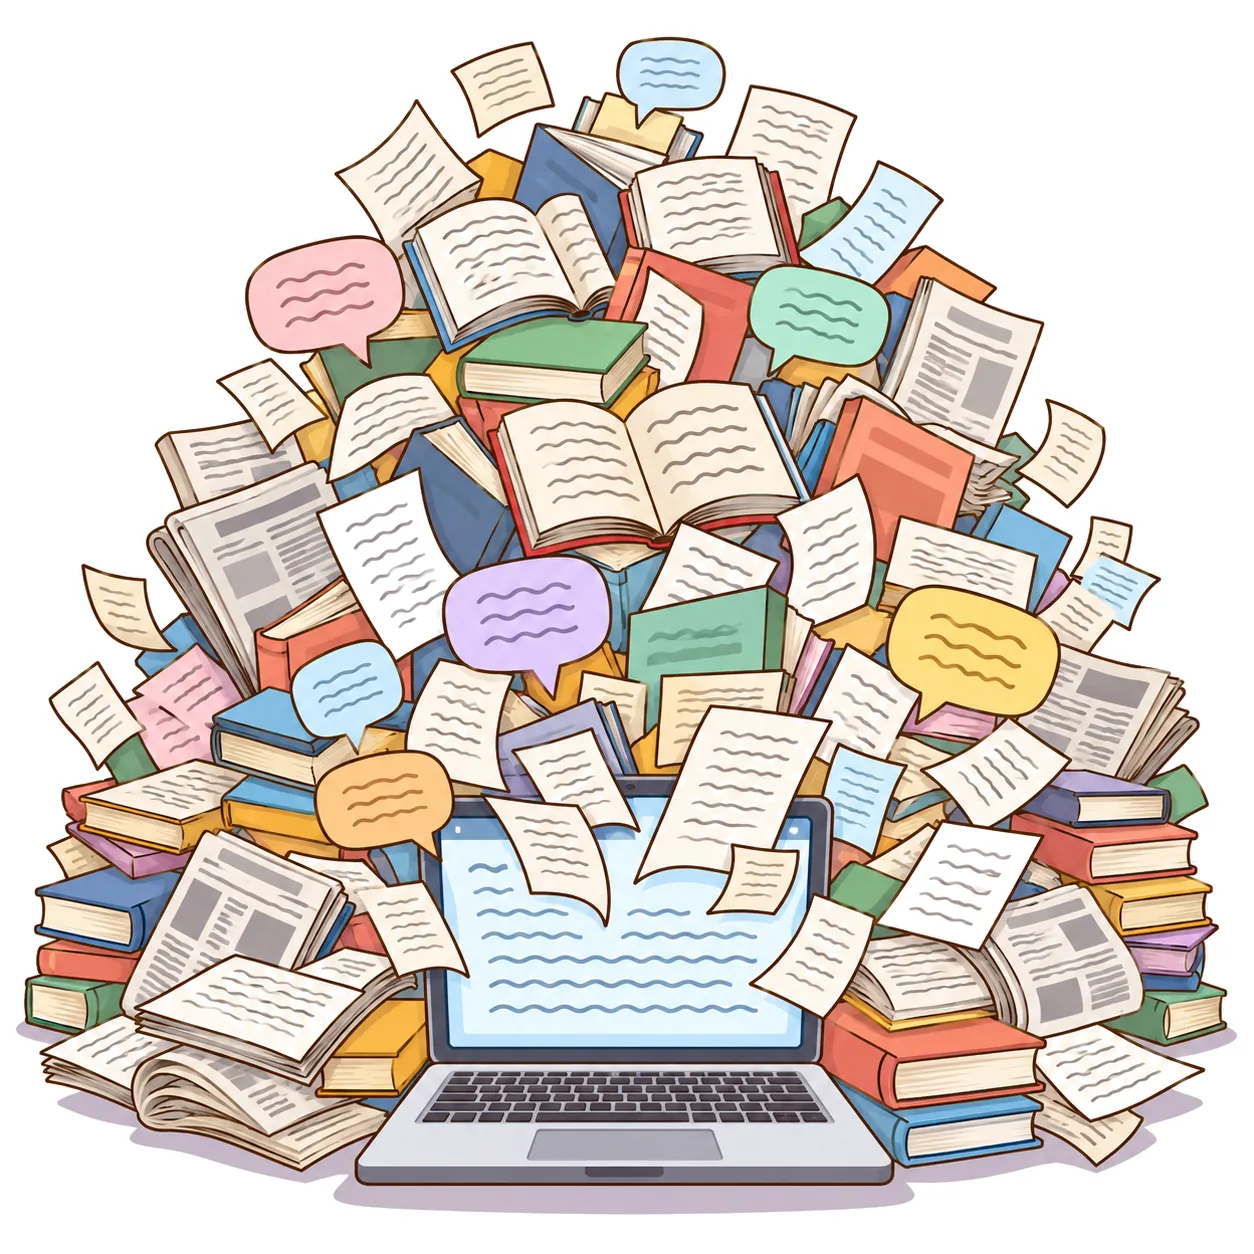
文章
- ネットに大量にある
- 読むだけで学べる
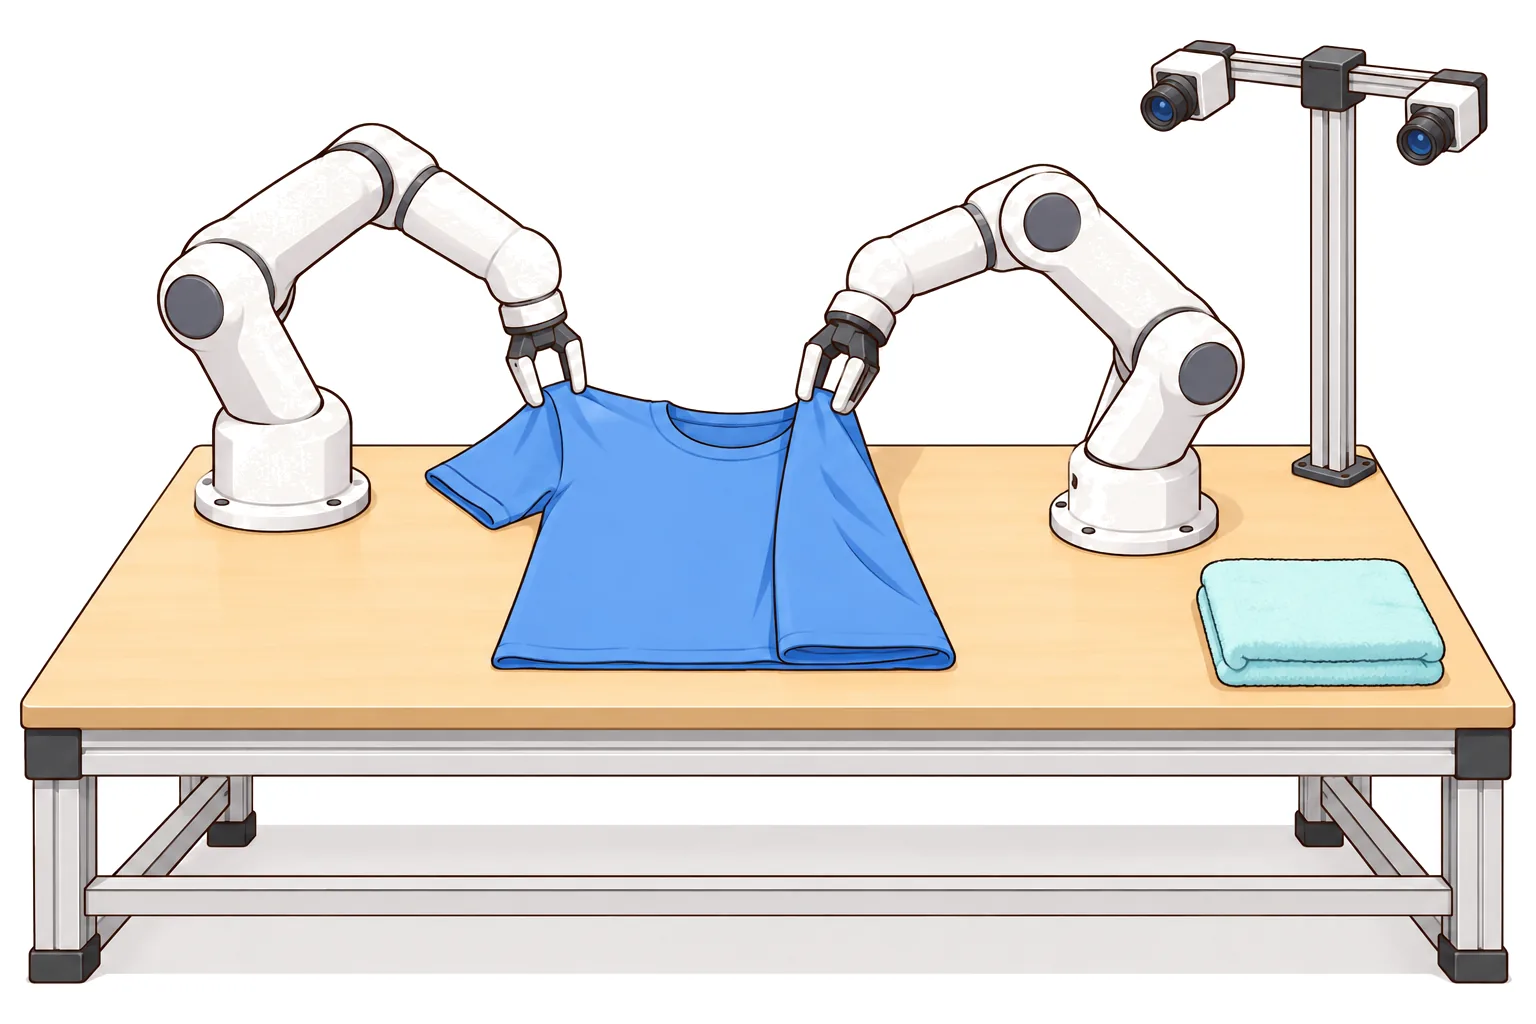
ロボットの動き
- ネットに落ちていない
- ロボットを動かして集める
参考: Google DeepMind「RT-2」(2023年)
文章のAIは、ネットにある大量の文章を読んで学べます。しかし、ロボットの動きのデータはネットにはありません。ロボットが同じ水準の力を持つには、あらゆる物や場面について、データを自分で集める必要があります。[s1]
お手本の集め方(遠隔操作)
お手本の集め方(遠隔操作)
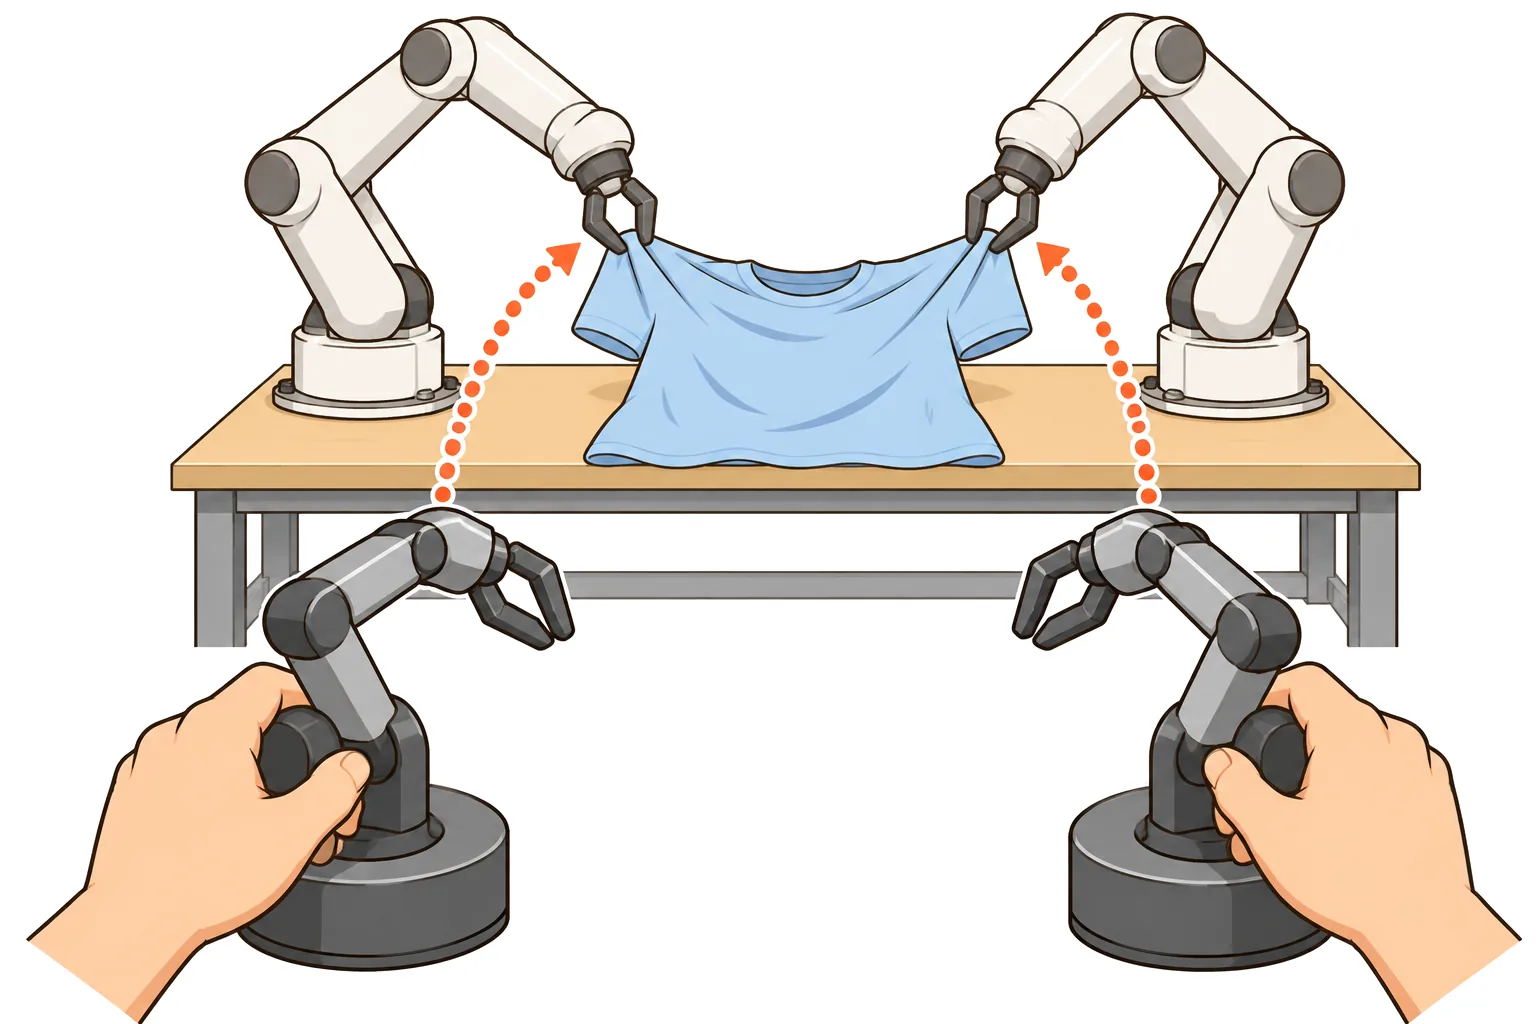
そこで、人がロボットを遠くから操作してお手本を見せます。操作用の腕を人が動かすと、ロボットの腕が同じように動きます。その動きを記録して、AIにまねさせるのです。
少ないお手本で覚えた例(2023年の研究)
少ないお手本で覚えた例(2023年の研究)
出典: Zhao ほか「ALOHA / ACT」(2023年)
2023年の研究「ALOHA / ACT」では、約10分ぶんのお手本で、電池をはめるなど6つの細かい作業を、80〜90%の成功率で覚えました。[s12]ただし、家の中のさまざまな家事をこなすには、まだまだ足りません。
フィジカルAIの頭脳「VLA」
VLA:見る・言葉・動きを、1つのAIで
見る・言葉・動きを、1つのAIで
ロボットが言葉を動きに変えるための技術が「VLA」です。見る(視覚)、言葉(言語)、動き(行動)の3つを、1つのAIで扱います。
VLAの仕組み
VLAのしくみ
カメラの映像と「シャツをたたんで」という言葉を入れると、チャットAIと同じような頭脳がそれを読み、文字の代わりに腕や指の動きを出します。
「絶滅した動物を拾って」:ロボットへの指示(RT-2の例)
ロボットへの指示(RT-2の例)
有名な例が、2023年のGoogleの研究「RT-2」です。机にライオンとクジラと恐竜のおもちゃを並べ、「絶滅した動物を拾って」と頼むと、ロボットは恐竜を拾いました。[s1]ロボットの練習で「絶滅」という言葉は教えていません。ネットで学んだ知識を、動きに生かせたのです。
初めて見る場面での成功率(Googleの評価)
初めて見る場面での成功率(Googleの評価)
出典: Google DeepMind(2023年7月)※Googleの評価
初めて見る場面での成功率も、前の方式の32%から62%に上がりました。[s1]ただ、これはGoogle自身の評価で、それでも4割近くは失敗しています。
2つの頭脳で役割分担
2つの頭脳で役割分担
じっくり考える
- 何をするかを決める
- 少しゆっくりでいい
すばやく動く
- 腕や指を細かく調整
- 1秒に何十回も
参考: NVIDIA「GR00T N1」(2025年)、Google DeepMind「Gemini Robotics」
最近は、頭脳を2つに分けて役割分担する形が主流です。じっくり考えて次に何をするかを決める頭脳と、腕や指をすばやく細かく動かす頭脳です。
2つの頭脳を持つ主なAI
2つの頭脳を持つ主なAI
GR00T
NVIDIA(2025年3月〜)人型ロボット向け
Gemini Robotics
Google DeepMind(考える役と動く役)
出典: NVIDIA、Google DeepMind の発表
2025年3月に発表されたNVIDIAの人型ロボット向けAI「GR00T N1」や、Google DeepMindのロボット用AI「Gemini Robotics」も、この形をとっています。[s6][s5]
データ不足を乗りこえる工夫
データ不足を乗りこえる3つの工夫
データ不足を乗りこえる3つの工夫
持ち寄る
いろいろなロボットのデータを集める
大量に集める
何十万時間ぶんの動き
仮想世界で練習
コンピューターの中で失敗し放題
お手本のデータが少ない問題には、3つの工夫があります。1つ目は、データを持ち寄ることです。2023年、21の研究機関が22種類のロボットのデータを持ち寄り、違うロボットのデータも一緒に学ぶことで、成績が上がりました。[s9]
ロボットの動きのデータ量
ロボットの動きのデータ量
出典: 各論文・各社の発表 ※集め方や質はそれぞれ違う
2つ目は、とにかく大量に集めることです。2024年に公開された研究用のデータ「DROID」は350時間、同じ年にPhysical Intelligenceは約1万時間のお手本で学習しました。[s10][s2]2025年には、27万時間以上という会社(Generalist)も現れました。[s11]27万時間は、ロボット1台が休まず動き続けて約31年分にあたります。ただし、集め方や質は会社ごとに違うため、単純には比べられません。
世界モデル:動いたら次にどうなるかを予測するAI
動いたら次にどうなるかを予測するAI
3つ目は、コンピューターの中の仮想世界で練習することです。仮想世界なら、何千台ものロボットを同時に練習させられ、物を落としても壊れず、けがをする人もいません。最近は、ありそうな場面を映像で作るAI「世界モデル」も使われており、NVIDIAの「Cosmos」などが知られています。[s7]
仮想世界と現実の差
仮想世界と現実の差
仮想世界
- 整っていて、計算どおり
- 重さや摩擦は近似
現実
- しわ・光・ほこり
- 思いどおりにいかない
ただし、仮想世界は整っていて計算どおりに動く一方、現実にはしわや光、ほこりがあり、思いどおりにはいきません。この差を埋めることが、最も難しい課題です。
2026年の最前線
π0の洗濯物たたみ(2024年)
π0 の洗濯物たたみ(2024年)
出典: Black ほか「π0」(2024年10月)
研究の世界では、ロボットはすでに洗濯物をたためるようになっています。2024年、Physical Intelligenceという会社のAI「π0」は、乾燥機から洗濯物を取り出し、たたむところまでを見せました。[s2]
2025〜2026年の主な発表
2025〜2026年の主な発表
π0.5
2025年4月:初めて入る家で片付け
π0.7
2026年4月:練習していない機種で洗濯物をたたむ
Gemini Robotics 2
2026年7月:人型ロボットが全身で片付け
出典: Physical Intelligence、Google DeepMind の発表
ただし、π0の成果は、練習した場所と、練習したロボットでの話でした。その先の進歩が、ここ1年半の見どころです。2025年4月には、学習データにない家で台所や寝室を片付けるAI「π0.5」が登場しました。[s3]2026年4月には「π0.7」が、その作業を一度も練習していない機種で、洗濯物たたみをこなしてみせました。[s4]ほかのロボットで学んだコツを、別の体でも使えたのです。そして2026年7月、Google DeepMindが「Gemini Robotics 2」を発表し、人型ロボットが歩く・かがむ・つかむを全身で組み合わせて、散らかった部屋を片付けました。[s5]
世界の人型ロボット
世界の人型ロボット
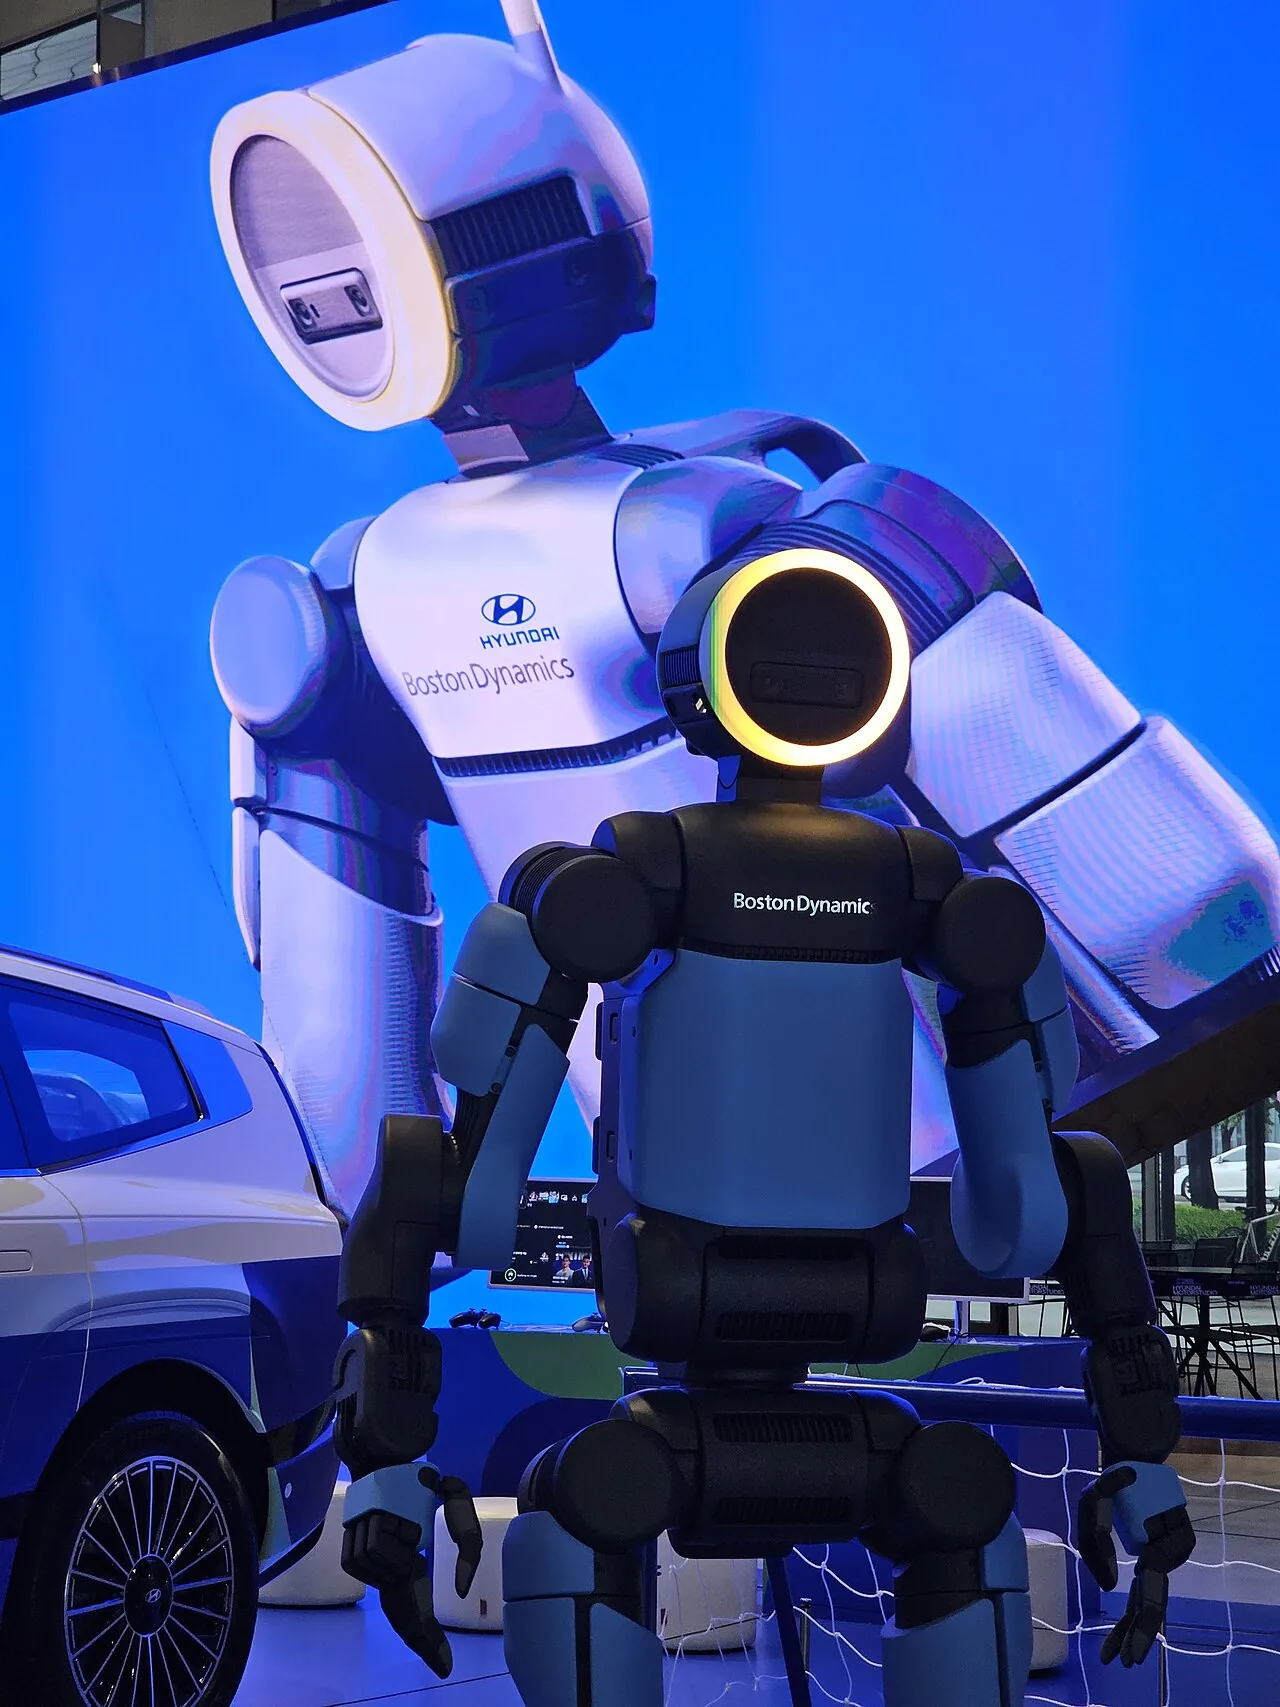
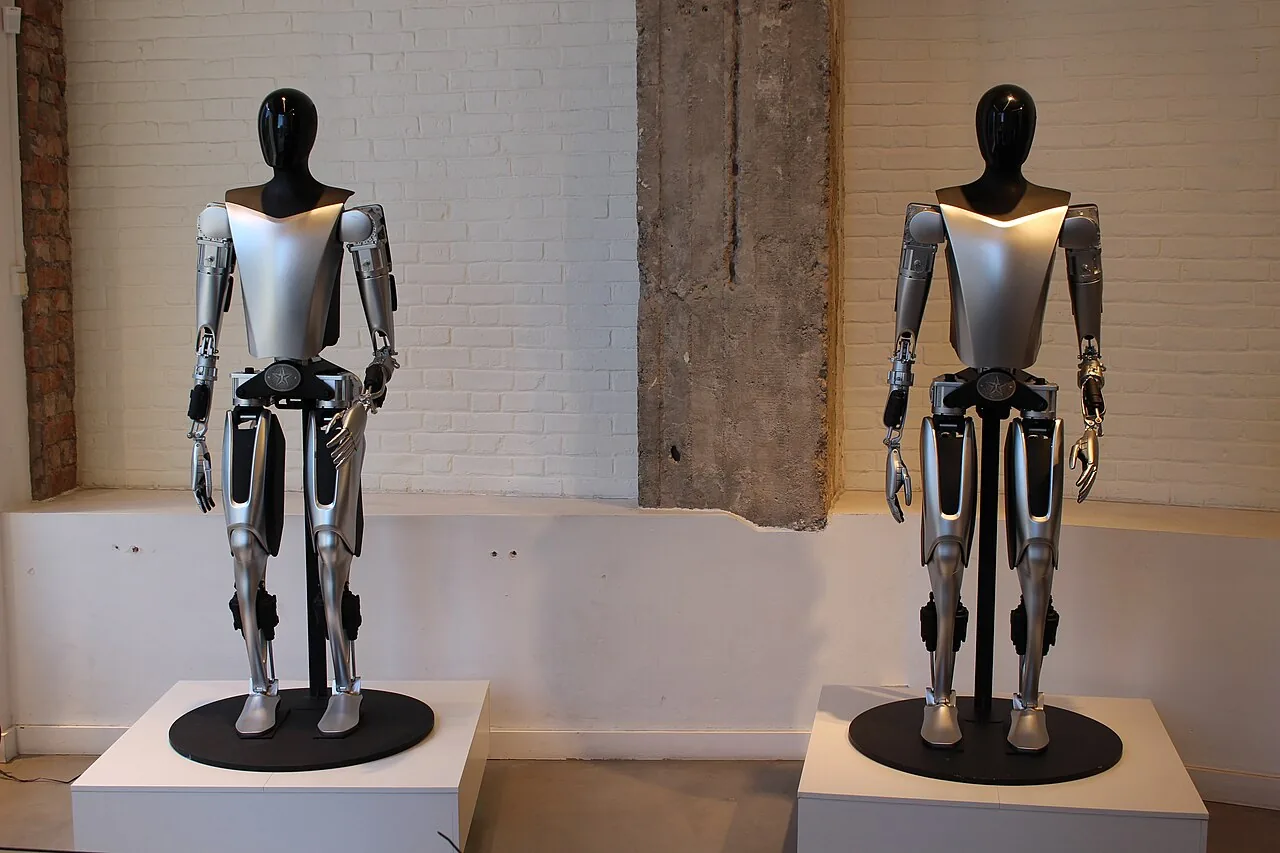
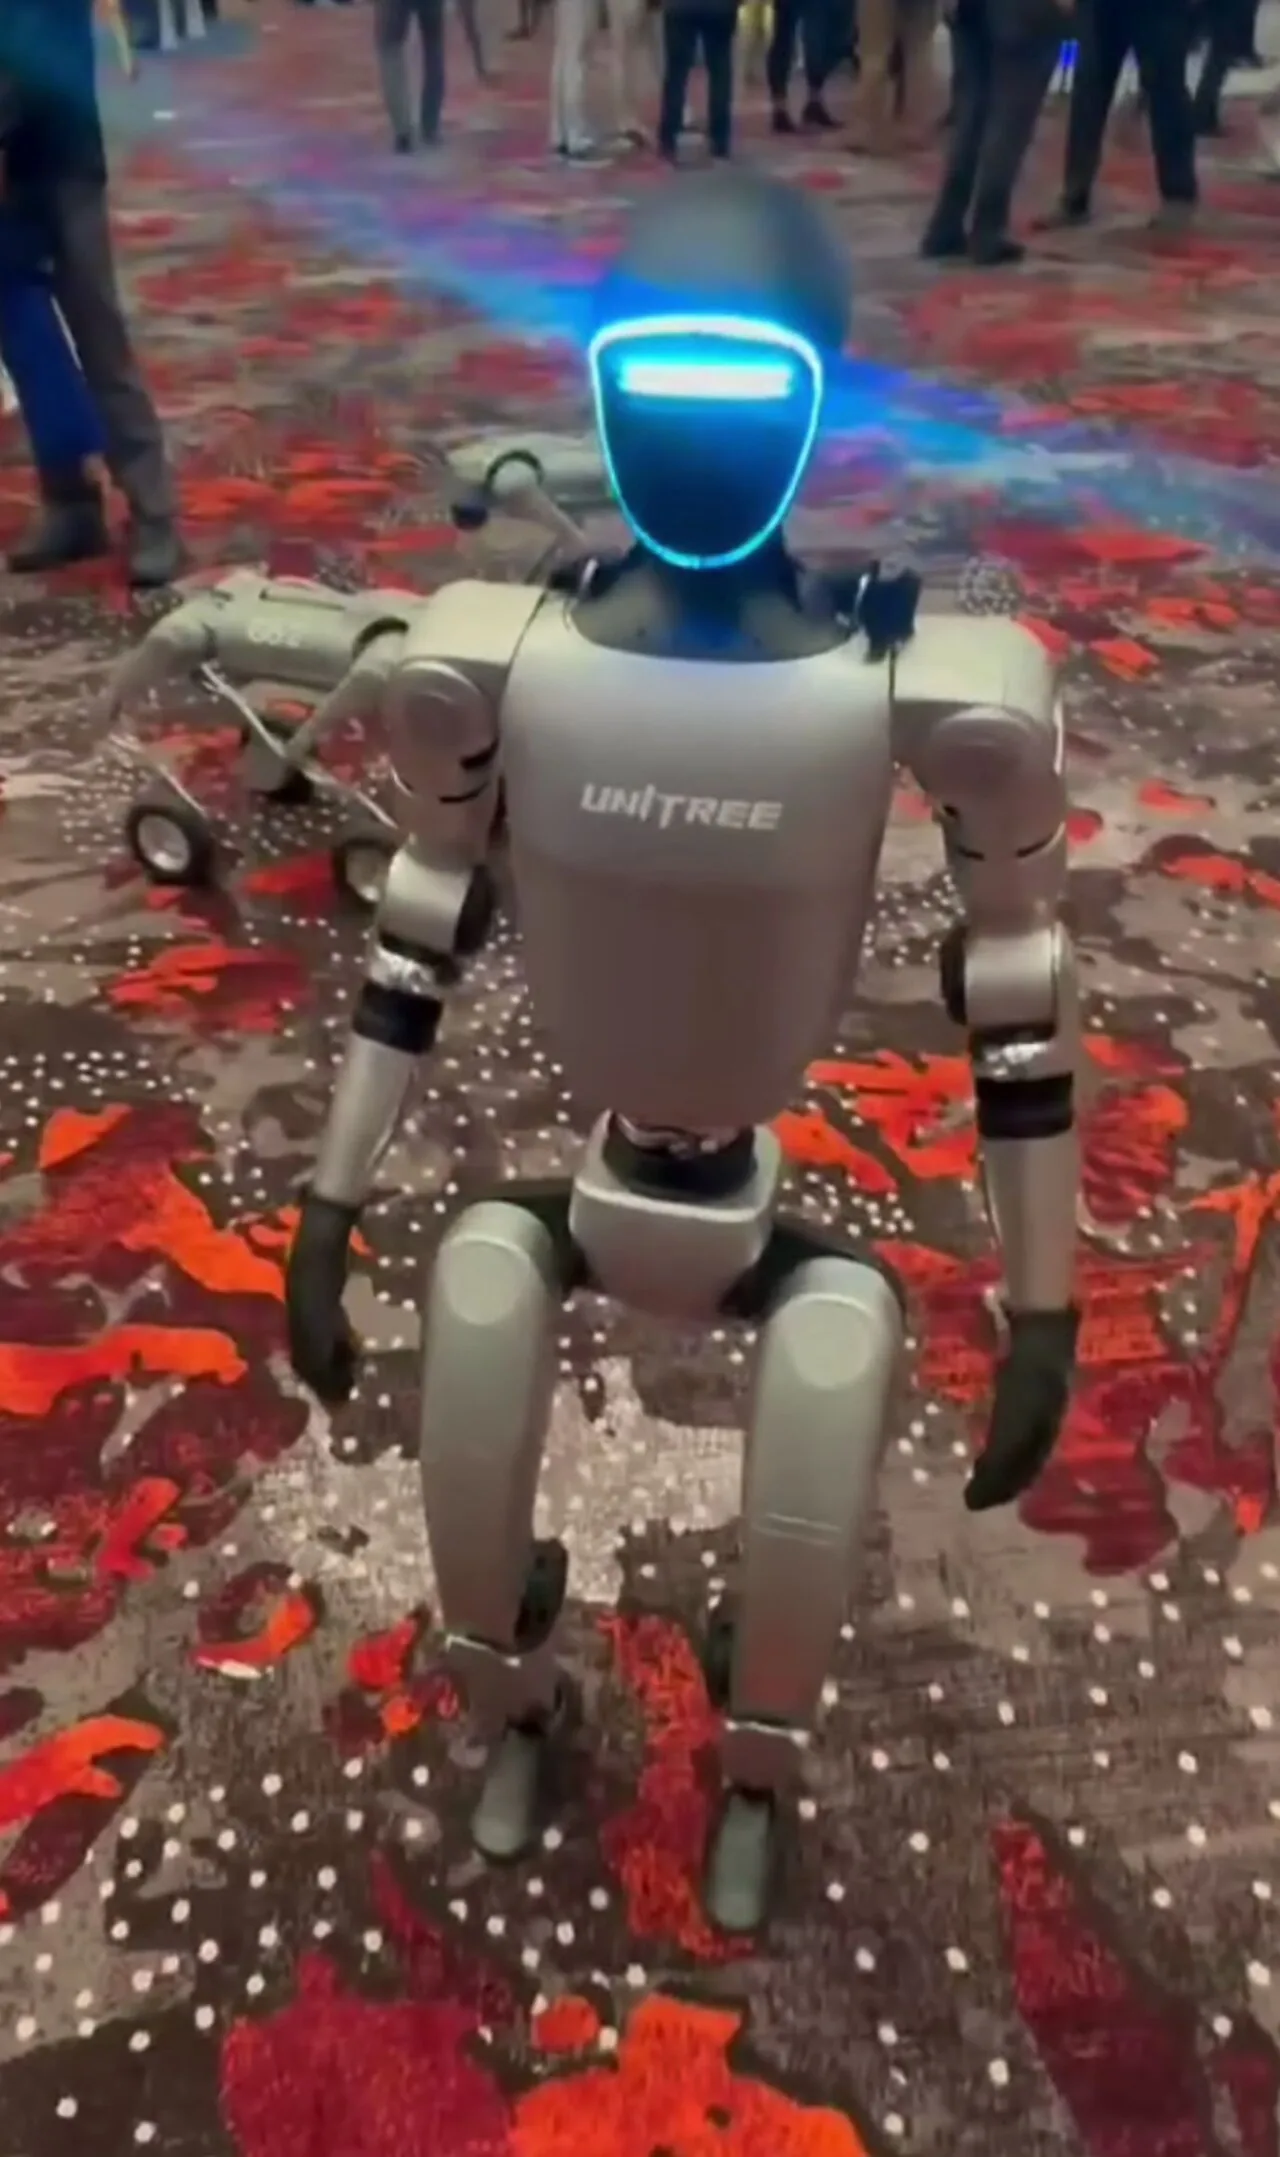
写真: Wikimedia Commons
人型ロボットの開発は、アメリカのBoston DynamicsやTeslaをはじめ、世界中で進んでいます。
Digitが倉庫で運んだ箱(会社の発表)
Digit が倉庫で運んだ箱(会社の発表)
出典: Agility Robotics(2025年11月)※会社の発表
アメリカの物流倉庫では、人型ロボットがすでに働き始めています。Agility Roboticsの人型ロボット「Digit」は、倉庫で箱(トート)を10万個以上運んだと発表されました。[s13]
体を持つAIの注意点
間違えたときの影響
間違えたときの影響
チャットAI
- 文章を直せばいい
- やり直しがきく
フィジカルAI
- 物が壊れる・けがをする
- 取り返しがつかないことも
体を持つAIには、特有の注意点があります。チャットAIの間違いなら、文章を直せば済みます。しかしロボットの間違いは、物を壊したり、人にぶつかったりすることにつながります。
99%の落とし穴(計算のイメージ)
99%の落とし穴(計算のイメージ)
0.99を100回かけると約0.366(それぞれの動きが独立と仮定)
たとえば、1回の動きが99%成功するロボットで、洗濯物を片付けるのに100回の動きが必要だとします。最後まで失敗せずに終えられる確率は、0.99を100回かけて約37%しかありません(それぞれの動きが独立と仮定した計算のイメージ)。10回やれば、6回ほどは途中で失敗する計算です。だからこそ、失敗に気づいてやり直す力がとても大事になります。
AIとは別に、見張り役を置く
AIとは別に、見張り役を置く
もう1つ大事なのが、AIの判断をそのまま信じないことです。AIとは別の仕組みが、速さや力、人が近くにいないかを見張り、問題がなければモーターに動きを送ります。
安全のルールと仕組みも整いつつある
安全のルールと仕組みも整いつつある
NVIDIA Halos
2026年6月:ロボット全体の安全の仕組み
ISO 10218
2025年2月:産業用ロボットの安全規格を改訂
出典: NVIDIA(2026年6月)、ISO(2025年2月)
2026年6月には、NVIDIAがロボット全体の安全を守る仕組み「Halos for Robotics」を発表しました。[s8]産業用ロボットの安全規格ISO 10218も、2025年2月に、2011年版以来の大きな改訂が行われています。[s17]
ロボット動画の見方
ロボット動画の見方
自律?遠隔?
人が遠くから操作していないか
何倍速?
早送りしていないか
何回目?
うまくいった1回だけではないか
ロボットの動画を見るときは、3つのポイントを確かめましょう。1つ目は、AIが自分で動いているのか、人が遠くから操作しているのか。2つ目は、早送りしていないか。実際はゆっくりなことも多いです。3つ目は、何回やって何回成功したのか。うまくいった1回だけを見せている可能性もあります。信頼できる発表には、「自律」「等速」「成功率」などが書いてあることが多いです。
チェックのコツ
ロボットはいつ家に来るのか
広まっていく順番(予想)
広まっていく順番(予想)
ロボットが広まる順番には傾向があります。まずは、場所も物も決まっていて、人と作業場所を分けやすい工場や倉庫。次にお店や街、そして最後が家庭です。家の中は散らかっていて、子どもやペットもいて、毎日様子が変わるためです。
家庭用の人型ロボット「NEO」
NEO
1X(アメリカ)の家庭用人型ロボット
出典: 1X の発表(2025年10月)
とはいえ、家庭用の人型ロボットの予約販売も始まっています。アメリカの1Xの「NEO」は、値段が2万ドル(月499ドルのプランもあり)で、アメリカで2026年から届ける予定です。できない家事は、会社の人が遠隔操作で手伝うとしています。[s14]
考えておきたいこと
便利な一方で、遠隔操作のときは家の中の映像を人が見ることになります。便利さとプライバシーのバランスは、よく考えておきたい点です。
まとめ
この記事のまとめ
- フィジカルAIは、現実の世界で「見て・考えて・動く」AI
- 家事が難しいのは、やわらかい物・力かげん・データ不足
- 99%でも失敗は重なる。見張り役と、動画の見方が大事
フィジカルAIは、現実の世界で「見て・考えて・動く」AIです。家事が難しいのは、やわらかい物、力かげん、そしてお手本のデータ不足のためで、VLAや大量のデータ、仮想世界での練習によって、研究は急速に進んでいます。
ただし、1回の成功率が高くても、動きを重ねると失敗は積み重なります。AIとは別の見張り役の仕組みと、ロボットの動画を「自律か・等速か・何回中何回成功か」で確かめる見方が大切です。
実践のポイント・まとめ
賢いAIが洗濯物をたためない理由
布は置くたびに形が変わり、力かげんも難しいうえに、お手本になる動きのデータがネットにはありません。そのため、人がロボットを遠隔操作して、お手本を集めています。
成功率99%のロボットは本当に安心?
1回99%でも、100回続けて成功する確率は約37%です(計算のイメージ)。失敗に気づいてやり直す力と、AIとは別に速さや力を見張る仕組みが大事です。
そのロボット動画、本当に「自律」?
人が遠くから操作していないか、早送りしていないか、何回中何回成功したかを確かめましょう。人が手伝うこと自体は悪くありません。大事なのは、どこまでをAIがしているかを知ることです。
出典・参考文献
- [s1] Google DeepMind「RT-2: New model translates vision and language into action」 ↗ deepmind.google
- [s2] Black ほか「π0: A Vision-Language-Action Flow Model for General Robot Control」 ↗ arxiv.org
- [s3] Physical Intelligence「π0.5: a Vision-Language-Action Model with Open-World Generalization」 ↗ pi.website
- [s4] Physical Intelligence「π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities」 ↗ arxiv.org
- [s5] The Robot Report「Google DeepMind says Gemini Robotics 2 enables full body control」 ↗ therobotreport.com
- [s6] NVIDIA「Isaac GR00T N1 — the World's First Open Humanoid Robot Foundation Model」 ↗ investor.nvidia.com
- [s7] NVIDIA「NVIDIA Launches Cosmos World Foundation Model Platform」 ↗ nvidianews.nvidia.com
- [s8] NVIDIA「NVIDIA Announces Halos for Robotics」 ↗ nvidianews.nvidia.com
- [s9] Open X-Embodiment Collaboration「Open X-Embodiment: Robotic Learning Datasets and RT-X Models」 ↗ arxiv.org
- [s10] Khazatsky ほか「DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset」 ↗ arxiv.org
- [s11] Generalist「GEN-0: Embodied Foundation Models That Scale with Physical Interaction」 ↗ generalistai.com
- [s12] Zhao ほか「Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ALOHA / ACT)」 ↗ tonyzhaozh.github.io
- [s13] Agility Robotics「Digit Moves Over 100,000 Totes in Commercial Deployment」 ↗ agilityrobotics.com
- [s14] The Robot Report「1X opens pre-orders for NEO humanoid」 ↗ therobotreport.com
- [s15] IFR「Japan's Car Industry has Highest Robot Installations in Five Years」 ↗ ifr.org
- [s16] IFR「Five Million Robots now Operate in Factories Globally」(World Robotics 2026、2026-09-24) ↗ ifr.org
- [s17] ISO「ISO 10218-1:2025 Robotics — Safety requirements」 ↗ iso.org
- [s18] Moravec「Mind Children」(1988)/ Wikipedia「Moravec's paradox」 ↗ en.wikipedia.org
検証ファクト一覧を表示する(全23項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | フィジカルAI:現実の世界でセンサーで知覚し、判断し、体(アクチュエータ)で行動し、その結果をまた観測するループで動くAI。NVIDIA は「現実世界で感じ、判断し、行動する機械」と説明 | [s8] | 人型ロボットだけではない(アーム・自動運転・配送ロボ・AMR も含む)。どこまでを「AI」と呼ぶかは幅がある |
| F2 | モラベックのパラドックス(1988):知能テストやチェッカーで大人並みの性能を出すのは比較的簡単だが、1歳児の知覚や移動の能力を持たせるのは難しいか不可能 | [s18] | |
| F3 | Google DeepMind:ロボットが同じレベルの能力を持つには、あらゆる物・環境・作業・状況について、ロボットのデータを自分で集める必要がある(だから難しい) | [s1] | |
| F4 | RT-2(2023-07-28):ウェブの画像と文章で学んだモデルを、ロボットの動きも出力する VLA(視覚・言語・行動)にした。動きは文字列(トークン)として出す | [s1] | |
| F5 | RT-2 の例:ライオン・クジラ・恐竜のおもちゃを前に「絶滅した動物を拾って」→ 恐竜を拾った | [s1] | |
| F6 | RT-2:初めて見る場面での成功率が RT-1 の 32% から 62% に(6,000回以上の試行) | [s1] | |
| F7 | ALOHA / ACT(2023):約2万ドル以下の双腕の遠隔操作装置。約10分ぶんのお手本で、電池のはめ込みなど6つの細かい作業を 80〜90% の成功率で学んだ | [s12] | |
| F8 | Open X-Embodiment(2023-10):21機関が22種類のロボットのデータを持ち寄った(527スキル・16万タスク)。まとめて学んだ RT-X は機種をまたいで性能が上がった | [s9] | |
| F9 | DROID(2024-03):50人が12か月、3大陸で集めた 7.6万回・350時間・564の場面の実ロボットデータ(公開) | [s10] | |
| F10 | π0(2024-10-31):7種類のロボット・68の作業、約1万時間のお手本で事前学習。洗濯物たたみ(乾燥機から出してたたむ)・テーブル片付け・箱の組み立て。最大 50Hz で動きを出す。3.3B パラメータ | [s2] | |
| F11 | GEN-0(2025-11-04、Generalist):27万時間以上の実世界の操作データで事前学習。データは週1万時間のペースで増加 | [s11] | 会社の発表。27万時間=1台で約31年分。集め方・質は会社ごとに違う |
| F12 | π0.5(2025-04):学習データにない家(サンフランシスコの賃貸住宅3軒)で、台所や寝室を片付け。10〜15分かかる長い作業 | [s3] | |
| F13 | π0.7(2026-04-16):詳しい言葉の指示・途中の目標画像・メタデータで「操縦できる」汎用モデル。その作業を見たことのないロボットで洗濯物をたたむ(機種をまたぐゼロショット)、エスプレッソマシンの操作など | [s4] | Physical Intelligence の論文(社内評価) |
| F14 | GR00T N1(2025-03-18、NVIDIA):人型ロボット向けのオープンな基盤モデル。「System 2」(ゆっくり考える VLM)と「System 1」(すばやく動きを出す)の2系統 | [s6] | |
| F15 | Gemini Robotics 2(2026-07-30、Google DeepMind):VLA・Gemini Robotics ER 2(考える役)・On-Device 2(ロボット本体で動く)の3つ。人型ロボット(Apptronik Apollo 2)が歩く・かがむ・物をつかむを全身で協調し、散らかった部屋を片付ける。数分・数百の判断が続く作業。複数ロボットの協力も | [s5] | |
| F16 | Cosmos(2025-01、NVIDIA):物理世界の動画を生成する「世界モデル」の基盤。ロボットや自動運転の学習用に、物理的にありえそうな合成データを大量に作る | [s7] | |
| F17 | Agility Robotics の人型ロボット Digit:米国の物流会社 GXO の倉庫で、運搬ロボからコンベヤーへ箱(トート)を移す作業。累計10万個以上(2025-11 発表) | [s13] | 会社の発表 |
| F18 | 1X の家庭用人型ロボット NEO:2万ドル(または月499ドル)。2025年10月に予約開始、米国で2026年から届ける計画。できない家事は、1X の人が遠隔操作で手伝う「エキスパートモード」 | [s14] | |
| F19 | 日本は世界のロボット生産の38%を占める(IFR 会長の発言、2025-07-15) | [s15] | |
| F20 | 世界の工場で動く産業用ロボットは約500万台(2025年、IFR World Robotics 2026) | [s16] | |
| F21 | Halos for Robotics(2026-06-22、NVIDIA):ロボット向けの「全体の安全の仕組み」。外部カメラなどで AI とは別に見張る「Outside-In」の設計図も。Agility が最初に採用 | [s8] | |
| F22 | 産業用ロボットの安全規格 ISO 10218-1/-2 が 2025年2月に改訂(2011年版以来)。協働ロボットの要求(旧 ISO/TS 15066)やサイバーセキュリティも含む | [s17] | |
| F23 | 1回99%成功する動きを100回続けて全部成功する確率は 0.99^100 ≈ 36.6%(計算) | — |
※ RT-2 の成功率、Digit が運んだ箱の数、GEN-0 のデータ量、π0.7 の成果などは、各社の発表・論文(自社の評価)にもとづきます。独立した検証ではありません。
※ チャットAIとのやり取り、「99%を100回続けると37%」の計算(各回が独立と仮定)、ロボットが広まる順番は、説明のためのイメージです。
※ Digit・研究用ロボット・NEO などのイラストはイメージで、実物とは異なります。実物の写真は Wikimedia Commons の自由に使えるライセンスのものを使っています(撮影者とライセンスは下のクレジット)。