社外秘のレシピや顧客名簿をAIで整理したい一方で、外部のサーバーには送りたくない。そんなときの選択肢が、AIを自分のパソコンで動かす「ローカルLLM」です。中国のZ.aiが2026年8月に発表した「GLM-5.3」は重みが無料で公開されており、ダウンロードして手元で動かせます。
ただし、GLM-5.3の重みは約756GBあり、一般的なノートPCのメモリ(16GB前後)には到底収まりません。本記事では、ローカルLLMの仕組みと利点・負担、GLM-5.3の実力、なぜこれほど大きいのか、量子化で小さくするとどうなるか、マシンの値段とAPIの料金の比較、目的別の選び方と注意点を順に解説します。
情報は2026年10月11日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- ローカルLLMは、AIを手元のPCやサーバーで動かす方式で、入力を外部に送らずに済む。
- GLM-5.3の重みは約756GB。MoEで1回の計算は軽くても、メモリには全体を置く必要がある。
- 量子化で小さくできるが、元のモデルとは答えが少しずつ変わる。
- 手元では小さいモデルを使い、GLM-5.3の力が必要ならまずAPIで試すのが現実的。
基礎知識:ローカルLLM・パラメータ・量子化の仕組み
「GLM-5.3」は、中国のAI企業Z.ai(旧Zhipu AI)が公開した、プログラミングとAIエージェントの仕事が得意な大規模言語モデル(LLM)です。全体のパラメータは約7,500億、1語を出すときに計算に使うのは約400億というMoE(Mixture of Experts)の構造で、重みが公開されているため、自社のサーバーや手元の環境にダウンロードして使えます。
LLMの本体は「パラメータ(重み)」と呼ばれる大量の数値です。AIは1語を出すたびにこの重みをメモリから読み出すため、SSDなどのストレージに空きがあっても、メモリに収まらなければ実用的な速さでは動きません。
約7,500億個のパラメータを1個あたり1バイト(8ビット)で持つと、約756GBになります。これを小さくする方法が「量子化」で、数値を4ビット・2ビット・1ビットと粗く丸めるほどメモリは減ります。ただし、丸めるほど元のモデルとは違う答えを出しやすくなり、難しい推論やコーディングで差が出るおそれがあります。
AIを自分のパソコンで動かすという選択肢
ふだんのチャットAIは入力を外部に送る
ふだんのチャットAI
ふだん使うチャットAIでは、入力した内容が提供する会社のサーバーに送られ、そこで答えが作られます。[s2]社外秘のレシピや顧客名簿を扱うとき、これをためらう人は少なくありません。そこで候補になるのが、AIを自分のパソコンで動かす「ローカルLLM」です。[s2]
注目を集めているのが、中国のZ.aiが8月に発表したGLM-5.3です。[s1]重みが公開されているので誰でもダウンロードできますが、その大きさは約756GBあります。メモリ16GBのノートPCと比べると約47倍で、そのままでは到底入りません。[s2]
ローカルLLMとは何か
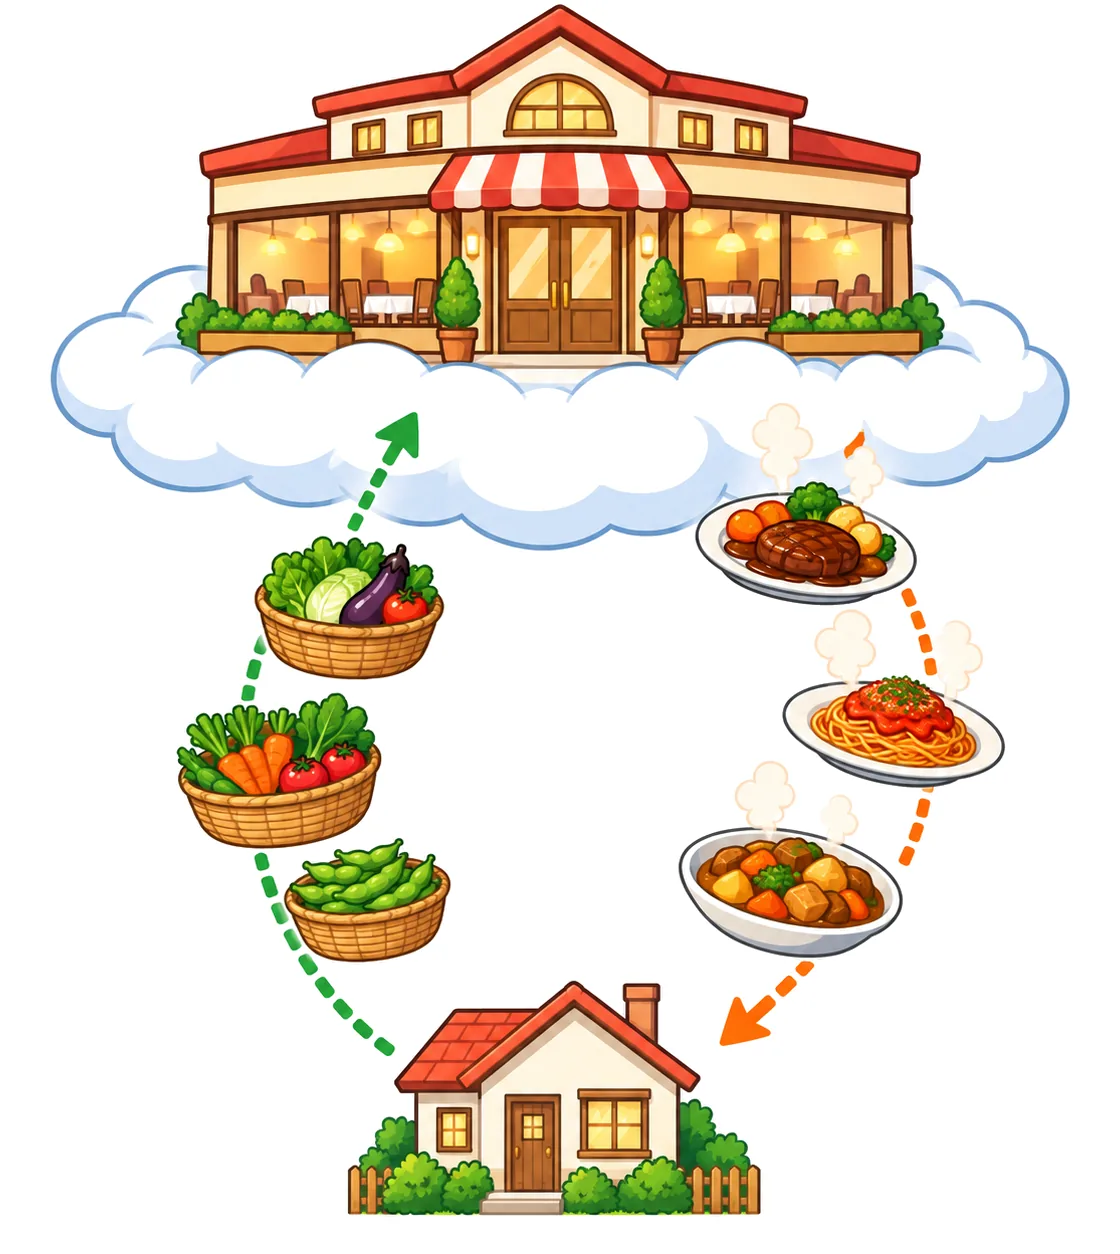
クラウドのAI
- 会社のサーバーで動く
- 入力を送って答えをもらう
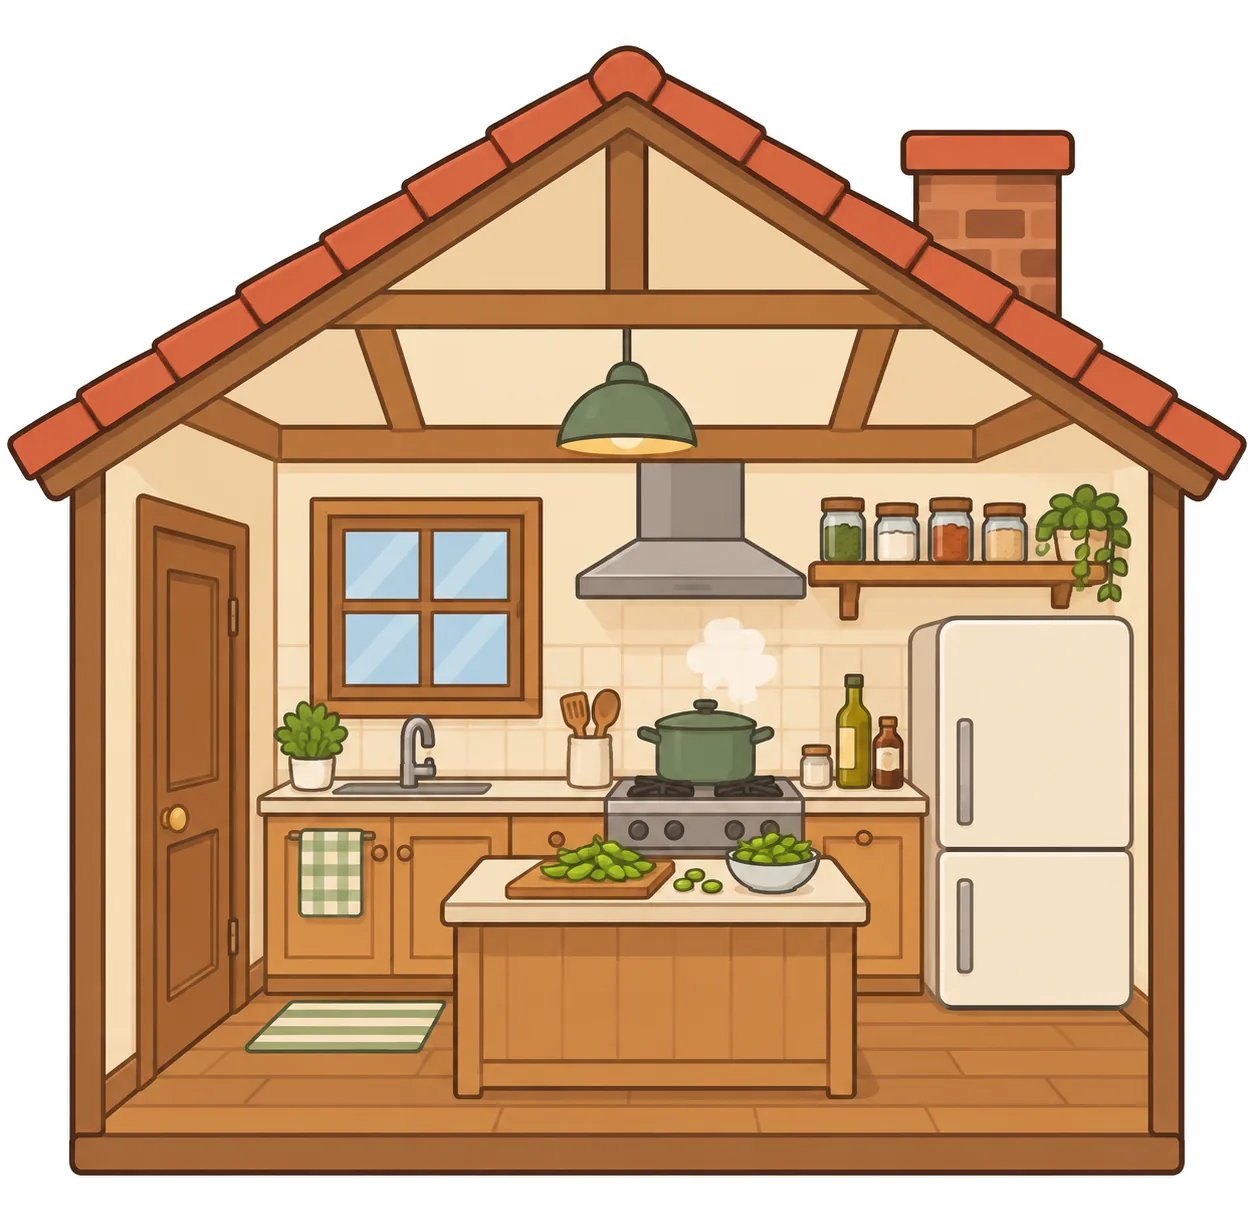
ローカルLLM
- 自分のPCで動く
- 入力は手元で処理
ふだん使っているチャットAIは、クラウドのAIです。[s2]料理にたとえると、材料をレストランに届けて料理を作ってもらう形です。ローカルLLMは自分の家の台所で作る形で、材料は家から出ません。その代わり、台所と道具は自分でそろえる必要があります。
ローカルLLMの利点
ローカルLLMのうれしいこと
外に出ない
入力を手元で処理する
使い放題
使った分の料金がない
ネットなし
つながらなくても動く
自由に選ぶ
モデルや設定を替えられる
利点は主に4つあります。入力を手元で処理するので外に出ないこと、使った分の料金がかからないこと、ネットにつながらなくても動くこと、そしてモデルを自由に選べることです。[s2]
自分で負担するもの
かかるもの
マシン
大きいAIほど高い
電気代
動かすたびにかかる
手間
更新や設定は自分で
賢さ
小さいと苦手なことも
一方で、マシン・電気代・設定や更新の手間は自分で負担することになり、小さいモデルでは苦手な仕事も出てきます。とくに、大きいAIほどマシンが高くなる点が、本記事の中心となる問題です。
また、AIを手元で動かしていても、Web検索や外部の道具、クラウド版のモデルを使えば通信は発生します。[s11]「ローカルだから何も外に出ない」とは限りません。
GLM-5.3の実力
GLM-5.3
GLM-5.3は、プログラミングとAIエージェントの仕事が得意なモデルです。[s1][s2][s5]前のGLM-5.2と同じ土台に、追加の学習を重ねて性能を上げました。[s1]重みは、安全性の確認のため、発表から2週間後に公開されています。[s1][s2]
Z.aiが発表したソフト開発のテスト
DeepSWE(ソフト開発の課題)Z.aiの発表
Z.ai の発表(2026年8月、自社の評価)。比べた相手は8月時点のモデル
Z.aiの発表では、ソフト開発の課題を解くテスト(DeepSWE)で、前の版の46.2点から66.9点へ大きく伸びました。同じ表には、AnthropicのClaudeやOpenAIのGPTも並んでいます。[s2]ただし、これは会社自身の発表で、比べた相手は8月時点のモデルです。[s2]
第三者の指数で見ると
第三者の指数(Artificial Analysis)
Artificial Analysis Intelligence Index(10種のテストのまとめ)。2026年10月11日閲覧
第三者の評価機関Artificial Analysisの指数では、最新の非公開のAIとはまだ差があるものの、重みを公開しているモデルの中では上位に入っています。[s19]
軽量版のGLM-5.3-Flash
GLM-5.3 と GLM-5.3-Flash
| 項目 | GLM-5.3 | Flash |
|---|---|---|
| 全体の大きさ | 約7,500億 | 約3,200億 |
| 1回に使う | 約400億 | 約180億 |
| 読めるもの | 文字 | 文字・画像 |
| APIの値段 | 基準 | 約10分の1 |
| ライセンス | 独自 | MIT |
Z.ai の発表・モデルカード。大きさはパラメータの数
8月26日には、軽くて安い「GLM-5.3-Flash」も発表されました。全体のパラメータは約3,200億、1回に使うのは約180億で、画像も読めます。[s3][s4][s5][s6]
なぜ756GBもあるのか
Hugging Face の数え方で約7,533億
LLMの中身は、パラメータ(重み)と呼ばれる大量の数値です。学習を通じてこれらの値を調整し、うまく答えられるようにしています。GLM-5.3のパラメータは約7,500億個あります。[s2]
重さの計算
重さの計算(1個=8ビット=1バイト)
パラメータ1個を1バイト(8ビット)で持つと、7,500億バイト、つまり約756GBになります。[s2]AIを動かしている間は、この重みをすべてメモリに置いておく必要があります。
なぜストレージではなく、メモリに置く必要がある?
パソコンの中のたとえ
ストレージ
倉庫。しまっておく
メモリ
作業台。いま使う物を広げる
ストレージを倉庫、メモリを作業台にたとえると分かりやすくなります。AIは答えを書く間に何度も重みを読み直すため、倉庫から毎回取り出していては遅すぎます。いま使う物は作業台に広げておく必要があるのです。
1回に使うのは約400億なら、もっと小さくて済むのでは?
MoEの仕組み
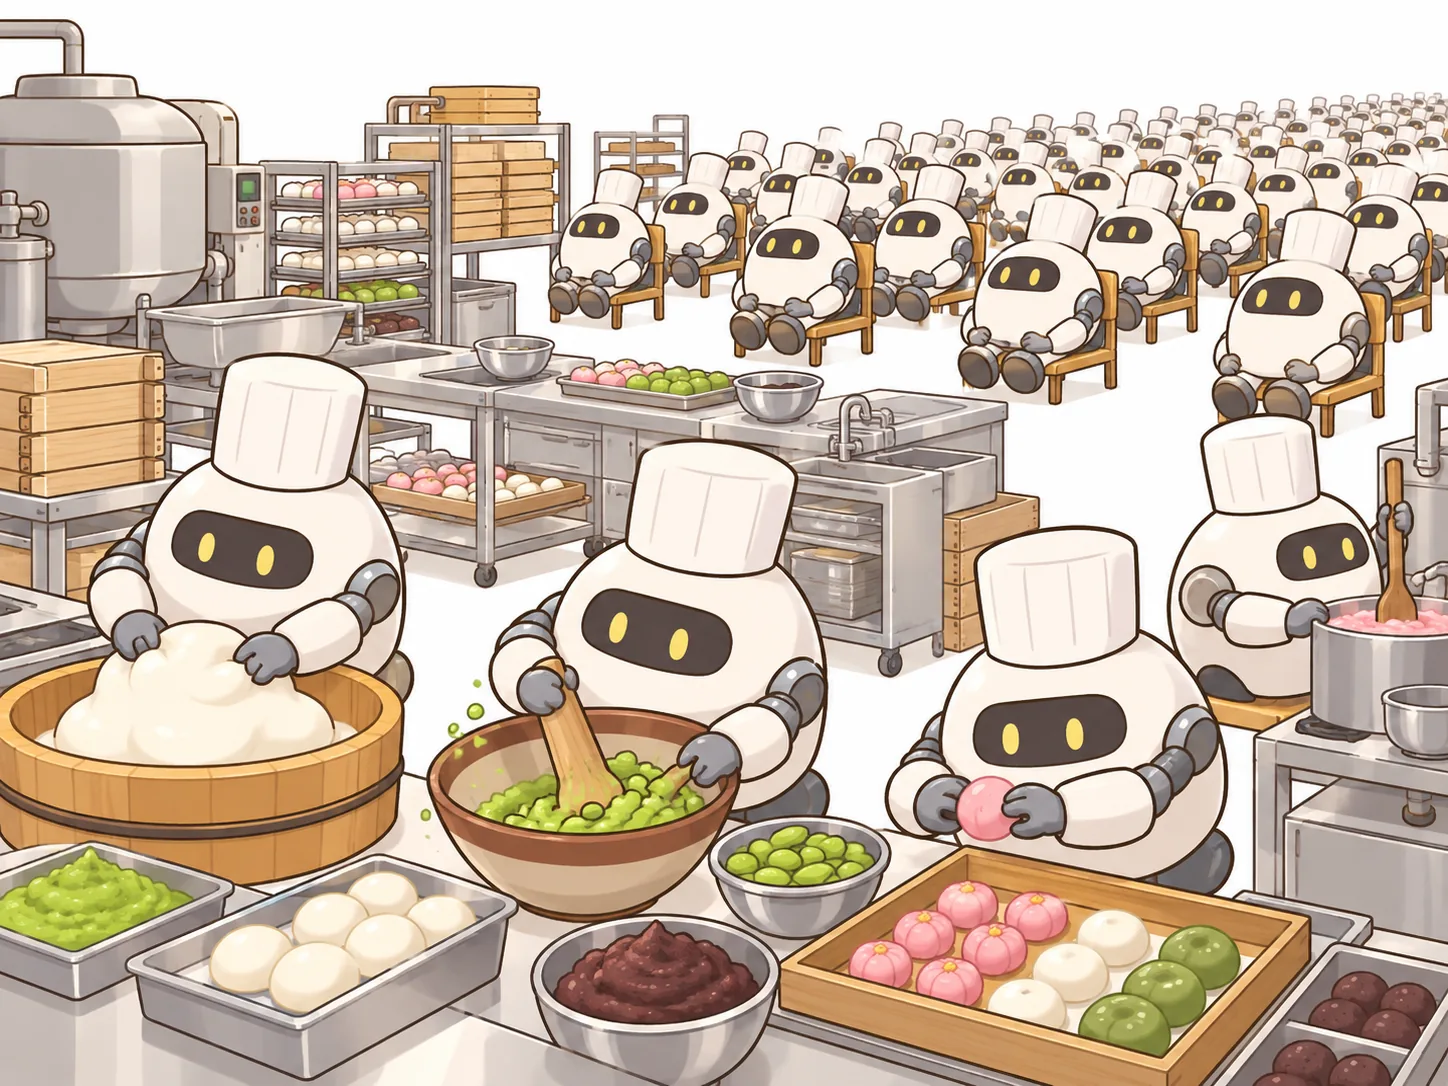
ここがよくある誤解です。GLM-5.3はMoEという仕組みを使っています。[s6]厨房に職人が256人いて、注文が来るたびに、合う職人8人といつもの1人だけを呼んで料理を作る、と考えると分かりやすいでしょう。[s2]1回の計算に使うのが約400億なのはこのためです。[s6]
MoE で軽くなるもの・ならないもの
計算
1回に約400億だけ
メモリ
全員ぶん約7,500億
しかし、次の注文で誰が呼ばれるかは分からないので、職人は全員お店にいなければなりません。[s2][s6]つまりMoEは計算を速くする工夫であって、必要なメモリを減らす工夫ではありません。
量子化で小さくする
メモリを減らす方法としては、数値を粗く丸める「量子化」があります。[s7]細かい目盛りの定規を、粗い目盛りの定規に替えるようなもので、8ビットを4ビットにすればおおよそ半分になり、さらに丸めればもっと小さくなります。[s7]
GLM-5.3のファイルの大きさ
GLM-5.3 のファイルの大きさ
Hugging Face の公開ファイルの合計(4ビット以下は Unsloth の量子化版)
GLM-5.3の場合、8ビットの元の重みが756GBなのに対し、4ビット版は365〜467GB、2ビット版は239〜254GB、1ビット版は217〜229GBです。[s2][s9]
丸めると、答えが少しずつ変わる
元のモデルと同じ言葉を選ぶ割合
Unsloth の測定(GLM-5.3 の量子化版)
ただし、丸めるほど中身は少しずつ変わります。この図は、元のモデルが次にいちばん選ぶ言葉と、量子化したモデルが同じ言葉を選ぶ割合を示したもので、4ビットでは94.3%、1ビットでは72.6%でした。[s7]1ビット版では、4回に1回ほど違う言葉を選ぶ計算になり、難しい仕事ほど差が出るおそれがあります。[s7]
メモリには重み以外も必要
256GB のマシンに、2ビット版を入れると
重みとKVキャッシュ(文脈メモリ)は Unsloth の目安(合計245GB)。OS・アプリはイメージ
さらに、メモリにはファイルのほかにも必要なものがあります。AIが読んだ文章を覚えておくKVキャッシュは、長い文章ほど大きくなり、パソコン自身が使う分も要ります。[s7][s9]そのため、2ビット版でも256GBのマシンでぎりぎりです。[s7]
「100万トークン読める」というのはモデルの仕様であり、実際に100万トークンを読ませれば、その分のKVキャッシュがさらにメモリを使います。[s5][s7]
何GBあれば動くのか —— マシンと値段
メモリの大きさで並べたマシン
マシンのメモリ(GPU・統合メモリ)
2026年10月11日。Apple は税込の定価、RTX 5090・DGX Spark は価格.com の最安
マシンをメモリの大きさで並べると、次のようになります。一般的なパソコンは16GB前後で、Mac miniは14万9,800円からです。[s15]ゲーム用の高性能GPUであるRTX 5090でもメモリは32GBで、GPU単体で100万円を超えます。[s17][s20]AI開発用の小型機DGX Sparkは128GBです。[s16][s20]
Mac Studioは256GBの構成で190万3,800円、512GBの構成は10月下旬の発売予定です。[s14]その上には、データセンター用のGPU(H200)を8枚つないだ、合計1,128GBのサーバーがあります。[s18]
GLM-5.3(元の重み)はどこに入る?
重みだけの比較。実際はKVキャッシュ(文脈メモリ)などのぶんも要る
重みだけで比べても、GLM-5.3を元の重みのまま動かせるのは、このうちいちばん大きなサーバーだけです。[s2][s18]実際には会話を覚えておくメモリなども必要なので、余裕はさらに小さくなります。
何が動くか(重さから見た目安)
何が動く?(重さから見た目安)
| 項目 | 小さいAI | Flash | GLM-5.3 |
|---|---|---|---|
| 16GB | ○ | × | × |
| 32GB | ○ | × | × |
| 128GB | ○ | 1〜2ビット | × |
| 256GB | ○ | 4ビット | 1〜2ビット |
| 512GB | ○ | 8ビット | 4ビット |
| 1,128GB | ○ | 元のまま | 元のまま |
小さいAI=90億〜200億パラメータ級。Unsloth の必要メモリの目安から。速さは測っていない
マシンごとに何が動くかを、重さと必要なメモリから整理したのがこの表です。○は入ることを、ビット数はそこまで丸めれば入ることを示す目安です。[s7][s8][s12]なお、入ることと速く答えられることは別の問題で、本記事では速さは測っていません。[s7]
GPUを借りるという方法
GPU(H200)8枚を借りると(Runpod)
Runpod の料金ページ(2026年10月11日)。1枚 $4.31〜$5.29/時 × 8
GPUは借りることもでき、データセンター向けのH200を8枚借りると1時間あたり約5,500〜6,700円です。[s21][s22]ただし、借りたGPUにはデータを送ることになるため、厳密には「自分の手元」ではありません。[s21]
APIで使うといくらかかるか
APIの料金(100万トークンあたり)
| 項目 | GLM-5.3 | Flash |
|---|---|---|
| 入力 | 1.40ドル | 0.15ドル |
| 出力 | 4.40ドル | 0.50ドル |
Z.ai の料金表(2026年10月11日)。キャッシュの割引は別
もう1つの方法が、Z.aiのAPIを使い、クラウドで使った分だけ料金を払う方法です。[s5]料金は100万トークンあたりで決まっています。トークンはAIが文章を数える単位です。
1か月の料金の試算
APIの料金の試算(1か月)
入力1,000万・出力200万トークン。1ドル≒158円。キャッシュの割引・税は除く
例として、1か月に1,000万トークンを読ませ、200万トークンを書かせる使い方を試算すると、Flashなら月に約400円、GLM-5.3でも約3,600円です。[s5][s22]
256GBのMac Studio(約190万円)の代金は、GLM-5.3のAPIの試算で約44年分にあたります。ただし、APIでは入力が会社のサーバーに送られます。[s5]秘密のデータを送ってよいかどうかは、値段とは別に判断が必要です。
「:cloud」の落とし穴
ollama run glm-5.3:cloudローカルのつもりで外部に送ってしまう落とし穴もあります。Ollamaというアプリには、名前の最後に「:cloud」が付いたモデルがあり、これはダウンロードされずに米国と欧州のサーバーで動きます。[s10][s11]
目的別の選び方
何をしたい?
目的ごとに選び方を整理します。まず試したいなら、いまのパソコンで小さいモデルから始めましょう。[s10]OpenAIのgpt-oss 20Bは、16GBのメモリで動くように作られています。[s12]秘密のデータを扱うなら、32GB前後のマシンで、もう少し大きいモデルが候補になります。[s10][s13]
GLM-5.3の力が必要なら、外に送ってよいデータで、まずAPIから試すのが近道です。会社としてすべてを手元に置くならGPUサーバーという選択肢もありますが、費用に加えて管理する人も必要です。[s5]
組み合わせて使う
自社ショップの使い分け(イメージ)
手元のAI
レシピ・名簿の整理
API
秘密でない、むずかしい仕事
両方を組み合わせる方法もあります。たとえば、レシピや名簿の整理は手元の小さいAIで行い、秘密ではない難しい仕事だけをAPIに任せる、という使い分けです。
使う前の注意
ライセンスはモデルごとに違う
ライセンスのちがい
GLM-5.3
独自。巨大なAI事業は審査
Flash
MIT
gpt-oss
Apache 2.0(Qwenも)
1つ目はライセンスです。重みが公開されていても、使い方の条件はモデルごとに違います。[s2][s4][s12][s13]GLM-5.3の独自ライセンスは使用や商用利用を広く認めていますが、AIを貸し出す事業を行う非常に大きな会社には、Z.aiの審査を求めています。[s2]仕事で使う前には、必ず本文を読みましょう。
2つ目は外への通信です。手元で動かしていても、検索や外部の道具、クラウド版を使えばデータは外に出ます。[s10][s11]3つ目は賢さと手間です。小さいモデルや強く丸めた版は難しい仕事が苦手になりやすく、モデルの更新や管理も自分の仕事になります。[s7]
今日からできること
# 16GB前後のパソコン
ollama run qwen3.5:9b
ollama run gpt-oss:20b
# 32GB前後のパソコン
ollama run qwen3.6:35b-a3b
まずは自分のパソコンのメモリが何GBかを確かめ、OllamaやLM Studioで小さいモデルを動かしてみましょう。[s10]Ollamaなら、インストール後に1行のコマンドを打つだけで、ダウンロードしたモデルが手元で動きます。小さいモデルほど軽く、速く動きます。[s10]
検索や外部の道具をつなぐときは、データがどこに送られるかを確かめ、仕事で使う場合はライセンスを読んでおくことも忘れないようにしましょう。
まとめ
ローカルLLMは、AIを手元で動かすことで、入力を外部に出さずに済む方法です。GLM-5.3の重みは約756GBあり、MoEで1回の計算は軽くても、メモリには全体を置く必要があります。[s2]量子化で小さくすることはできますが、元のモデルとは答えが少しずつ変わります。[s7]
家庭や小さなお店では小さいモデルを手元で使い、GLM-5.3の力が必要な仕事は、まず送ってよいデータでAPIから試す。この組み合わせが、費用と安心のバランスがとれた始め方です。
実践のポイント・まとめ
AIに秘密を送りたくないときは
AIを手元のパソコンで動かすローカルLLMなら、入力を外部に送らずに済みます。メモリが16GBあれば小さいモデルは動きますが、大きいAIほど大きなメモリが必要です。
ローカルLLMとは何か
AIのモデルを自分のパソコンや社内のサーバーに置いて動かす方式です。入力が外に出ない一方で、大きいAIほど大きなメモリが要り、パソコンや電気代も自分で用意します。
手元のAIなら情報は漏れない?
Web検索や外部の道具を使えば、手元のAIでも通信は起きます。Ollamaでは名前の最後に「:cloud」が付いたモデルはクラウドで動くため、大事なデータがどこに送られるかを確かめましょう。
ローカルLLMは何GBで動く?
メモリ16GBなら90億〜200億パラメータ級の小さいモデルが目安です。Ollamaというアプリなら1行のコマンドで始められ、ダウンロードしたあとはネットなしでも動きます。
出典・参考文献
- [s1] Z.ai「GLM-5.3: Frontier Coding with Emergent Cyber Capabilities」 ↗ z.ai
- [s2] Z.ai「GLM-5.3」モデルカード・ライセンス(Hugging Face) ↗ huggingface.co
- [s3] Z.ai「GLM-5.3-Flash: Frontier Intelligence, Flash Cost」 ↗ z.ai
- [s4] Z.ai「GLM-5.3-Flash」モデルカード(Hugging Face) ↗ huggingface.co
- [s5] Z.ai Developer Docs「GLM-5.3」「GLM-5.3-Flash/FlashX」「Pricing」 ↗ docs.z.ai
- [s6] Z.ai「GLM-5」モデルカード ↗ huggingface.co
- [s7] Unsloth「GLM-5.3 – How to Run Locally」 ↗ unsloth.ai
- [s8] Unsloth「GLM-5.3-Flash – How to Run Locally」 ↗ unsloth.ai
- [s9] Unsloth「GLM-5.3-GGUF」「GLM-5.3-Flash-GGUF」(Hugging Face) ↗ huggingface.co
- [s10] Ollama「glm-5.3」「gpt-oss」「qwen3.5」「qwen3.6」(ライブラリ) ↗ ollama.com
- [s11] Ollama「Cloud」(ドキュメント) ↗ docs.ollama.com
- [s12] OpenAI「gpt-oss-20b」モデルカード(Hugging Face。Apache 2.0、16GBのメモリで動く) ↗ huggingface.co
- [s13] Qwen「Qwen3.6-35B-A3B」モデルカード(Hugging Face。Apache 2.0) ↗ huggingface.co
- [s14] Apple「Mac Studio を購入」「Mac Studio 仕様」 ↗ apple.com
- [s15] Apple「Mac mini を購入」 ↗ apple.com
- [s16] NVIDIA「DGX Spark」(日本語の製品ページ) ↗ nvidia.com
- [s17] NVIDIA「GeForce RTX 5090」(日本語の製品ページ) ↗ nvidia.com
- [s18] NVIDIA「H200 Tensor Core GPU」 ↗ nvidia.com
- [s19] Artificial Analysis「LLM Leaderboard」「GLM-5.3 (Max)」「GLM-5.3-Flash」 ↗ artificialanalysis.ai
- [s20] 価格.com「GeForce RTX 5090」「RTX 5060 Ti 16GB」「DGX Spark」の最安価格 ↗ kakaku.com
- [s21] Runpod「Pricing」 ↗ runpod.io
- [s22] 欧州中央銀行「Euro foreign exchange reference rates」 ↗ ecb.europa.eu
検証ファクト一覧を表示する(全35項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | ローカルLLM=AIのモデル(重み)を自分のPC・社内のサーバーに置いて動かす。クラウドのAI(ChatGPT など)は、入力を会社のサーバーに送って答えを受け取る | [s2] [s7] | |
| F2 | 重みが公開されている(オープンウェイト)モデルは、ダウンロードして自分で動かせる。GLM-5.3 も Flash も重みが公開されている | [s2] [s4] [s19] | |
| F3 | ローカルでも、ダウンロード・Web 検索・外部の道具(MCP サーバーなど)を使えば通信は起きる。Ollama の「:cloud」のモデルはクラウドで動く(米国と欧州でホスト、ダウンロードしない) | [s10] [s11] | |
| F4 | GLM-5.3:中国の Z.ai が2026年8月14日に発表。GLM-5.2 と同じ土台(ベースモデル)で、追加の学習(事後学習)だけで強くした | [s1] [s2] | |
| F5 | 重みは安全の評価のため発表から2週間後に公開(Hugging Face のリポジトリは8月25日作成) | [s1] [s2] | |
| F6 | GLM-5.3 の総パラメータは約7,530億(Hugging Face)。1回に使うのは約400億(GLM-5 と同じ構造:専門家256のうち8つ+共通1つ) | [s2] [s6] [s7] [s19] | |
| F7 | 文字(テキスト)だけ。コンテキスト(読める量)100万トークン、出力は最大12.8万トークン | [s5] | |
| F8 | 会社の発表のテスト:DeepSWE v1.1(ソフト開発の課題)で GLM-5.2 46.2 → GLM-5.3 66.9。同じ表で GPT-5.6 Sol 72.7、Fable 5 69.7、Kimi K3 67.5、Claude Opus 4.8 58.0 | [s2] | 会社の発表・8月時点の相手 |
| F9 | 会社の発表:Terminal Bench 2.1 で GLM-5.3 88.2(GPT-5.6 Sol 88.8、Opus 4.8 85.0)、自社のテスト Z.ai Code Bench で GLM-5.2 から約50%改善 | [s1] [s2] | 会社の発表 |
| F10 | 第三者(Artificial Analysis)の指数(10月11日):Claude Opus 5.5(max)58、GPT-6 Astra(max)53、Gemini 4 Argon(high)53、GPT-6.1 Sol(max)52、GLM-5.3(max)45、Kimi K3(max)44、GLM-5.3-Flash 42。GLM-5.3 は「重みを公開しているモデルの中でトップクラス」、最新の非公開のモデルとは差がある | [s19] | |
| F11 | GLM-5.3-Flash:8月26日に発表。総3,200億・1回180億。新しく学習した土台で、画像も読める(GLM-5 シリーズで初めて)。GLM-5.2 を上回り、値段は約10分の1、と会社の発表 | [s3] [s4] | 会社の発表 |
| F12 | Flash は「まばら」と「線形」の注意のしくみを組み合わせ、GLM-5.3 とくらべて注意の計算を約3分の1、KVキャッシュを約4.4分の1に(会社の発表) | [s3] [s5] | |
| F13 | 会社の発表:Flash は DeepSWE v1.1 で 63.4(GLM-5.2 46.2、Opus 4.8 58.0) | [s3] | |
| F14 | ライセンス:GLM-5.3 は独自の「GLM-5.3 License」。使う・直す・売る・商用は広く認めるが、AIを API などで提供する事業(Model as a Service)で、グループの売上が12か月で100億ドルを超える会社は、Z.ai の安全審査に通る必要がある。Flash は MIT ライセンス | [s2] [s4] | |
| F15 | gpt-oss(OpenAI)・Qwen3.5・Qwen3.6 は Apache 2.0、GLM-4.7-Flash は MIT | [s12] [s13] | |
| F16 | 重さの目安=パラメータ数×1つあたりのビット数÷8(バイト)。FP8(1つ8ビット=1バイト)の GLM-5.3 の重みは合計約756GB、BF16(16ビット)は約1.51TB | [s2] [s9] | |
| F17 | GLM-5.3 の量子化ファイル(Unsloth):8ビット 801GB、4ビット 365〜467GB(IQ4_XS・Q4_K_XL)、3ビット 282〜343GB、2ビット 239〜254GB、1ビット 217〜229GB | [s9] | |
| F18 | 動かすのに必要なメモリ(RAM+VRAM の合計、Unsloth の目安):GLM-5.3 は1ビット 223GB、2ビット 245GB、4ビット 372〜475GB、8ビット 810GB。「ファイルより余裕をもって多く」 | [s7] | |
| F19 | GLM-5.3-Flash(Unsloth):ファイルは4ビット 157〜200GB、2ビット 109GB、1ビット 93GB、BF16 642GB。必要なメモリは1ビット 100GB、2ビット 115GB、3ビット 128〜150GB、4ビット 162〜210GB、8ビット 350GB | [s8] [s9] | |
| F20 | 量子化で中身が少し変わる:元のモデルがいちばんに選ぶ次の言葉と同じ言葉を選ぶ割合(top-1 の一致)は、GLM-5.3 の4ビット(Q4_K_XL)94.3%、3ビット(Q3_K_XL)88.9%、2ビット(IQ2_M)78.5%、1ビット(IQ1_S)72.6%(Unsloth の測定) | [s7] | |
| F21 | KVキャッシュ(会話の途中で覚えておくメモ)は、読む文章が長いほど増える。100万トークンを読めるのはモデルの仕様で、そのぶんのメモリが別に要る | [s3] [s7] | |
| F22 | 小さいモデルのファイル(Ollama、4ビット前後):Qwen3.5 9B 6.6GB、gpt-oss 20B 14GB、Qwen3.6 27B 17GB、GLM-4.7-Flash 19GB、Qwen3.6 35B-A3B 24GB、gpt-oss 120B 65GB | [s10] | |
| F23 | gpt-oss-20b は16GBのメモリで動くように作られ、gpt-oss-120b は80GBのGPU 1枚に入る(OpenAI) | [s12] | |
| F24 | Qwen3.6-35B-A3B は総350億・1回30億(専門家8つ+共通1つ) | [s13] | |
| F25 | Mac mini(M6)149,800円〜:メモリ16GB・SSD 256GB(メモリ帯域 153GB/s) | [s15] | |
| F26 | GeForce RTX 5090:GPU のメモリ32GB(GDDR7)。価格.com の最安 1,129,800円(10月11日、GPU 単体)。RTX 5060 Ti 16GB は 138,000円〜 | [s17] [s20] | |
| F27 | NVIDIA DGX Spark:128GB の統合メモリ、最大2,000億パラメータのモデルで推論(NVIDIA)。価格.com の検索で 1,133,000円〜 | [s16] [s20] | |
| F28 | Mac Studio(M5 Ultra)949,800円〜(96GB・1TB、メモリ帯域 1.2TB/s)。256GB にするには上位のチップ(1,183,800円)+720,000円=1,903,800円。512GB は10月下旬に発売(値段はまだ) | [s14] | |
| F29 | NVIDIA H200:1枚に141GB(HBM3e、4.8TB/s)。8枚で1,128GB | [s18] | |
| F30 | GPU を借りる(Runpod、10月11日):H200 1枚 $4.31〜$5.29/時。8枚なら単純に $34〜$42/時(約5,500〜6,700円/時)。借りたGPUにはデータを送るので「自分の手元」ではない | [s21] [s22] | |
| F31 | 重さが入るかどうかと、速く答えられるかは別。速さはメモリの帯域・GPU の計算・実行するソフトで変わる(本記事では速さを測っていない) | [s7] [s14] | |
| F32 | Z.ai の API:GLM-5.3 は100万トークンあたり入力 $1.40・出力 $4.40。GLM-5.3-Flash は入力 $0.15・出力 $0.50 | [s5] [s19] | |
| F33 | 試算:1か月に入力1,000万・出力200万トークンなら、Flash 約$2.50(約400円)、GLM-5.3 約$22.80(約3,600円)。キャッシュの割引・税を除く | [s5] [s22] | 試算 |
| F34 | Ollama で `ollama run gpt-oss:20b` のように打つと、ダウンロードして手元で動く。`glm-5.3:cloud` はクラウドで動く | [s10] [s11] | |
| F35 | Ollama は Claude Code・OpenCode などのコーディングエージェントからモデルを使う起動方法(`ollama launch`)を用意している | [s10] [s11] |
※ GLM-5.3・GLM-5.3-Flash の仕様とテストの点数は、Z.ai の発表(ブログ・モデルカード、2026年8月)です。比べた相手(Claude Opus 4.8・GPT-5.6 など)は8月時点のモデルです。第三者の指数は Artificial Analysis(2026年10月11日閲覧)の値です。
※ ファイルの大きさは Hugging Face の公開ファイル(GLM-5.3 の FP8 版・Unsloth の量子化版)の合計、必要なメモリと「元のモデルと同じ言葉を選ぶ割合」は Unsloth のガイドの値です(2026年10月11日閲覧)。「何が動く?」の表(○×とビット数)は重さと必要なメモリの目安からの判断で、実際に動かして速さを測ったものではありません。
※ マシンの値段は2026年10月11日時点の、Apple の購入ページ(税込)、価格.com の最安価格、Runpod の料金ページの値です。値段は日々変わります。円は1ドル≒158円(欧州中央銀行の参照レート、10月9日)で換算しました。
※ APIの月額(入力1,000万・出力200万トークン)は Z.ai の料金表をもとにした試算で、キャッシュの割引・税は含みません。「約44年分」は Mac Studio(256GB)の価格を GLM-5.3 の試算の月額で割ったものです。
※ 記事中のお店の例(レシピ・顧客名簿・OSとアプリの約10GB)はイメージです。
※ ロボットや機械のイラストはイメージで、Z.ai・Apple・NVIDIA などの製品やロゴとは関係ありません。