ChatGPTのInstant・Medium・High、CodexやClaude Codeの思考レベル(Reasoning Effort)は、全部いちばん上にすれば賢くなるのでしょうか。本記事では、OpenAI・Anthropic・Googleの公式ドキュメントとChatGPTのヘルプで、思考レベルの意味と各社の名前の違いを確かめます。
あわせて、CodexでGPT-5.6 Solの思考レベルをロー〜マックスに変えて約280回測りました。簡単〜ふつうの課題では正解は同じで、高いほど時間とトークンが増えたこと、ハイにしても考えない回があったこと、「順を追って計算して」と頼むだけで正解が増えたことを紹介します。自作の問題・少ない回数・1つのモデルの結果です。考えすぎを指摘する公式の説明と論文、使い分けの順番までまとめました。
情報は2026年10月24日時点のものです。料金・提供範囲・数値は変わることがあります。出典は記事末尾にまとめています。
- 思考レベルは、考える量の目安
- 実測では、やさしめの課題で正解は同じ
- まず標準。間違えたら頼み方、それから上げる
全部いちばん上にしたら?
誤字ひとつに、全力で考えさせるつもり?
担当者の設定:いちばん上(※イメージ)
※やりとりはイメージです
誤字ひとつなら、すぐ終わるはずです。
思考レベル:Reasoning Effort(エフォート)
Reasoning Effort(エフォート)
そもそも、AIは長く考えるほど、本当に賢くなるのでしょうか。[s1] 決めつけは禁物です。公式の説明と研究を読んで、自分でも測ってみましょう。
今日わかること
- 思考レベルって、何を決める設定?
- ChatGPT・Codex・Claude・Geminiの名前
- 思考レベルを変えて、約280回測った
- 考えすぎは、本当にあるの?
- 結局、どう選べばいい?
本稿では、この5つを確かめます。 意味、各社の名前、実測、考えすぎ、そして選び方です。
思考レベルってなに?
まず、正体から、試験の机を思い浮かべてください。 問題を見て、すぐ答える人もいれば、下書きをたくさん書いてから答える人もいます。
AIが答えるまで
AIが答えるまで
AIも、答えを出す前に、見えない下書きを書いています。[s1]
思考トークン:答えの前の見えない下書き
答えの前の見えない下書き
この下書きを「思考トークン」と呼びます。[s1]
その下書きを、どれくらい書いていいかを決める設定が、思考レベルです。[s1]
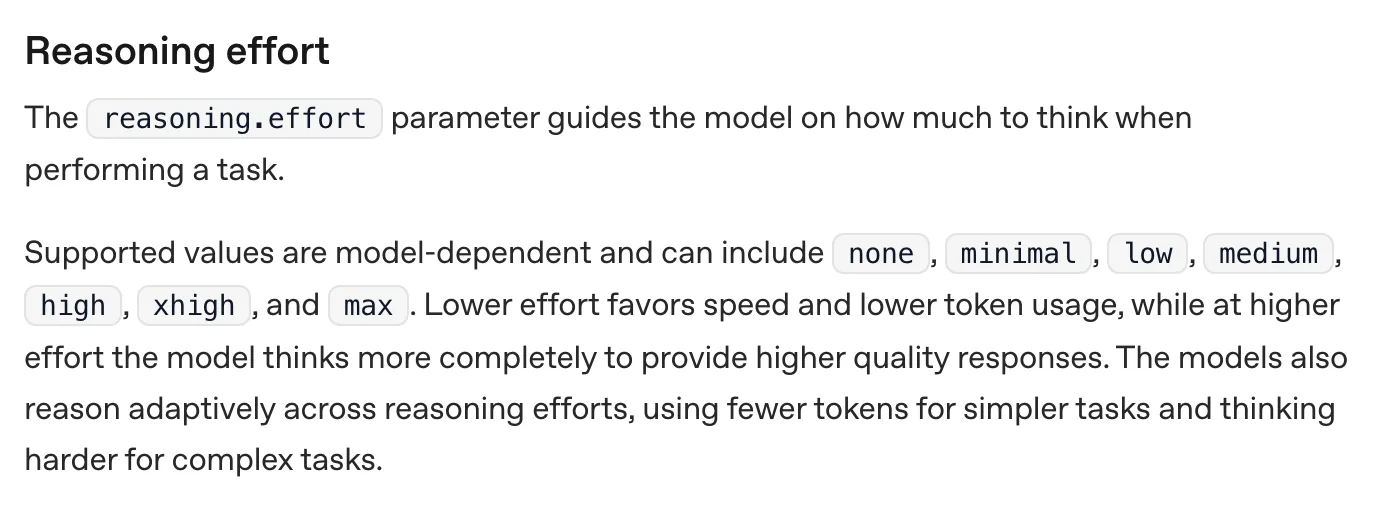
- どのくらい考えるかを導く
- 簡単なら少なく、難しければ多く
OpenAIの説明では「どのくらい考えるかを導く設定」です。[s1]
導く? 決めるんじゃない?
きっちりした上限ではなく、目安です。[s1] Anthropicも、同じ言い方をしています。[s5]
低いレベル と 高いレベル
低いレベル と 高いレベル
低い(ロー)
- すぐ答える
- 速い・トークンが少ない
高い(ハイ)
- じっくり考える
- 遅い・トークンが多い
低いレベルと、高いレベルを並べてみましょう。[s1] 低いほど速くてトークンが少なく、高いほど、じっくり考えます。[s1]
高くすると、増えるもの
高くすると、増えるもの
待ち時間
じっくり考える分
トークン
下書きも数える
料金(API)
出力と同じ単価
下書きも、APIでは出力と同じ料金で数えられます。だから、高いほどお金もかかります。[s1]
高いほど、必ず賢くなる?
それが今日の問いです。ただ、AIは自分でも量を調整しています。
レベルは目安
各社の名前はバラバラ
いいところに気づきました。順に見ていきます。
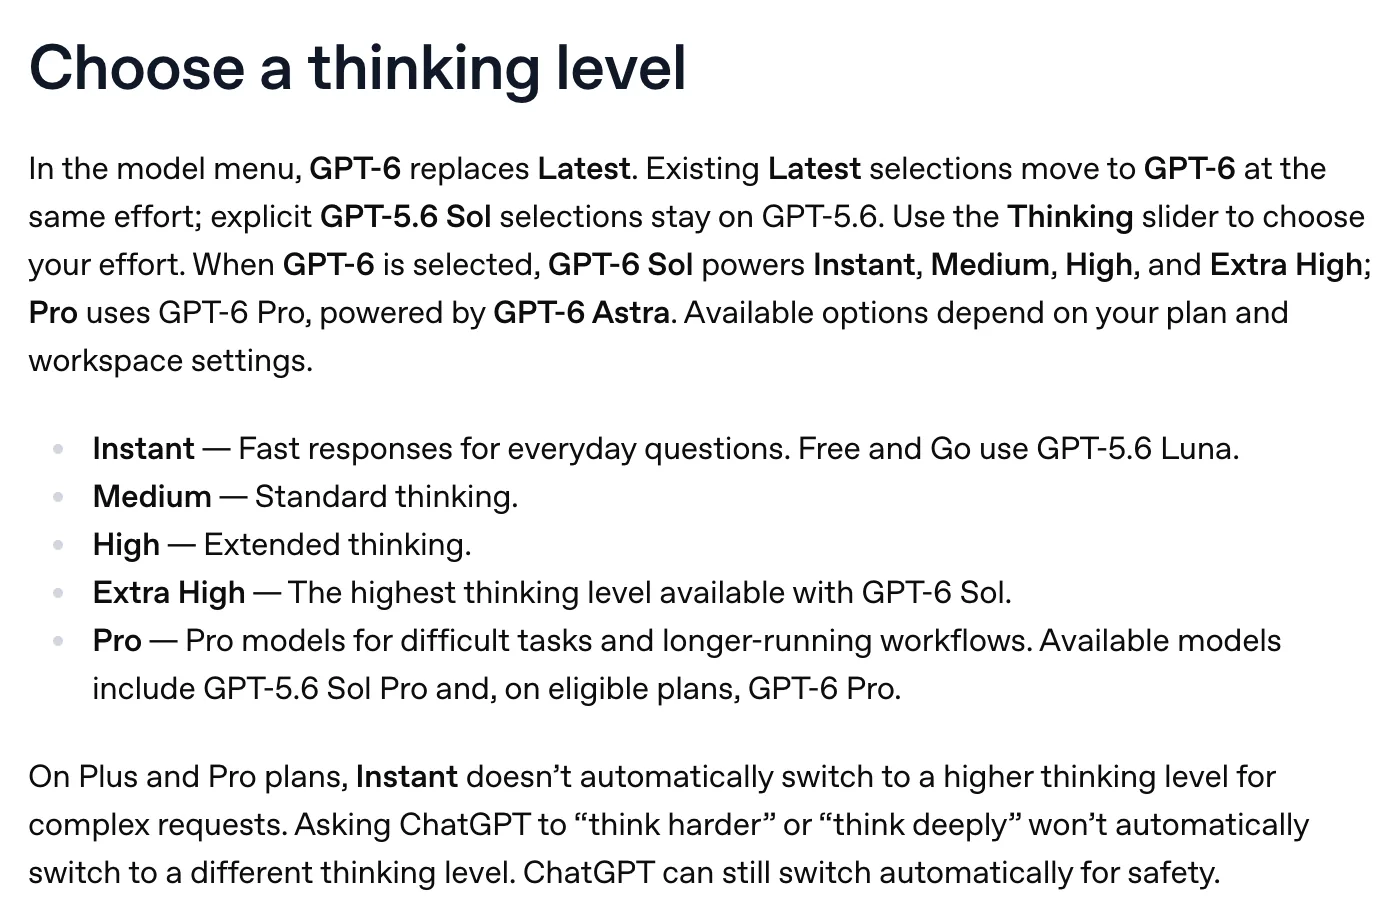
- スライダーの段階
- 頼んでも自動では上がらない
まずChatGPT。スライダーは、インスタント、ミディアム、ハイ、エクストラハイです。[s3] プロは別枠の、大きなモデル用です。Plusは、ミディアムとハイまでです。[s3] ここに大事な一文があります。インスタントのときの話です。[s3] 「もっと深く考えて」と頼んでも、レベルは自動では上がりません。[s3]
お願いしても、だめ?
上げたいときは、自分でスライダーを動かします。
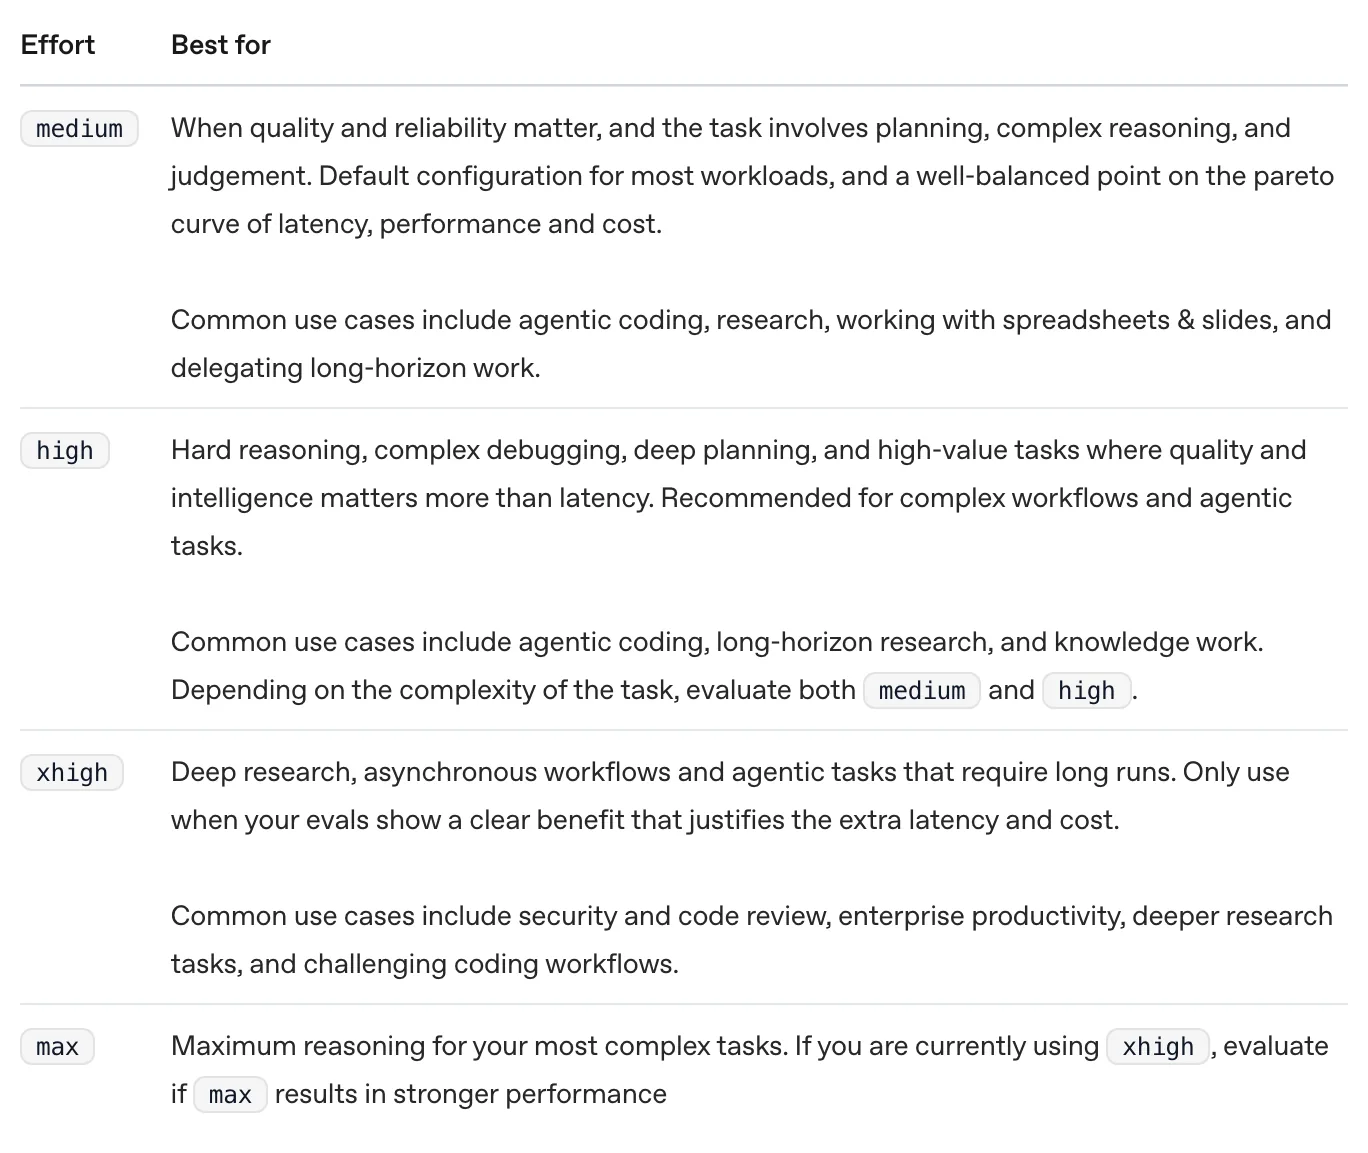
- 標準は ミディアム
- 評価で効果が出たときだけ
次はAPIとCodex。ノンからマックスまで、7段階あります。[s1] ただし、使える段階は、モデルによって違います。[s1] 標準は、ミディアム。OpenAIは「まず標準から」と書いています。[s1] エックスハイは、「評価で、はっきり効果が出たときだけ」と書いてあります。[s1]
Codexの思考レベル
Codexの思考レベル
画面
ライト〜ウルトラ
設定ファイル
思考レベルを指定できる
OpenAIの勧め
まず標準、必要なら上げる
Codexの画面は、ライトからウルトラまで。設定ファイルでは、ライトはローと書きます。[s4]
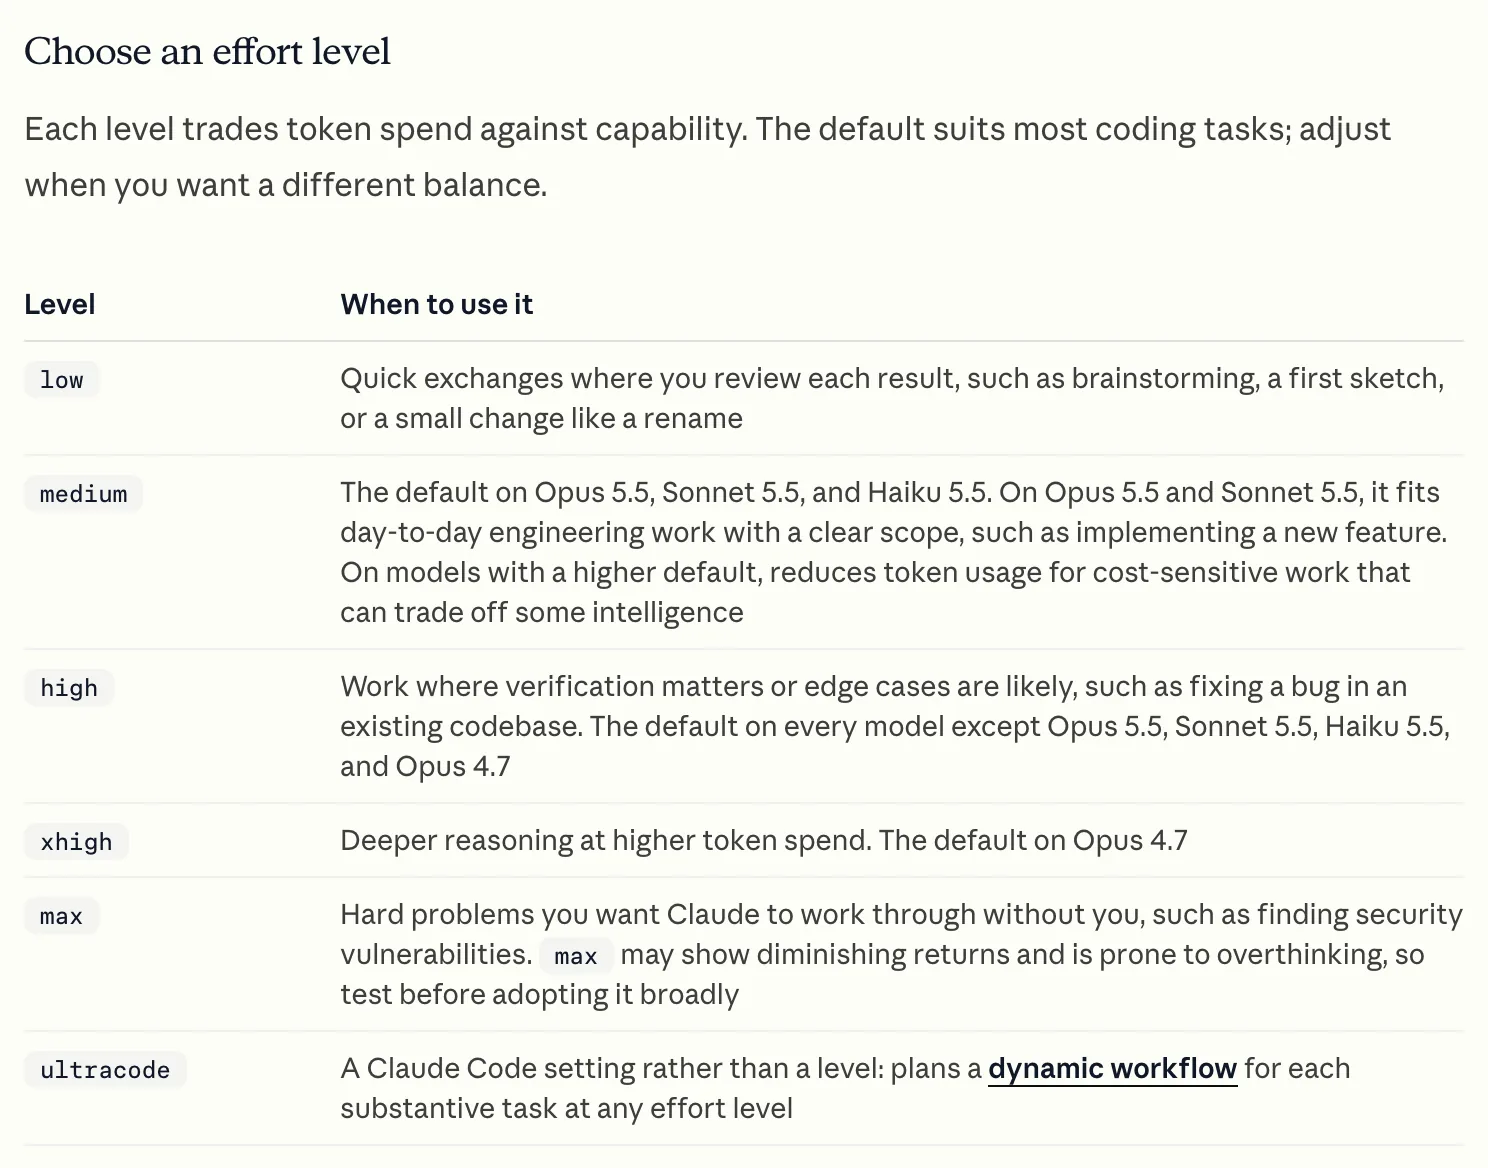
- 5.5シリーズの標準はミディアム
- ほかのモデルはハイ
Claudeは、ローからマックスまでの5段階です。[s5][s7] 標準は、ほとんどのモデルでハイ。でも、オーパス5.5などは、ミディアムです。[s5][s7]
- 標準はミディアム
- ロー・ミディアム・ハイ
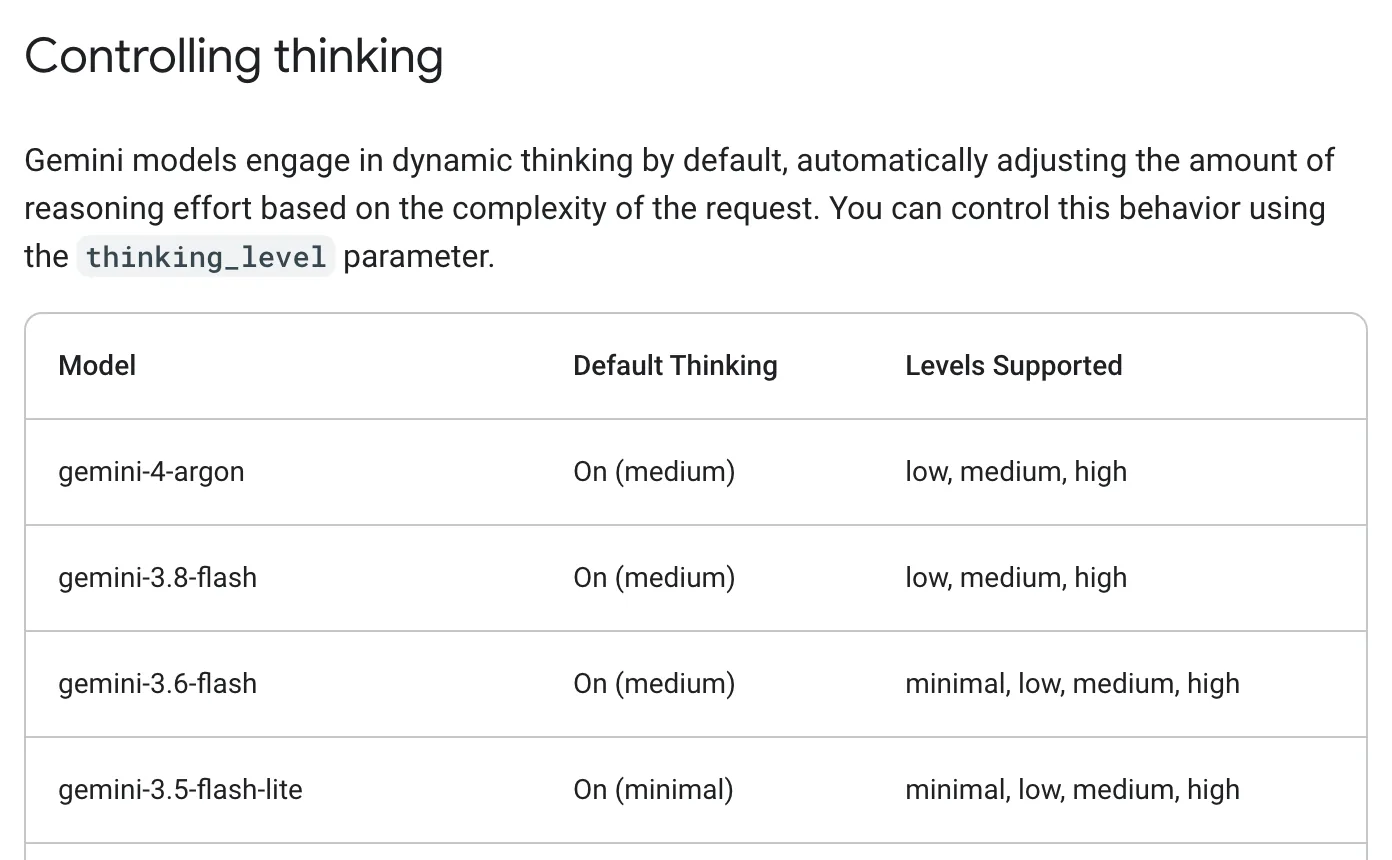
最後にGemini。thinking_levelという設定です。[s8] Gemini 4 Argonは、標準がミディアムで、ローからハイまで選べます。[s8]
思考レベルの名前(2026年10月)
思考レベルの名前(2026年10月)
OpenAI・Anthropic・Google の公式ドキュメントと ChatGPT のヘルプをもとに整理
4つを並べてみます。[s1][s3][s5][s8] 名前も、段の数も、標準も、バラバラでしょう。[s1][s3][s5][s8]
同じ名前でも、同じ深さではない
しかも、同じ「ハイ」でも、同じ深さとは限りません。[s4][s6][s7] OpenAIも、Anthropicも、そう書いています。[s4][s6][s7]
思考レベルを約280回測った
実験のやり方
実験のやり方
ツールなし・答えだけ
ロー〜マックスの5つ
正解かどうか自動で
Codexの記録から
同じ問題を、思考レベル5つで解かせます。 使うのは、Codexの、GPT-5.6 Solです。 毎回あたらしい会話で、全部で約280回。採点も、プログラムがしました。
自作のテスト
ただし、自分で作った問題で、回数も少なく、モデルも1つ。公式の評価ではありません。
最初の4種類の問題
最初の4種類の問題
要約
60字以内で
バグ修正
関数を直す
論理パズル
席順を当てる
計算パズル
最安を探す
問題は、まず4種類。要約、バグ修正、論理パズル、計算パズルです。
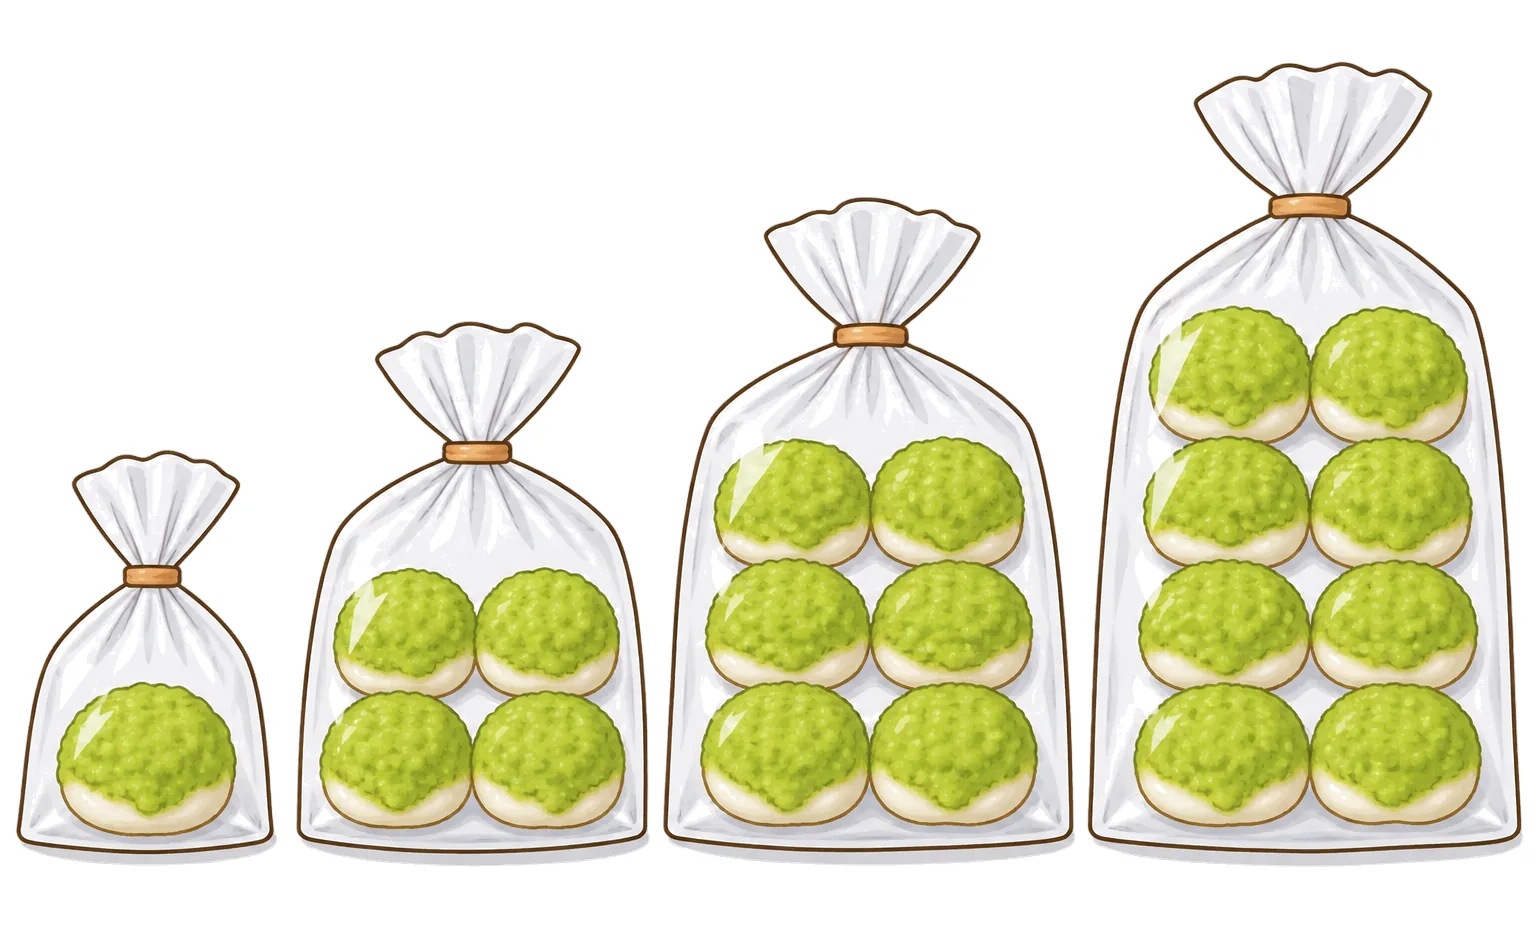
計算パズルは、抹茶大福の袋の組み合わせで、いちばん安い買い方を探す問題です。
実験で出した問題の1つ
※実験で使った問題の1つ
1個35円、4個115円、6個150円、8個215円の袋があります。 ちょうど38個を、いちばん安く買うと、いくら?
同じ38個の買い方
同じ38個の買い方
お得な袋から順に
- 970円
- 5円高い
最安の組み合わせ
- 965円
- 正解
それだと970円。最安は965円で、5円ちがいます。
正解した数(4種類・各レベル22回)
正解した数(4種類・各レベル22回)
実測(Codex・GPT-5.6 Sol・自作の問題)
4種類の問題を、レベルごとに解かせた結果がこれです。
全部同じ?
やさしめの問題だと、低くても、高くても、正解は同じでした。
バグ修正の思考トークン(ローとミディアム)
バグ修正の思考トークン(ローとミディアム)
バグ修正は、ローとミディアムでは、考えた量が0トークンでした。
計算パズル 出力トークンの平均(各10回)
計算パズル 出力トークンの平均(各10回)
実測(Codex・GPT-5.6 Sol・自作の問題)。思考の下書きも含む
ほかの数字を見ましょう。計算パズルの、トークンの平均です。 ローは242、マックスは411。約1.7倍です。
計算パズル 答えるまでの時間(中央値)
計算パズル 答えるまでの時間(中央値)
実測(Codex・GPT-5.6 Sol・自作の問題)。Codexの起動の約3秒を含む
答えるまでの時間も、中央値で7.2秒から10.5秒になりました。 もっと難しくしましょう。6種類の袋で、100個以上買う問題を6問です。
むずかしい計算 正解した数(各レベル18回)
むずかしい計算 正解した数(各レベル18回)
実測(マックスは未実施)
結果を見る前に作った問題で、あとから選んでいません。
18回と16回
18回と16回の差は、たった2回です。偶然の範囲です。 間違えた5回のうち4回は、お得な順に買う、ひっかけの答えでした。
むずかしい計算 トークンの平均
むずかしい計算 トークンの平均
トークンも、515から671まで増えたけど、正解は増えませんでした。 でも、いちばん面白い結果は、ここからです。
最初に試した質問
※実験で使った質問
最初に、こんな質問で試しました。答えだけを1行で、とお願いしました。
17個の最安
17個の最安
正解は460円。80円のセット5つと、30円の1個が2つです。
正解した数(12回中・答えだけを1行で)
正解した数(12回中・答えだけを1行で)
実測(Codex・GPT-5.6 Sol・自作の質問)
これを12回ずつ、レベルを変えて聞きました。
ハイにしても、まちがえた?
思考トークンの数(12回ずつ)
思考トークンの数(12回ずつ)
もっと変なのは、考えた量です。ロー、ハイ、エックスハイは、ずっと0トークンでした。
ハイにしたのに、考えなかった?
考えるかどうかは、AIが問題を見て決めます。[s1][s8] 簡単そうに見えると、ハイでもすぐ答えます。[s1][s8]
マックスは考えたから、9回正解?
マックスが考えた回数
マックスが考えた回数
マックスが考えたのは、12回のうち2回だけです。 それだけでは9回を説明できない。偶然かもしれません。
頼み方を変えた質問
※答えの書き方はイメージ
そこで、頼み方を変えました。「順を追って計算してから、最後の行に合計を書いて」です。
正解した数(12回中・順を追って計算して)
正解した数(12回中・順を追って計算して)
実測(Codex・GPT-5.6 Sol・自作の質問)。思考トークンは約70に増えた
すると、ローもハイも、12回中12回、正解しました。 このテストでは、思考レベルより、どう頼むかのほうが効いました。
この実測でわかったこと・わからないこと
この実測でわかったこと・わからないこと
わかった
やさしめの課題は、正解が同じ
わかった
高いほど、遅くてトークンが多い
わからない
長い作業や、本当に難しい問題
もちろん、一般には言い切れません。わかったこと、わからないことを整理します。
考えすぎは本当にある?
考えすぎは、本当にある?
- マックスは考えすぎしやすい
公式にも、研究にも、それらしい話があります。まず、Claude Codeの公式です。[s7] 「マックスは効果が小さくなりやすく、考えすぎしやすい。広く使う前に試して」とあります。[s7]
AnthropicのFable 5.1の説明には、具体的な例もあります。[s6]
長い文書を書かせると
長い文書を書かせると
長い文書を書かせると、エックスハイやマックスは。[s6] 考えの中で一度書いて、返事でもう一度書くことがあります。[s6] そうなると、時間とトークンが倍になるのに、結果はよくなりません。[s6]
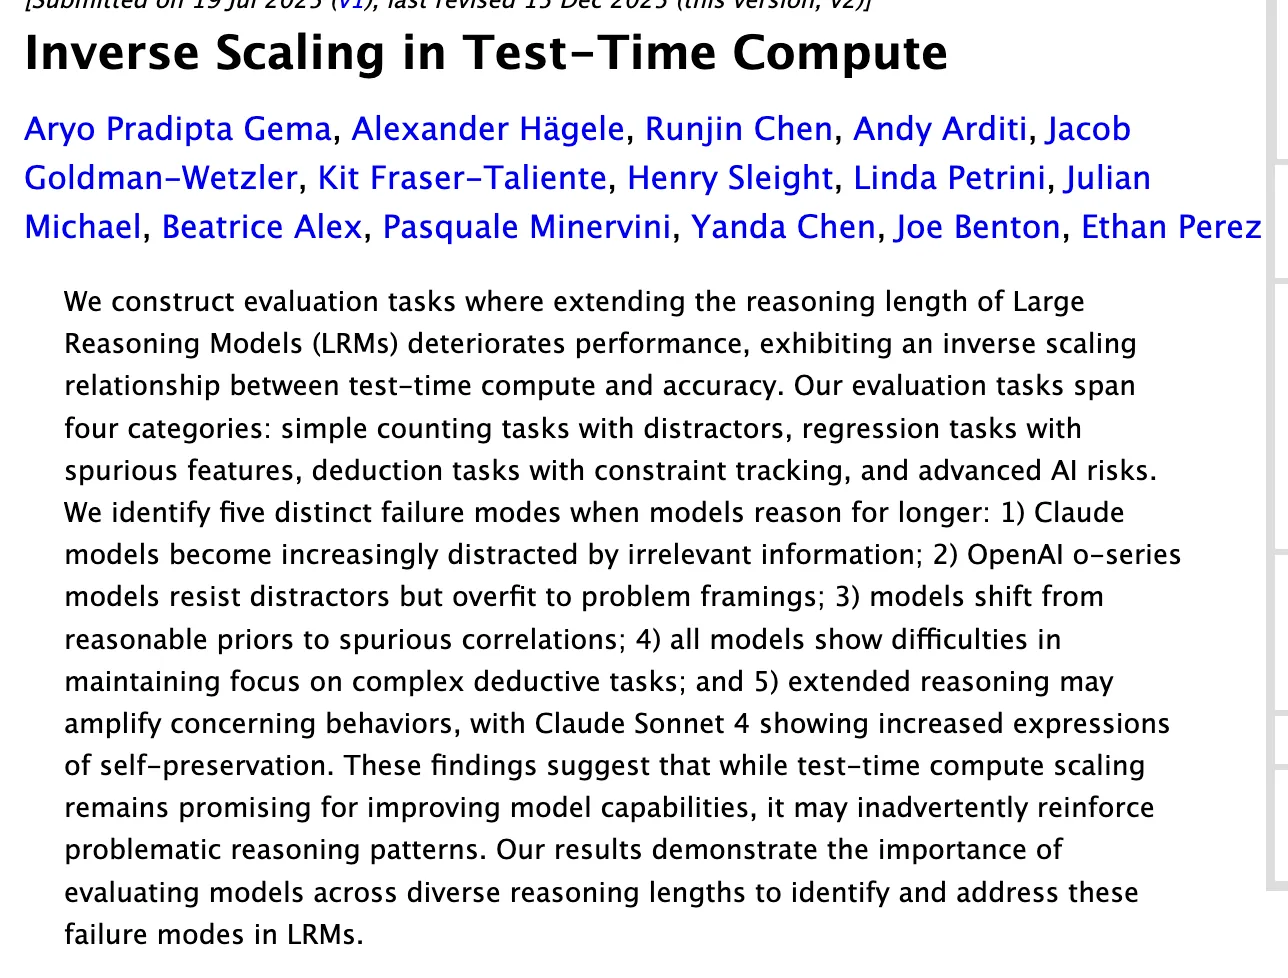
- 考えを長くすると 正解率が下がる課題
研究もあります。2025年の論文です。[s9] 考える時間を長くすると、正解率が下がる課題を作りました。[s9]
長く考えて悪くなる例(論文)
長く考えて悪くなる例(論文)
気が散る
関係ない情報に引っぱられる
言い方に合わせすぎ
問題の書き方に引っぱられる
見かけの相関
それらしい関係に傾く
原因は5つ。たとえば、関係ない情報に気を取られます。[s9] 問題の言い方に合わせすぎる、ということもあります。[s9]
一般の質問で、必ず悪くなる話ではない
ただし、これは、わざと難しく作った課題の結果です。いつも悪くなるという話ではありません。[s9]
考えすぎについて
考えすぎについて
ある
公式も論文も指摘
いつもではない
課題やモデルしだい
だから測る
自分の仕事で
だから、自分の仕事で測るのが、いちばん確かなのです。
結局、どう選ぶ?
結局どう選べばいい?
思考レベルの選び方
思考レベルの選び方
ミディアムかハイ。モデルの標準
順に計算して、条件も書く
効果が出たときだけ上げる
順番は、3つです。 1つめ。まず標準から、公式はどこも、そう書いています。[s1][s4][s5] 2つめ。間違えたら、いきなり上げずに、頼み方を直します。 条件を全部書く。「順を追って計算して」と頼む。それでもだめなら、一段上げます。
インスタントは、自分でスライダーを動かしてください。[s3] 3つめ。自分の仕事で測ります。 OpenAIも、効果が出たときだけ、エックスハイと言っています。[s1]
思考レベルの目安(OpenAIの説明)
思考レベルの目安(OpenAIの説明)
ロー
下書き・問い合わせ
ミディアム
計画・判断が要る仕事
ハイ
難しい推論・複雑なデバッグ
エックスハイ〜
長い調査・レビュー
目安も、OpenAIの表から、まとめておきます。[s1]
使い分けの例(OpenAIの目安をもとに)
使い分けの例(OpenAIの目安をもとに)
ChatGPTで文章
下書きは低め
Codexでバグ修正
標準で。難しいバグだけハイ
長く動く仕事
エックスハイは測ってから
たとえば、ChatGPTで文章を書くとき。[s1] 下書きは、ローが向いているとOpenAIは書きます。[s1] Codexでバグを直すときは、まず標準で、どうしても直らない難しいバグだけ、ハイにします。[s1][s4]
何時間も動く仕事は、エックスハイを試して、効果があるかを測ってください。[s1]
お店のお知らせの誤字直しは、どれ?
標準のままで、十分なはずです。浮いた時間と使える量は、難しい仕事に回しましょう。 それと、モデルを替えたら、いつもの作業で、試し直してください。[s4][s6]
まとめ
今日のまとめ
- 思考レベルは、考える量の目安
- 実測では、やさしめの課題で正解は同じ
- まず標準。間違えたら頼み方、それから上げる
思考レベルは、考える量の目安。高いほど遅くて、トークンも増えます。[s1] 実測では、やさしめの課題で、正解は同じ。考えるかどうかは、AIが決めていました。 まず標準から、間違えたら、頼み方を直して、それから一段上げる。自分の仕事で測ってください。
実践のポイント・まとめ
出典・参考文献
- [s1] OpenAI API ドキュメント「Reasoning models」(reasoning.effort の節) ↗ developers.openai.com
- [s2] OpenAI API ドキュメント「GPT-5.6 Sol」(モデルページ・料金) ↗ developers.openai.com
- [s3] OpenAI ヘルプセンター「GPT-6 and other models in ChatGPT」 ↗ help.openai.com
- [s4] OpenAI Codex ドキュメント「Models」(Pick a reasoning effort) ↗ developers.openai.com
- [s5] Anthropic「Effort」(Claude API) ↗ platform.claude.com
- [s6] Anthropic「Prompting Claude Fable 5.1」(Consider all effort levels) ↗ platform.claude.com
- [s7] Claude Code ドキュメント「Model configuration」(Adjust effort level) ↗ code.claude.com
- [s8] Google「Gemini thinking」(thinking_level) ↗ ai.google.dev
- [s9] Gema ほか「Inverse Scaling in Test-Time Compute」(arXiv 2507.14417、TMLR 2025・ICLR 2026) ↗ arxiv.org
検証ファクト一覧を表示する(全23項目)
| ID | 確認した事実・仕様 | 出典 | 注意・補足 |
|---|---|---|---|
| F1 | `reasoning.effort` は「どのくらい考えて作業するか」を導く設定。**低いほど速く・トークンが少なく、高いほど丁寧に考える**。モデルは**簡単な課題では少なく、難しい課題では多く**考える(レベルが同じでも) | [s1] | 「導く」=厳密な上限ではない(s5 も「行動の目安であって厳密な予算ではない」) |
| F2 | 値は **none・minimal・low・medium・high・xhigh・max**(**モデルによって使える範囲がちがう**)。GPT-5.5 は medium が既定。GPT-5.6 と GPT-6.1 Sol・GPT-6 Sol・GPT-6 Luna も medium が既定 | [s1] | |
| F3 | s1 の使い分けの目安:**low**=データ分析・下書き・実行中心のコード・問い合わせ対応など効率よく/**medium**=計画・複雑な推論・判断が要る仕事の既定/**high**=難しい推論・複雑なデバッグ・深い計画で、品質が速さより大事なとき/**xhigh**=長く動かす調査・レビューで、**評価で明らかな効果が出たときだけ**/**max**=いちばん難しい仕事。xhigh を使っているなら max が強いか評価 | [s1] | high の説明は「medium と high の両方を評価して」 |
| F4 | 高い effort は**待ち時間とトークンが増える**。OpenAI は「評価で明らかな効果が出るときだけ xhigh」と書く | [s1] | |
| F5 | **GPT-5.6 と GPT-6 には `reasoning.mode`(standard/pro)もある**。effort とは独立。難しい仕事で pro | [s1] | |
| F6 | **ChatGPT**:思考のスライダー(Thinking)は **Instant/Medium/High/Extra High**、**Pro** は別枠。Medium=標準の思考、High=長い思考、Extra High=GPT-6 Sol でいちばん長く考える。**Plus は Medium と High まで**、Extra High と Pro は Pro・Business・Enterprise。Free・Go は GPT-5.6 Luna(Instant か Think) | [s3] | プランの条件は変わる |
| F7 | ChatGPT の Plus・Pro では、**Instant は複雑な質問でも自動では上のレベルに切り替わらず、「もっと考えて」と頼んでも切り替わらない**(安全のための自動切り替えは別) | [s3] | |
| F8 | **Codex**:画面では Light〜Ultra(Max と Ultra は設定しだい)。**Light(アプリ・IDE)/Low(CLI)**は小さく決まった作業、**Medium** は計画が要る作業、**High・Extra High** は手順・資料・トレードオフが多い難しい作業、**Max** は最難関で深さが速さより大事なとき、**Ultra** はサブエージェントに分けて並列(ほとんどの作業に不要)。「**まず既定、必要なら上げる**」「世代でレベルは対応しない。慣れた作業を低めで試して調整」 | [s4] | |
| F9 | **Claude の `effort`**:low・medium・high・xhigh・max の5段階(`output_config.effort`)。**テキスト・ツール呼び出し・思考の全部のトークンに効く**(思考なしでも使える) | [s5] | |
| F10 | Claude の既定は**ほとんどのモデルで high**。**Opus 5.5 と Haiku 5.5 は medium**。Sonnet 5.5 は API では high(Claude Code では medium) | [s5] [s7] | |
| F11 | s5:**low**=「もっとも効率的。能力は少し下がる」、サブエージェントなど。**max**=「制限なしの最大の力」。**effort は厳密な予算ではなく行動の目安**。低くても難しい問題では考える | [s5] | |
| F12 | s6(Fable 5.1):**まず既定の high、ほかのレベルを自分の評価で試す**。「**レベルの名前は、モデルがちがうと同じ量の思考に対応しない**」。medium は Fable 5 と同等で安い、low は Opus・Sonnet と同じコスト帯で高得点のことも。**xhigh・max は長い成果物を、思考の中で一度書いてから返答でもう一度書き、時間とトークンが倍になることがある** | [s6] | |
| F13 | s7(Claude Code):**low**=小さな変更・ブレスト、**medium**=範囲が決まった日常の開発、**high**=検証や境界の場合が大事なバグ修正、**max**=セキュリティ脆弱性探しなど「放っておく」難問。**max は「効果が小さくなりやすく、考えすぎ(overthinking)しやすい。広く使う前に試して」**。高いレベルは境界の場合を多く試し、結果をよく確かめた。低いレベルは最初の叩き台が早く、1つ1つ確認しながら進める作業に合う。**目盛りはモデルごとに調整され、同じ名前でも中身がちがう** | [s7] | |
| F14 | **Gemini の `thinking_level`**:minimal・low・medium・high(モデルによる)。**既定でも課題に応じて動的に考える**。Gemini 4 Argon・3.8 Flash は medium が既定で low・medium・high。3.1 Pro は high が既定。**簡単な課題は minimal か low、中くらいは既定、複雑は最大**(公式のよい使い方)。**上限(max_output_tokens)で切ると思考の途中で止まって空になる。費用や速度を下げるなら thinking_level を下げる** | [s8] | |
| F15 | **3社を並べると**:OpenAI(API)none〜max/ChatGPT Instant〜Extra High/Claude low〜max/Gemini minimal〜high。**名前も段数も既定もちがうので、同じ名前を同じ深さと思わない** | [s1] [s3] [s5] [s8] | |
| F16 | 論文「Inverse Scaling in Test-Time Compute」(2025年7月、arXiv。TMLR 2025年12月・ICLR 2026):**推論を長くすると正解率が下がる課題**を作り、4種類(①気を散らす情報つきの数え上げ ②見かけの相関がある回帰 ③制約の追跡が要る推論 ④AIの安全性に関する評価)で確かめた。**原因は5つ**(Claude は無関係な情報に気を取られる/OpenAI の o シリーズは気を散らす情報には強いが問題の言い回しに合わせすぎる/もっともらしい事前の見方から見かけの相関に傾く/複雑な推論で集中が続かない/長い推論が気になる振る舞いを強める) | [s9] | 筆頭 Gema(Anthropic Fellows Program の研究者を含む。Anthropic の公式発表ではない)。**「一般の質問で長く考えると必ず悪くなる」とは言っていない**。LessWrong に「分からない問題ほど長く考えるので、長さが原因でなく結果かも」という指摘がある |
| F17 | s6:Fable 5.1 は xhigh・max で**長い文書を思考で一度書き、返答でもう一度書くことがある** → 時間とトークンが倍になるのに結果は良くならない | [s6] | |
| F18 | s7:「max は効果が小さくなりやすく、考えすぎしやすい」 | [s7] | |
| F19 | s1:OpenAI は「xhigh は評価で明らかな効果が出るときだけ」。s5(Opus 5.5 の項)は「自分の評価でレベルをふり直して、前のモデルの設定を持ち越さない」 | [s1] [s5] | |
| F20 | 要約(お知らせを60字以内に・3回)、バグ修正(月を足す関数 `add_months`・12個のテストで採点・3回)、論理パズル(7人の席順・2問×3回)、計算パズル(袋の組み合わせの最安・5問×2回)。**5つのレベルすべてで全問正解(各22/22)** | — | |
| F21 | 計算パズル(10回ずつ):**出力トークンの平均 low 242・medium 353・high 320・xhigh 408・max 411**(low→max で約1.7倍)、**答えるまでの時間の中央値 7.2・8.1・8.4・9.7・10.5秒**。正解は10/10で同じ | — | |
| F22 | A 全体(各22回):出力トークン平均 low 230・medium 293・high 289・xhigh 323・max 348、時間の中央値 6.5・7.2・7.2・7.4・8.0秒 | — | |
| F26 | 最初の1回だけの試し(17個→「450円」・low・思考0トークン)は、あとで12回くり返すと 7/12 で間違い。**1回の結果で決めない** | — |
※ 思考レベルの説明・名前・標準の値は、2026年10月24日時点の OpenAI・Anthropic・Google の公式ドキュメントと ChatGPT のヘルプにもとづきます。モデルや契約プランで使える範囲は変わります。
※ 実測は、2026年10月24日に Codex CLI(ChatGPT アカウントの認証・GPT-5.6 Sol)で思考レベルを low〜max に変え、ツールなしで答えだけを出させてプログラムで採点した、自作の問題・少ない回数(各条件3〜18回)の結果です。公式の評価ではなく、ほかのモデル・課題では結果が変わることがあります。答えるまでの時間には Codex の起動の約3秒が含まれます。GPT-6 系はこのアカウントの Codex では使えませんでした。
※ xhigh・max が役に立つ長い作業や本当に難しい問題は、この実測では確かめていません。
※ 作中の「和菓子ECショップ」のお知らせの誤字直しのやりとりはイメージです。抹茶大福の袋の問題と数字は、実測で使った問題です。
※ 画面の表や文章は、OpenAI・Anthropic(Claude Code)・Google・arXiv の公式の資料の引用で、加工していません。論文は Anthropic Fellows Program の研究者を含む共著で、Anthropic の公式発表ではありません。